
Wywiady
Gil Elbaz, współzałożyciel i CTO Datagen – seria wywiadów

 Dodaj Unite.AI do preferowanych źródeł w Google
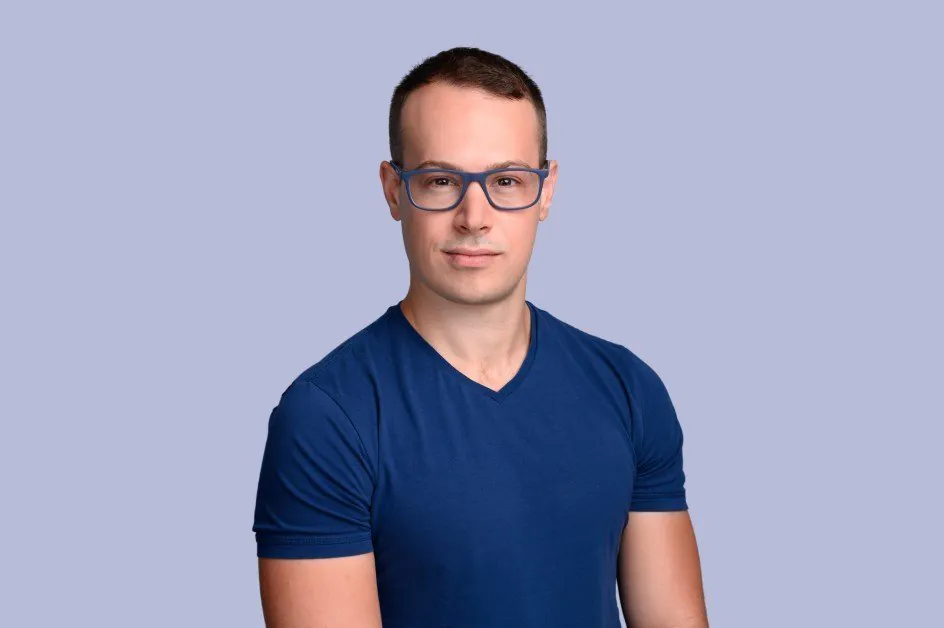
Gil Elbaz jest CTO i współzałożycielem Datagen, z siedzibą w Tel Awiwie. Ukończył studia licencjackie i magisterskie na Uniwersytecie Technion. Praca magisterska Gila dotyczyła komputerowego widzenia 3D i została opublikowana na konferencji CVPR, najważniejszej konferencji badawczej w dziedzinie komputerowego widzenia na świecie. Datagen jest pionierem w nowej dziedzinie danych symulowanych, podzbiorze danych syntetycznych, który koncentruje się na fotorealistycznej rekonstrukcji świata wokół nas. Firma wyszła ze stealth mode z ponad 18 milionami dolarów finansowania w marcu 2021 roku i obecnie współpracuje z wieloma firmami z listy Fortune 100 w dziedzinie rzeczywistości rozszerzonej i wirtualnej, robotyki i motoryzacji, w tym z większością czołowych amerykańskich gigantów technologicznych.
Czym było to, co początkowo przyciągnęło Cię do robotyki i uczenia maszynowego?
Książki science fiction, takie jak seria Fundacja Isaaca Asimova i iRobot, zawsze sprawiały, że myślałem o przyszłości, w której roboty będą integralną częścią naszego codziennego życia. Jest tak wiele nudnych, powtarzalnych zadań, które wykonują ludzie; wiedziałem, że nie chcę ich wykonywać, i nie mogłem sobie wyobrazić, że ktokolwiek inny chciałby to robić. Biorąc pod uwagę, że robotyka jest technologiczną koniecznością, uznałem, że idąc w tym kierunku, będę miał „przyszłościowy” wybór kariery.
W związku z tym, początkowo podchodziłem do tej dziedziny, koncentrując się na aspektach fizycznych, i ukończyłem studia inżynierskie na Uniwersytecie Technion w Hajfie, w Izraelu. Pod koniec studiów zacząłem zagłębiać się w świat narzędzi CAD i ich możliwości. Są to narzędzia, które pozwalają inżynierom mechanicznym projektować struktury i urządzenia mechaniczne (od mostu po samochód). Zobaczyłem ogromną możliwość wprowadzenia dużych zmian, nie mając do czynienia z powolnymi iteracjami świata fizycznego. W praktyce, te programy miały bardzo niewiele, jeśli w ogóle, zdolności uczenia maszynowego / komputerowego widzenia, które pomagały inżynierom tworzyć prostsze, tańsze i bardziej stabilne systemy mechaniczne (to było w 2015 roku). Wyruszyłem w kierunku komputerowego widzenia danych 3D z głębokim uczeniem (bardzo nowym wówczas) z celem tworzenia inteligentniejszych programów CAD. Praca w początkowych dniach nowoczesnego głębokiego uczenia się, sprawiła, że czułem się częścią czegoś, co mogło być naprawdę wielkie – podobnie jak internet.
W praktyce, moje badania były pierwszymi, które wprowadziły rewolucję głębokiego uczenia się do naszej uczelni na Uniwersytecie Technion. To później przekształciło się w artykuł, który został zaakceptowany na najważniejszej konferencji komputerowego widzenia na świecie, CVPR, i poleciałem na CVPR 2017 na Hawaje. Prezentowanie mojego artykułu i spotkanie z ludźmi otworzyło mi oczy na skalę społeczności komputerowego widzenia (która dzisiaj jest co najmniej 10 razy większa), tysiące uczestników wszystkich pasjonujących się badaniami w tej dziedzinie. To wydarzenie praktycznie utwierdziło mnie w moim kierunku, pokazując mi moc komputerowego widzenia i potencjał, który czeka na odblokowanie.
Czy mógłbyś podzielić się historią powstania Datagen?
Datagen został założony w 2018 roku z misją przekształcenia sposobu, w jaki zespoły uzyskują dane do szkolenia sieci komputerowego widzenia. Rok wcześniej, zobaczyliśmy demo Oculus Rift, który składał się z gogli VR i urządzenia sterującego. Po demonstracji, znaleźliśmy się, zastanawiając się, „z sophisticated kamerami wbudowanymi w gogle, dlaczego potrzebne było urządzenie sterujące, aby połączyć przestrzeń wirtualną z fizyczną (tj. śledzić ruch ręki)?” Sieci neuronowe były już wystarczająco zaawansowane, aby radzić sobie z tym, więc co było problemem?” I wtedy zapaliła się lampka – Dane! Natychmiast zobaczyliśmy ogromną możliwość rozwiązania problemów 3D przestrzennych przy użyciu zaawansowanego komputerowego widzenia i metadanych 3D. Zamiast koncentrować się wyłącznie na VR/AR, podjęliśmy bardziej holistyczne podejście, koncentrując się na pozornie nierozwiązywalnym problemie generowania wystarczających (i dokładnych) danych szkoleniowych, aby umożliwić aplikacje 3D AI w świecie rzeczywistym.
Z uwzględnieniem ludzi i interakcji między ludźmi a środowiskiem, Datagen jest pionierem w nowej dziedzinie danych symulowanych, podzbiorze danych syntetycznych, który koncentruje się na fotorealistycznej rekonstrukcji świata wokół nas. Dzisiaj pracujemy z najbardziej innowacyjnymi firmami na świecie, aby zapalić i przyspieszyć ich rozwój komputerowego widzenia i jesteśmy wspierani przez niektóre z najbardziej szanowanych inwestorów w tej dziedzinie.
Dla czytelników, którzy nie są zaznajomieni, czy mógłbyś wyjaśnić, co konkretnie są dane syntetyczne?
Dane syntetyczne to wszelkie dane szkoleniowe, które – zamiast być zbierane za pomocą bezpośrednich pomiarów lub obserwacji świata rzeczywistego – są generowane albo algorytmicznie, albo za pomocą symulacji. W kontekście komputerowego widzenia, dane syntetyczne to generowane komputerowo obrazy z powiązanymi metadanymi potrzebnymi do szkolenia sztucznej inteligencji. Ze względu na problemy z prywatnością i bardzo realnymi ograniczeniami fizycznymi i ekonomicznymi danych ze świata rzeczywistego, trudno przecenić znaczenie danych syntetycznych dla uczenia maszynowego i AI. W niedawnym raporcie, Gartner przewidział, że do 2024 roku większość danych używanych w dziedzinie AI będzie generowana sztucznie z tych powodów.
Jakie są korzyści danych syntetycznych w porównaniu z ręcznym pozyskiwaniem danych?
Krótko mówiąc, pomyśl o każdym aspekcie ręcznego pozyskiwania danych, który jest niepożądany, i usuń je z procesu — te są korzyści danych syntetycznych.
Generowanie zróżnicowanych zbiorów danych w skali dla szkolenia komputerowego widzenia jest kosztownym i czasochłonnym procesem, a zmienność jest bardzo ograniczona samym faktem, że umieszczanie ludzi w określonych miejscach i fotografowanie ich jest skomplikowanym procesem — o wiele bardziej skomplikowanym i kosztownym niż robienie tego w środowisku symulowanym. Inną dużą korzyścią jest skuteczne wyeliminowanie potrzeby ręcznego adnotowania, które jest nudne, czasochłonne i podatne na błędy ludzkie.
Datagen odnosi się do danych symulowanych jako podzbioru danych syntetycznych. Czy mógłbyś wyjaśnić, co to są dane symulowane?
Dane symulowane to dane syntetyczne, które są generowane za pomocą symulacji. Używamy GAN (oraz niektórych innych najnowocześniejszych metod uczenia maszynowego) do generowania 3D obiektów i umieszczania ich w wysoko realistycznych symulacjach świata rzeczywistego. To wygląda jak proces „wirtualnego robienia zdjęć” z pierwszej osoby, ale działa w systemie foto-realistycznym i opartym na fizyce. Te symulacje produkują dane wizualne (jakby zostały zebrane w świecie rzeczywistym), wraz z pełnym zakresem adnotacji (fizyki, oświetlenia itp.). Tak więc, dane symulowane to dane syntetyczne, które są foto-realistyczne, kontekstowo generowane, 3D obrazy, zebrane w środowisku symulowanym.
Jak Datagen generuje dostosowane dane symulowane?
Technologia Datagen generuje dane symulowane, które są zarówno łatwo skalowalne, jak i dostosowane do potrzeb każdego klienta. Robimy to, biorąc pod uwagę każdy aspekt każdego projektu — od systemu komputerowego widzenia, który jest używany, po demograficzną strukturę regionu, w którym będzie on działał. Niezależnie od tego, czy pracujemy bezpośrednio z naszymi klientami, czy po prostu umożliwiamy ich inżynierom, proces Datagen zaczyna się od ustalenia kluczowych parametrów dla każdego przypadku użycia, takich jak specyfikacje obiektywu, oświetlenie, środowisko, demograficzny rozkład itp. Datagen używa GAN i innych najnowocześniejszych narzędzi i technik do generowania ogromnej ilości zasobów, w tym wszystkiego, od głów ludzkich z dynamicznymi wyrazami twarzy, aby szkolić AI w analizie emocjonalnej, do wnętrz pojazdów dla monitorowania pasażerów w kabinie, i środowisk domowych dla aplikacji wideokonferencyjnych, by wymienić tylko kilka. Dla każdego typu zasobu, Datagen wprowadza zmienność w niezliczonej ilości dyskretnych osi (od koloru skóry i wysokości brwi, do rozmiaru, koloru i kształtu mebli domowych), używając parametrów, które są dokładnie dostosowane do odzwierciedlenia konkretnego przypadku użycia.
Dzięki tym możliwościom, zbiory danych Datagen nie tylko są duże i zróżnicowane, ale także zoptymalizowane do celów szkolenia unikalnego systemu do wykonania unikalnego zadania (lub zestawu zadań) w unikalnym środowisku, w którym będzie on używany — wszystko to bez kompromisowania zdolności do skalowania. Uwzględniamy również konkretnych wymagań adnotacji / metadanych dla każdego przypadku użycia.
Jakie są przykłady rozwiązań w robotyce, w których używa się danych syntetycznych i / lub symulowanych?
Jedną z największych zalet używania danych symulowanych w robotyce jest możliwość generowania obrazów sprzętu, który jest jeszcze w fazie rozwoju. W ten sposób mózg robota (AI) i ciało (sprzęt) mogą być rozwijane równolegle. Teraz, szkolenie może ewoluować wraz z ewolucją specyfikacji, zamiast czekać, aż ostateczny produkt będzie w pełni spreparowany, zanim można zacząć rozwijać AI.
Ponadto, ponieważ dane symulowane są generowane w kontekście, można łatwiej uwzględnić interakcje między robotem a jego środowiskiem. Tak więc, jeśli wyobrażasz sobie robota, który chwyta i usuwa wadliwe produkty z linii montażowej, dane symulowane pozwolą na generowanie danych dla każdej fizycznej wady produktu, a także z perspektywy ramienia robota, aby uchwycić pełny zakres ruchu, interakcji z obiektem, który jest chwycony. Co więcej, metadane 3D oznaczają, że nie ma potrzeby mozolnego adnotowania obrazu po obrazie, aby upewnić się, że robot może właściwie identyfikować produkt, wady, ramiona lub cokolwiek innego w jego polu widzenia.
Jakie są przypadki użycia danych symulowanych w samochodach inteligentnych?
Dane symulowane w rozwoju samochodów inteligentnych sprawiają, że łatwiej jest rozwijać zbiory danych dla konkretnych modeli samochodów, które są projektowane, iterując wraz z samochodem, gdy przechodzi przez różne fazy projektowania i produkcji. Z danymi symulowanymi, inżynierowie mogą również skuteczniej używać widoku w kabinie, aby identyfikować sennych lub rozkojarzonych kierowców, jeśli kierowca zdjął rękę z kierownicy, lub dowolny inny przypadek krawędzi, aby uwzględnić bezpieczeństwo kierowcy. Umożliwia to również inżynierom uwzględnienie większej różnorodności wśród kierowców i pasażerów oraz wprowadzenie zmienności w postaci kąta obrazu i oświetlenia — wszystko to bez naruszenia prywatności prawdziwych ludzi.
Niedawno Datagen ogłosił wiele ekscytujących nowych zatrudnień, co to oznacza dla przyszłości firmy?
Ostatnie dodatki do naszej rady doradczej i kierownictwa wykonawczego obejmują niektóre z najbardziej utalentowanych i doświadczonych profesjonalistów w dziedzinie AI i komputerowego widzenia. Ich wiedza, spostrzeżenia i doświadczenie pomogą skierować i przyspieszyć wzrost Datagen, gdy nawigujemy w branży, która jest jeszcze młoda i pełna możliwości. W branży z tak wieloma nieznanymi, nic nie jest cenniejsze niż wiedza.
Czy jest coś jeszcze, co chciałbyś podzielić o Datagen?
Ze swoją siedzibą w Tel Awiwie, Datagen jest częścią znacznie większej zmiany ekonomicznej i kulturowej, która miała miejsce w Izraelu, i jesteśmy dumni, że jesteśmy częścią tego. W krótkim czasie, Izrael (Tel Awiw w szczególności), stał się głównym globalnym hubem technologicznym, z kwitnącym ekosystemem startupów i energiczną społecznością inwestorów. Chociaż Izrael jest często uważany za hub technologiczny zorientowany na bezpieczeństwo cybernetyczne, technologia AI i danych wzrosła wykładniczo w ostatnich latach. Dzisiaj jest ponad 680 firm AI w Izraelu, które łącznie zebrały 4,5 miliarda dolarów. Ten wybuchowy wzrost w ciągu ostatnich kilku lat jest w dużej mierze wynikiem wysokiej koncentracji inżynierów i światowej sławy uniwersytetów Izraela. Te instytucje akademickie zapewniają dostęp do talentów i najnowocześniejszych technologii w tej dziedzinie. W ostatnich dwóch miesiącach, Datagen zatrudnił ponad 20 nowych pracowników i planuje zatrudnić dodatkowych członków zespołu w dziale sprzedaży i marketingu, oprogramowania i DevOps oraz działu produktu.
Dziękujemy za wspaniały wywiad, czytelnicy, którzy chcą dowiedzieć się więcej, powinni odwiedzić Datagen.


