
Kąt Andersona
Wierność obrazu a realizm w filmach deepfake

 Dodaj Unite.AI do preferowanych źródeł w Google

Kluczowe punktyRealizm deepfake'ów opiera się na spójnej degradacji, a nie na wysokiej wierności, aby…
Zobacz więcej
- Realizm deepfake'ów opiera się na spójnej degradacji, a nie na wysokiej wierności, aby oszukać widzów.
- DeepFaceLab i FaceSwap zawierają wbudowane parametry do degradacji generowanych twarzy w celu uzyskania kontekstowej wiarygodności.
- Nowe szkolenie detekcyjne wykorzystujące realistyczne potoki degradacji poprawia odporność detektorów na artefakty ze świata rzeczywistego.
Nie wszyscy praktycy deepfake mają ten sam cel: impulsem sektora badań nad syntezą obrazu – wspieranym przez wpływowych zwolenników, takich jak Adobe (ADBE ), NVIDIA (NVDA ) i Facebook – jest rozwijanie stanu techniki, aby techniki uczenia maszynowego mogły ostatecznie odtworzyć lub wygenerować działanie ludzkie w wysokiej rozdzielczości i w najtrudniejszych warunkach (wierność).
W przeciwieństwie do tego, celem osób, które chcą wykorzystywać technologie deepfake do rozpowszechniania dezinformacji, jest stworzenie prawdopodobnych symulacji prawdziwych ludzi przy użyciu wielu metod innych niż sama wierność twarzy deepfake. W tym scenariuszu, dodatkowe czynniki, takie jak kontekst i prawdopodobieństwo, są prawie równe potencjałowi filmu do symulowania twarzy (realizm).
Ta iluzjonistyczna sztuczka rozciąga się na degradację końcowej jakości obrazu filmu deepfake, tak aby cały film (a nie tylko zwodnicza część reprezentowana przez twarz deepfake) miał spójny “wygląd”, który jest dokładny do oczekiwanego poziomu jakości dla medium.
‘Spójny’ nie musi oznaczać ‘dobry’ – wystarczy, że jakość jest spójna w całym oryginale i wstawionym, sfałszowanym treści, i odpowiada oczekiwaniom. W przypadku transmisji VOIP na platformach takich jak Skype i Zoom, poprzeczka może być niezwykle niska, z przerywanym, szorstkim filmem i całym szeregiem potencjalnych artefaktów kompresji, a także “wygładzającymi” algorytmami zaprojektowanymi w celu zmniejszenia ich wpływu – które same w sobie stanowią dodatkowy zestaw “nieautentycznych” efektów, które zaakceptowaliśmy jako konsekwencje i ekscentryczności transmisji na żywo.
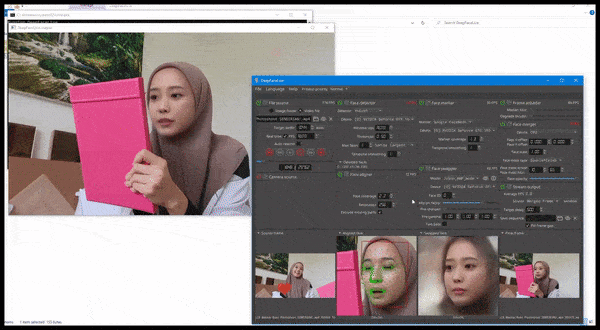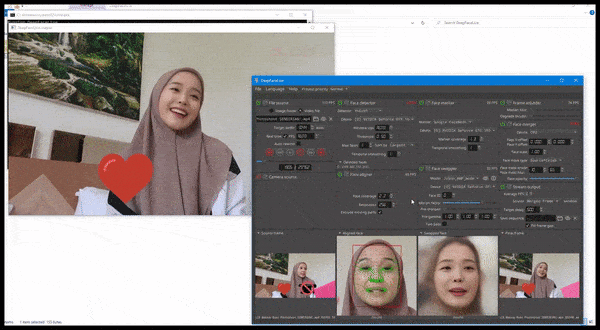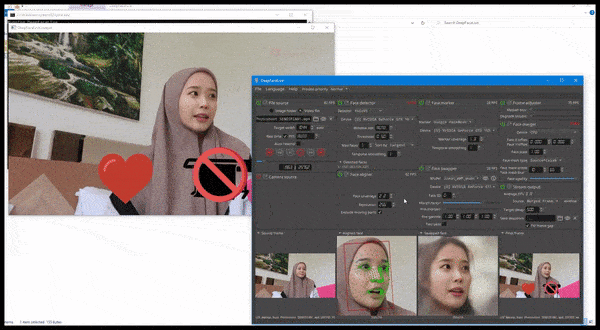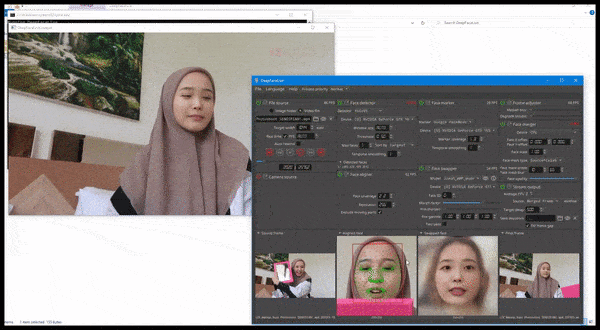
DeepFaceLive w akcji: ta wersja transmisyjna oprogramowania DeepFaceLab może zapewnić kontekstualny realizm, prezentując fałszywe twarze w kontekście ograniczonej jakości wideo, wraz z problemami odtwarzania i innymi powtarzalnymi artefaktami połączenia. Źródło: https://www.youtube.com/watch?v=IL517EgYH8U
Wbudowana Degradacja
W istocie, dwa najpopularniejsze pakiety deepfake (oba pochodzące z kontrowersyjnego kodu źródłowego z 2017 roku) zawierają składniki przeznaczone do integracji twarzy deepfake z kontekstem “historycznego” lub niższej jakości wideo poprzez degradację wygenerowanej twarzy. W DeepFaceLab, parametr bicubic_degrade_power realizuje to, a w FaceSwap, ustawienie “grain” w konfiguracji Ffmpeg pomaga również w integracji fałszywej twarzy, zachowując ziarno podczas kodowania*.

Ustawienie ‘grain’ w FaceSwap ułatwia autentyczną integrację z treścią wideo nie-HQ i treścią dziedziczną, która może zawierać efekty ziarnistego filmu, które są dość rzadkie w ostatnich czasach.
Często zamiast pełnego i zintegrowanego filmu deepfake, twórcy deepfake generują izolowaną serię plików PNG z kanałami alfa, z których każdy obraz przedstawia tylko syntetyczną twarz, tak aby strumień obrazu mógł być przekonwertowany na wideo na platformach z bardziej zaawansowanymi możliwościami efektów pogarszających jakość, takimi jak Adobe After Effects, zanim fałszywa i prawdziwa zawartość zostaną połączone w celu utworzenia końcowego wideo.
Oprócz tych zamierzonych degradacji, zawartość pracy deepfake jest często rekompresowana, albo algorytmicznie (gdzie platformy mediów społecznościowych starają się zaoszczędzić przepustowość, produkując lżejsze wersje uploadów użytkowników) na platformach takich jak YouTube i Facebook, albo przez ponowne przetwarzanie oryginalnej pracy w celu utworzenia animowanych GIF-ów, sekcji szczegółowych lub innych różnorodnych workflow, które traktują oryginalny wydanie jako punkt wyjścia i wprowadzają dodatkową kompresję.
Realistyczne Konteksty Wykrywania Deepfake
Biorąc to pod uwagę, nowy artykuł ze Szwajcarii zaproponował zmianę metodyki za podejściami do wykrywania deepfake, ucząc systemów wykrywania, aby nauczyły się cech zawartości deepfake, gdy jest ona przedstawiana w celowo zdegradowanych kontekstach.

Stochastyczna augmentacja danych zastosowana do jednego z zestawów danych użytych w nowym artykule, zawierająca szum Gaussa, korekcję gamma i rozmycie Gaussa, a także artefakty kompresji JPEG. Źródło: https://arxiv.org/pdf/2203.11807.pdf
W nowym artykule, badacze argumentują, że pionierskie pakiety wykrywania deepfake opierają się na nierzeczywistych warunkach benchmarkowych dla kontekstu metryk, które stosują, i że “zdegradowany” wyjście deepfake może spaść poniżej minimalnego progu jakości do wykrycia, chociaż ich realistycznie “brudna” zawartość jest prawdopodobnie oszukać widzów z powodu słusznej uwagi do kontekstu.
Badacze wprowadzili nowy proces degradacji danych, który udaje się poprawić zdolność uogólniania wiodących wykrywaczy deepfake, z tylko marginalną utratą dokładności w stosunku do oryginalnych wskaźników wykrywania uzyskanych przez “czyste” dane. Oferują również nowy framework oceny, który może ocenić odporność wykrywaczy deepfake w rzeczywistych warunkach, wspierany przez obszernymi badaniami ablacyjnymi.
Artykuł artykuł nosi tytuł Nowe Podejście do Poprawy Wykrywania Deepfake Opartego na Uczeniu w Realistycznych Warunkach, i pochodzi od badaczy z Multimedia Signal Processing Group (MMSPG) i Ecole Polytechnique Federale de Lausanne (EPFL), oba z siedzibą w Lozannie.
Pożyteczne zakłócenia
Poprzednie próby włączenia zdegradowanego wyjścia do podejść wykrywania deepfake obejmują Mixup sieć neuronową, ofertę z 2018 roku od MIT i FAIR, oraz AugMix, współpracę z 2020 roku pomiędzy DeepMind i Google, obie metody augmentacji danych, które próbują “zamącić” materiał szkoleniowy w sposób, który ma na celu pomóc w uogólnieniu.
Badacze nowej pracy zauważają również poprzednie studia, które zastosowały szum Gaussa i artefakty kompresji do danych szkoleniowych w celu ustalenia granic relacji między pochodną cechą a szumem, w którym jest ona osadzona.
Nowe badanie oferuje potok, który symuluje kompromitowane warunki procesu akwizycji obrazu i kompresji oraz różnych innych algorytmów, które mogą dalej degradować wyjście obrazu w procesie dystrybucji. Poprzez włączenie tego rzeczywistego workflow do ramy oceny, jest możliwe wytworzenie danych szkoleniowych dla wykrywaczy deepfake, które są bardziej odporne na artefakty.

Logiczna konstrukcja i workflow dla nowego podejścia.
Proces degradacji został zastosowany do dwóch popularnych i udanych zestawów danych użytych do wykrywania deepfake: FaceForensics++ i Celeb-DFv2. Dodatkowo, wiodące ramy wykrywaczy deepfake Capsule-Forensics i XceptionNet zostały przeszkolone na wersjach o pogorszonej jakości dwóch zestawów danych.
Wykrywacze zostały przeszkolone z optymalizatorem Adam przez 25 i 10 epok odpowiednio. Dla transformacji zestawu danych, 100 klatek zostało losowo wybranych z każdego filmu szkoleniowego, z 32 klatkami wyodrębnionymi do testowania, przed dodaniem procesów degradujących.
Zniekształcenia brane pod uwagę w workflow obejmowały szum, gdzie zero-średni szum Gaussa został zastosowany na sześciu różnych poziomach; zmianę rozmiaru, aby symulować zmniejszoną rozdzielczość typowych nagrań na zewnątrz, co może typowo wpłynąć na wykrywacze; kompresję, gdzie różne poziomy kompresji JPEG zostały zastosowane w danych; wygładzanie, gdzie trzy typowe filtry wygładzające używane w “denoisingu” są oceniane dla ramy; poprawę, gdzie kontrast i jasność zostały dostosowane; i połączenia, gdzie dowolna kombinacja trzech powyższych metod została jednocześnie zastosowana do pojedynczego obrazu.
Testowanie i Wyniki
Podczas testowania danych, badacze przyjęli trzy metryki: Dokładność (ACC); pole pod krzywą ROC (AUC); i wynik F1.
Badacze przetestowali standardowo przeszkolone wersje dwóch wykrywaczy deepfake przeciwko zafałszowanym danym i stwierdzili, że są one niewystarczające:
‘Ogólnie, większość realistycznych zniekształceń i przetwarzania jest niezwykle szkodliwa dla normalnie przeszkolonych wykrywaczy deepfake opartych na uczeniu. Na przykład, metoda Capsule-Forensics wykazuje bardzo wysokie wyniki AUC na obu niekompresowanych zestawach testowych FFpp i Celeb-DFv2 po przeszkoleniu na odpowiednich zestawach danych, ale następnie doświadcza dramatycznego spadku wydajności na zmodyfikowanych danych z naszego frameworku oceny. Podobne trendy zostały zaobserwowane z detektorem XceptionNet.’
W przeciwieństwie do tego, wydajność dwóch wykrywaczy została znacznie poprawiona przez przeszkolenie na przekształconych danych, z każdym detektorem, który jest teraz bardziej zdolny do wykrywania wcześniej niewidzianych, wprowadzających w błąd materiałów.
‘Schemat augmentacji danych znacznie poprawia odporność dwóch wykrywaczy i jednocześnie utrzymuje wysoką wydajność na oryginalnych, niezmienionych danych.’

Porównania wydajności między surowymi a uzupełnionymi zestawami danych używanymi w badaniu dwóch wykrywaczy deepfake.
Artykuł kończy się:
‘Obecne metody wykrywania są zaprojektowane, aby osiągnąć jak najwyższą wydajność na konkretnych benchmarkach. Często wynika to z poświęcenia zdolności uogólniania na bardziej realistyczne scenariusze. W tym artykule, starannie zaprojektowany schemat augmentacji danych oparty na naturalnym procesie degradacji obrazu jest proponowany.
‘Rozległe eksperymenty pokazują, że prosta, ale skuteczna technika znacznie poprawia odporność modelu przeciwko różnym realistycznym zniekształceniom i operacjom przetwarzania w typowych workflow obrazu.’
* Dopasowanie ziarna w wygenerowanej twarzy jest funkcją transferu stylu podczas procesu konwersji.
Pierwotnie opublikowane 29 marca 2022. Zaktualizowane o 20:33 czasu wschodniego, aby wyjaśnić użycie ziarna w Ffmpeg.


