
Kąt Andersona
Disney łączy CGI z renderowaniem neuronowym, aby zwalczyć „dolinę niepokoju”

 Dodaj Unite.AI do preferowanych źródeł w Google
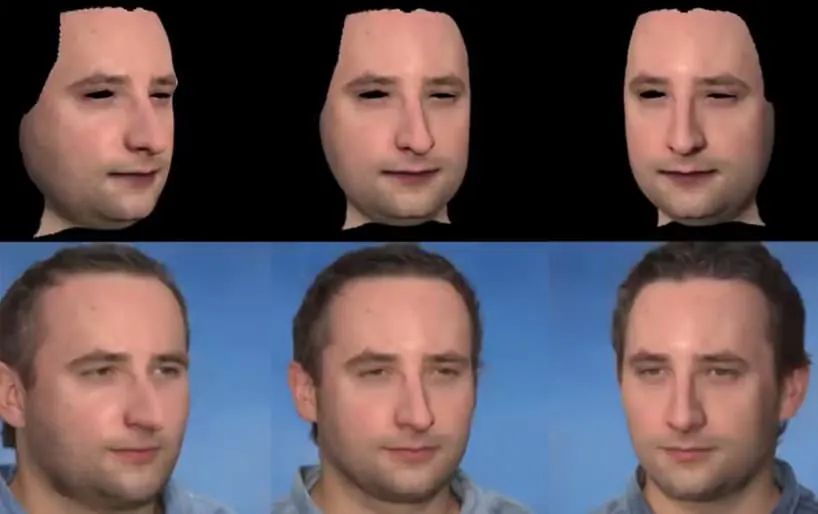
Dział badań AI Disneya opracował hybrydową metodę symulacji twarzy o jakości filmowej, łączącą zalety renderowania neuronowego twarzy z konsekwencją podejścia opartego na CGI.
Nadchodzący artykuł nosi tytuł Rendering with Style: Combining Traditional and Neural Approaches for High Quality Face Rendering i jest zaprezentowany w nowym, 10‑minutowym wideo na kanale Disney Research na YouTube (osadzone na końcu tego artykułu*).
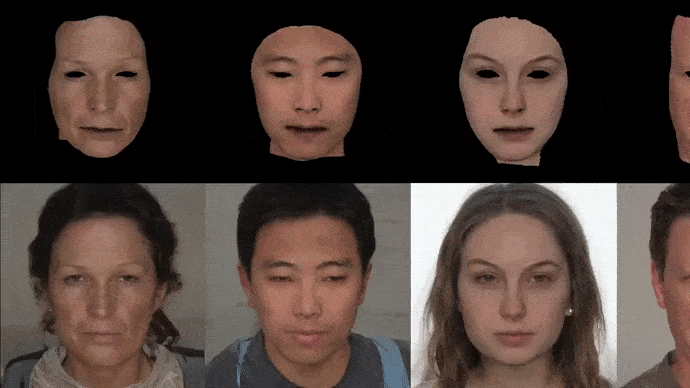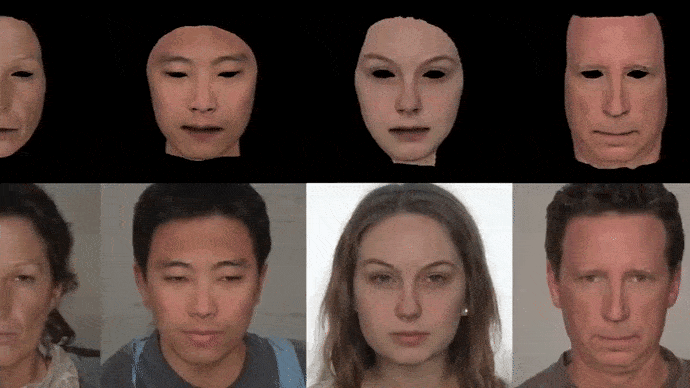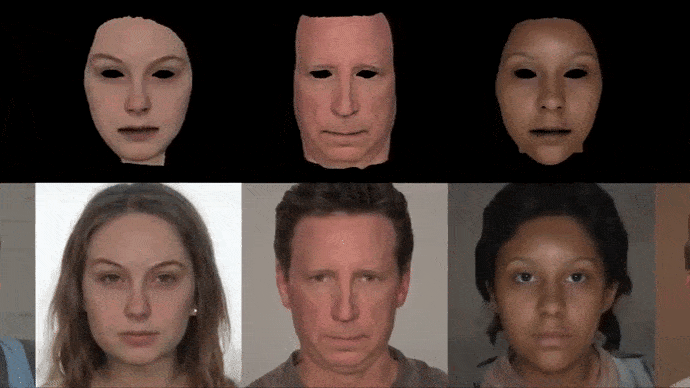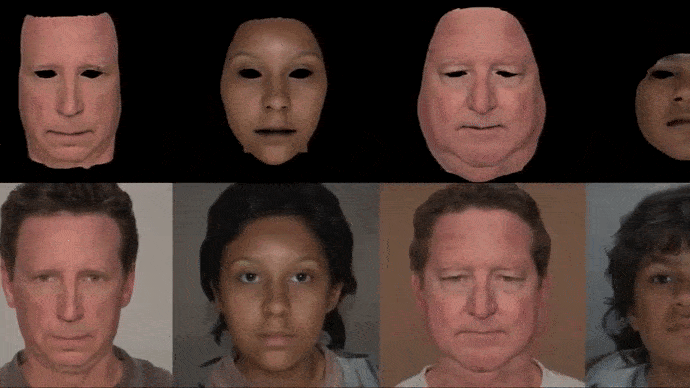
Meshes combined with neural facial renders. See video embed at end of article for better detail and quality. Source: https://www.youtube.com/watch?v=TwpLqTmvqVk
Jak zauważa wideo, renderowanie neuronowe twarzy (w tym deepfake) może generować znacznie bardziej realistyczne oczy i wnętrza ust niż CGI, podczas gdy tekstury twarzy generowane przez CGI są bardziej spójne i odpowiednie do efektów VFX na poziomie kinowym.
W związku z tym Disney eksperymentuje, pozwalając generatorowi neuronowemu NVIDIA StyleGan2 obsługiwać otaczające cechy twarzy oraz „życiowo krytyczne” elementy, takie jak oczy, jednocześnie nakładając spójną skórę twarzy CGI i powiązane elementy na wynik.

From the video (see end of article), the architectural concept behind Disney’s hybrid approach, where an old-school CGI mesh, of the type used to recreate ‘young’ Carrie Fisher and the late Peter Cushing for Rogue One (2016), is integrated into neurally-rendered face environments.
Wideo subtelnie odnosi się do częstej krytyki nieautentyczności i efektu „dolinę niepokoju” w rekonstrukcji CGI zmarłego brytyjskiego aktora Star Wars Petera Cushinga w Rogue One (2016), przyznając:
‘[Jest] wciąż ogromna przepaść między tym, co ludzie mogą łatwo uchwycić i wyrenderować, a ostatecznymi fotorealistycznymi cyfrowymi sobowtórami, kompletnymi z włosami, oczami i wnętrzem ust. Aby zamknąć tę przepaść, zwykle wymaga to dużo ręcznej pracy wykwalifikowanych artystów.’
W rzeczywistości nawet najnowocześniejsze systemy przechwytywania twarzy nie próbują odtwarzać oczu, wnętrz ust ani włosów, które w tych technikach mają problemy z autentycznością (oczy) lub ze spójnością czasową (włosy).

The video illustrates what VFX artists will get after a typical modern facial capture session. Eyes, hair, facial hair, and mouth interiors will all have to be handled by separate teams in the production pipeline, in addition to texturing and lighting.
Kontrola oświetlenia
Hybrydowe podejście jest również zaletą przy ponownym oświetlaniu – istotnym wyzwaniu w renderowaniu neuronowym twarzy, ponieważ nakładki skóry CGI można łatwiej ponownie oświetlić.
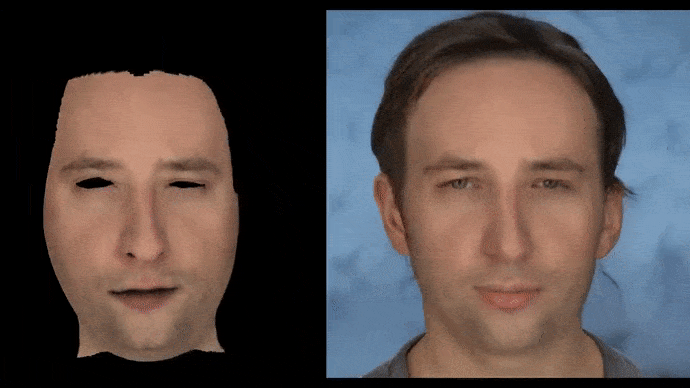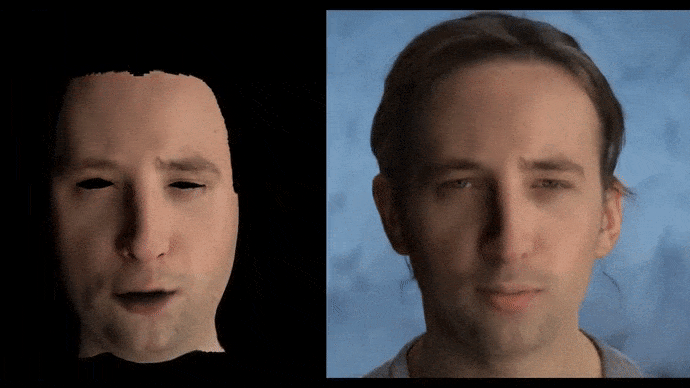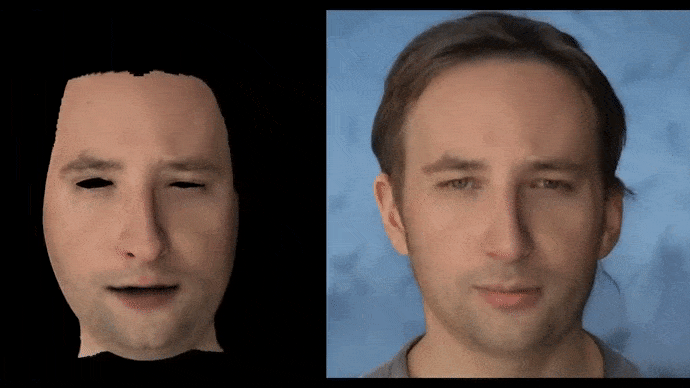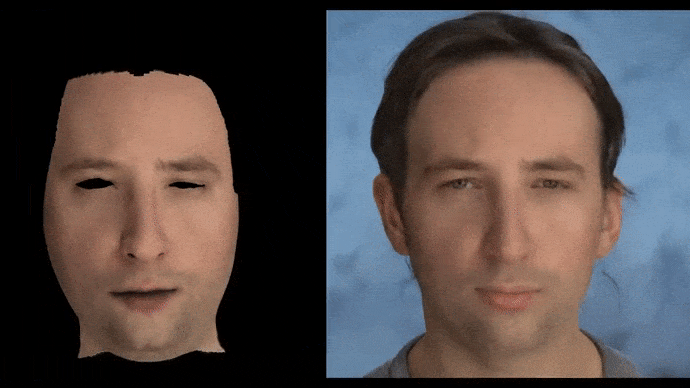
An animated version of the CGI/Neural approach.
W trudniejszych warunkach, takich jak zdjęcia na zewnątrz, badacze opracowali metodę wypełniania (inpaintingu) wokół rodzaju strefy zdemilitaryzowanej otaczającej osobę będącą „tworzoną”.

A black margin is generated to allow a ‘canvas’ for inpainting the outer parts of the identity and integrating the CGI skin into the combined CGI/neural output.
Wideo zauważa:
‘[Render] neuronowy nie dopasowuje się idealnie do ograniczeń tła. – jest przeznaczony jedynie jako wskazówka, ponieważ optymalizacja realistycznych ludzkich elementów, takich jak włosy, oczy i zęby, jest głównym celem. Trudniejsze jest utrzymanie spójnej tożsamości przy jednoczesnej zmianie oświetlenia otoczenia.’
Tworzenie siatek CGI z renderów neuronowych
Zespół badawczy opracował również wariacyjny autoenkoder wytrenowany na (nieokreślonej) dużej bazie danych obrazów 3D twarzy i twierdzi, że potrafi generować „losowe, ale wiarygodne” siatki twarzy 3D na podstawie danych rzeczywistych.
Istnieją ograniczenia, które trzeba pokonać, w tym trudność w utrzymaniu temporalnej spójności włosów w renderach neuronowych, a wideo (patrz poniżej) pokazuje kilka przykładów gwałtownie zmieniających się włosów przy jednocześnie spójnym panoramowaniu wokół twarzy CGI/neuronalnej.
Spójność czasowa w renderowaniu wideo neuronowym jest znacznie szerszym problemem niż tylko w przypadku Disneya i wydaje się prawdopodobne, że późniejsze iteracje tego systemu mogą sięgnąć po dodawanie włosów „w postprodukcji” lub inne możliwe podejścia do generowania włosów, zamiast liczyć na to, że nowatorska metoda neuronowa ostatecznie rozwiąże problem.
Zastosowania do generowania zbiorów danych
Metoda jest również proponowana jako potencjalny sposób generowania danych syntetycznych i wzbogacania krajobrazu zestawów obrazów twarzy, który w ostatnich latach stał się niebezpiecznie monotonnym.

Disney envisages the new technique populating facial image datasets.
‘[Każdy] fotorealistyczny wynik, który generujemy, ma podłożoną odpowiadającą geometrię i mapy wyglądu, renderowane z nieznanych punktów widzenia kamery przy znanym oświetleniu. Te informacje „ground truth” mogą być kluczowe dla szkolenia aplikacji downstream, takich jak jednowidokowa, trójwymiarowa rekonstrukcja twarzy, rozpoznawanie twarzy czy rozumienie sceny. Dlatego każdy renderowany wynik może być traktowany jako próbka danych i możemy generować wiele wariacji wielu różnych osób.
‘Ponadto, nawet dla jednej osoby renderowanej w jednej ekspresji, z jednego punktu widzenia i oświetlenia, możemy generować losowe wariacje fotorealistycznego renderu, zmieniając ziarno losowości podczas optymalizacji.’
Badacze zauważają, że ta różnorodność konfigurowalnych wyników może być przydatna w szkoleniu aplikacji rozpoznawania twarzy, podsumowując:
‘[Nasza] metoda potrafi wykorzystać obecną technologię przechwytywania, modelowania i renderowania skóry twarzy oraz automatycznie tworzyć kompletne fotorealistyczne rendery twarzy, które odpowiadają pożądanej tożsamości, wyrazu i konfiguracji sceny. To podejście ma zastosowanie w renderowaniu twarzy dla filmu i rozrywki, oszczędzając pracę ręczną artystów, a także w generowaniu danych w różnych dziedzinach uczenia głębokiego.’
Aby dokładniej przyjrzeć się nowemu podejściu, obejrzyj 10‑minutowe wideo opublikowane dzisiaj:
* Oryginalny link do wideo został zastąpiony innym, prawdopodobnie identycznym, 8 godzin po opublikowaniu tego artykułu. Zmieniłem wszystkie odpowiednie linki, ponieważ nie ma śladu oryginalnego wideo.
8:24 GMT+2 – Wideo zostało zastąpione, ponieważ kanał Disney Research na YouTube wymienił je z jakiegoś powodu.


