
Modele i platformy AI
Kompletny przewodnik po Gemma 2: nowy otwarty duży model językowy Google

 Dodaj Unite.AI do preferowanych źródeł w Google
Gemma 2 rozbudowuje swój poprzednik, oferując zunifikowaną wydajność i efektywność, wraz z zestawem innowacyjnych funkcji, które sprawiają, że jest szczególnie atrakcyjny zarówno dla badań, jak i zastosowań praktycznych. To, co wyróżnia Gemmę 2, to jej zdolność do dostarczania wyników porównywalnych z dużo większymi modelami własnościowymi, ale w pakiecie zaprojektowanym dla szerszej dostępności i użycia na bardziej skromnych konfiguracjach sprzętowych.
Gdy zagłębiłem się w specyfikacje techniczne i architekturę Gemmy 2, znalazłem się coraz bardziej zadowolony z pomysłowości jej projektu. Model ten wykorzystuje kilka zaawansowanych technik, w tym nowe mechanizmy uwagi i innowacyjne podejścia do stabilności szkolenia, które przyczyniają się do jej niezwykłych możliwości.

Google [securities_stock_price_tag symbol="GOOGL" exchange="NASDAQ"] Open Source LLM Gemma
W tym kompletnym przewodniku, będziemy badać Gemmę 2 w głębi, badając jej architekturę, kluczowe funkcje i zastosowania praktyczne. Niezależnie od tego, czy jesteś doświadczonym praktykiem AI, czy entuzjastycznym nowicjuszem w tej dziedzinie, ten artykuł ma na celu dostarczyć cenne wglądy w to, jak Gemma 2 działa i jak możesz wykorzystać jej moc w swoich projektach.
Czym jest Gemma 2?
Gemma 2 to najnowszy otwarty model językowy Google, zaprojektowany, aby być lekki, a jednocześnie potężny. Zbudowany jest na tej samej technologii, która posłużyła do stworzenia modeli Gemini, oferując najlepsze wyniki w bardziej dostępnym pakiecie. Gemma 2 występuje w dwóch rozmiarach:
Gemma 2 9B: model o 9 miliardach parametrów
Gemma 2 27B: większy model o 27 miliardach parametrów
Każdy rozmiar jest dostępny w dwóch wariantach:
Modele podstawowe: wstępnie przeszkolone na ogromnym korpusie danych tekstowych
Modele dostosowane do instrukcji (IT): dokształcone w celu lepszej wydajności w określonych zadaniach
Dostęp do modeli w Google AI Studio: Google AI Studio – Gemma 2
Przeczytaj raport techniczny tutaj: Raport techniczny Gemmy 2
Kluczowe funkcje i ulepszenia
Gemma 2 wprowadza kilka znaczących ulepszeń w stosunku do swojego poprzednika:
1. Zwiększona ilość danych szkoleniowych
Modele zostały przeszkolone na znacznie większej ilości danych:
Gemma 2 27B: przeszkolona na 13 bilionach tokenów
Gemma 2 9B: przeszkolona na 8 bilionach tokenów
Ten rozszerzony zestaw danych, składający się głównie z danych sieciowych (głównie angielskich), kodu i matematyki, przyczynia się do lepszej wydajności i wszechstronności modeli.
2. Mechanizm uwagi z przesunięciem
Gemma 2 wdraża nowatorskie podejście do mechanizmów uwagi:
Każda co druga warstwa wykorzystuje mechanizm uwagi z przesunięciem z lokalnym kontekstem 4096 tokenów
Warstwy na przemian wykorzystują pełną kwadratową uwagę globalną w całym kontekście 8192 tokenów
To hybrydowe podejście ma na celu zbalansowanie wydajności z możliwością przechwytywania dalekosiężnych zależności wejściowych.
3. Miękkie ograniczanie
W celu poprawy stabilności szkolenia i wydajności, Gemma 2 wprowadza mechanizm miękkiego ograniczania:
<p>def soft_cap(x, cap):
return cap * torch.tanh(x / cap)</p>

<p># Zastosowane do logitów uwagi
attention_logits = soft_cap(attention_logits, cap=50.0)</p>

# Zastosowane do logitów warstwy końcowej

<p>final_logits = soft_cap(final_logits, cap=30.0)
Ta technika zapobiega nadmiernemu wzrostowi logitów bez twardej truncacji, zachowując więcej informacji i stabilizując proces szkolenia.
- Gemma 2 9B: model o 9 miliardach parametrów
- Gemma 2 27B: większy model o 27 miliardach parametrów
Każdy rozmiar jest dostępny w dwóch wariantach:
- Modele podstawowe: wstępnie przeszkolone na ogromnym korpusie danych tekstowych
- Modele dostosowane do instrukcji (IT): dokształcone w celu lepszej wydajności w określonych zadaniach
4. Destylacja wiedzy
Dla modelu 9B, Gemma 2 wykorzystuje techniki destylacji wiedzy:
- Przeszkolenie: model 9B uczy się od większego modelu nauczyciela podczas początkowego szkolenia
- Po szkoleniu: zarówno modele 9B, jak i 27B wykorzystują destylację zgodną z polityką do doskonalenia ich wydajności
Ten proces pomaga mniejszemu modelowi przechwycić możliwości większych modeli w sposób bardziej efektywny.
5. Łączenie modeli
Gemma 2 wykorzystuje nowatorską technikę łączenia modeli o nazwie Warp, która łączy wiele modeli w trzech etapach:
- Średnia ruchoma wykładnicza (EMA) podczas dostrajania za pomocą uczenia wzmacnianego
- Sferyczna interpolacja liniowa (SLERP) po dostrajaniu wielu polityk
- Interpolacja liniowa w kierunku inicjacji (LITI) jako ostateczny krok
To podejście ma na celu stworzenie bardziej wytrzymałego i zdolnego ostatecznego modelu.
Wyniki benchmarkowe
Gemma 2 prezentuje imponujące wyniki w różnych benchmarkach:
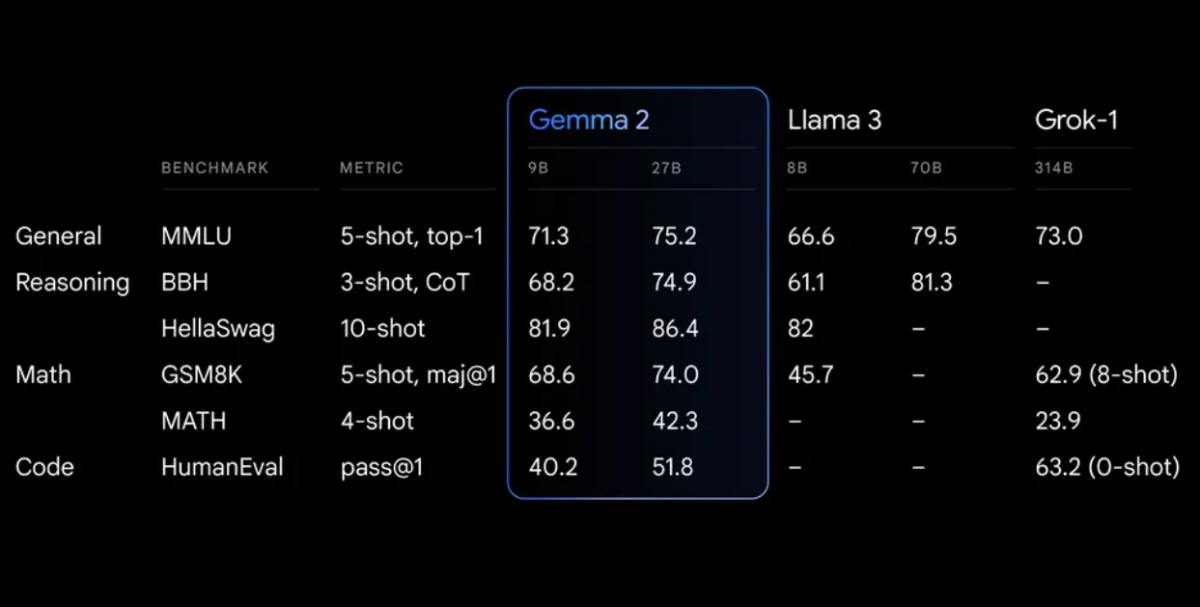
Gemma 2 na zredesignowanej architekturze, zaprojektowanej zarówno dla wyjątkowej wydajności, jak i efektywności inferencji
Rozpoczynanie pracy z Gemmą 2
Aby rozpocząć korzystanie z Gemmy 2 w swoich projektach, masz kilka opcji:
1. Google AI Studio
Dla szybkiej eksperymentacji bez wymagań sprzętowych, możesz uzyskać dostęp do Gemmy 2 za pośrednictwem Google AI Studio.
2. Hugging Transformers
Gemma 2 jest zintegrowana z popularną biblioteką Hugging Face Transformers. Oto, jak możesz z niej skorzystać:
<div class="relative flex flex-col rounded-lg"> <div class="text-text-300 absolute pl-3 pt-2.5 text-xs"> <p>from transformers import AutoTokenizer, AutoModelForCausalLM</p> <p># Załaduj model i tokenizator model_name = "google/gemma-2-27b-it" # lub "google/gemma-2-9b-it" dla mniejszej wersji tokenizer = AutoTokenizer.from_pretrained(model_name) model = AutoModelForCausalLM.from_pretrained(model_name)</p> <p># Przygotuj dane wejściowe prompt = "Wyjaśnij pojęcie splątania kwantowego w prosty sposób." inputs = tokenizer(prompt, return_tensors="pt")</p> <p># Wygeneruj tekst outputs = model.generate(**inputs, max_length=200) response = tokenizer.decode(outputs[0], skip_special_tokens=True)</p> print(response)
3. TensorFlow/Keras
Dla użytkowników TensorFlow, Gemma 2 jest dostępna za pośrednictwem Keras:
<p>import tensorflow as tf from keras_nlp.models import GemmaCausalLM</p> <p># Załaduj model model = GemmaCausalLM.from_preset("gemma_2b_en")</p> <p># Wygeneruj tekst prompt = "Wyjaśnij pojęcie splątania kwantowego w prosty sposób." output = model.generate(prompt, max_length=200)</p> print(output)
Zaawansowane zastosowania: Budowanie lokalnego systemu RAG z Gemmą 2
Jednym z potężnych zastosowań Gemmy 2 jest budowanie systemu RAG (Retrieval Augmented Generation). Stworzymy prosty, w pełni lokalny system RAG, wykorzystując Gemmę 2 i Nomic embeddings.
Krok 1: Konfigurowanie środowiska
Najpierw upewnij się, że masz zainstalowane niezbędne biblioteki:
<p>pip install langchain ollama nomic chromadb</p>
Krok 2: Indeksowanie dokumentów
Stwórz indeksator, aby przetworzyć Twoje dokumenty:
<p>import os from langchain.text_splitter import RecursiveCharacterTextSplitter from langchain.document_loaders import DirectoryLoader from langchain.vectorstores import Chroma from langchain.embeddings import HuggingFaceEmbeddings</p> <p>class Indexer: def __init__(self, directory_path): self.directory_path = directory_path self.text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200) self.embeddings = HuggingFaceEmbeddings(model_name="nomic-ai/nomic-embed-text-v1")</p> <p>def load_and_split_documents(self): loader = DirectoryLoader(self.directory_path, glob="**/*.txt") documents = loader.load() return self.text_splitter.split_documents(documents)</p> <p>def create_vector_store(self, documents): return Chroma.from_documents(documents, self.embeddings, persist_directory="./chroma_db")</p> <p>def index(self): documents = self.load_and_split_documents() vector_store = self.create_vector_store(documents) vector_store.persist() return vector_store</p> <p># Użycie indexer = Indexer("ścieżka/do/twoich/dokumentów") vector_store = indexer.index()</p>
Krok 3: Konfigurowanie systemu RAG
Teraz, stworzymy system RAG, wykorzystując Gemmę 2:
<p>from langchain.llms import Ollama
from langchain.chains import RetrievalQA
from langchain.prompts import PromptTemplate</p>
<p>class RAGSystem:
def __init__(self, vector_store):
self.vector_store = vector_store
self.llm = Ollama(model="gemma2:9b")
self.retriever = self.vector_store.as_retriever(search_kwargs={"k": 3})</p>
<p>self.template = """Użyj następujących fragmentów kontekstu, aby odpowiedzieć na pytanie na końcu.
Jeśli nie wiesz odpowiedzi, po prostu powiedz, że nie wiesz, nie próbuj wymyślać odpowiedzi.</p>
{context}
<p>Pytanie: {question}
Odpowiedź: """</p>
<p>self.qa_prompt = PromptTemplate(
template=self.template, input_variables=["context", "question"]
)</p>
<p>self.qa_chain = RetrievalQA.from_chain_type(
llm=self.llm,
chain_type="stuff",
retriever=self.retriever,
return_source_documents=True,
chain_type_kwargs={"prompt": self.qa_prompt}
)</p>
<p>def query(self, question):
return self.qa_chain({"query": question})</p>
<p># Użycie
rag_system = RAGSystem(vector_store)
response = rag_system.query("Jaka jest stolica Francji?")
print(response["result"])</p>
Ten system RAG wykorzystuje Gemmę 2 za pośrednictwem Ollama dla modelu językowego oraz Nomic embeddings do odzyskiwania dokumentów. Pozwala on na zadawanie pytań na podstawie zindeksowanych dokumentów, dostarczając odpowiedzi z kontekstem z odpowiednich źródeł.
Doskonalenie Gemmy 2
Dla określonych zadań lub dziedzin, możesz chcieć doskonalić Gemmę 2. Oto podstawowy przykład, wykorzystujący bibliotekę Hugging Face Transformers:
from transformers import AutoTokenizer, AutoModelForCausalLM, TrainingArguments, Trainer from datasets import load_dataset <p># Załaduj model i tokenizator model_name = "google/gemma-2-9b-it" tokenizer = AutoTokenizer.from_pretrained(model_name) model = AutoModelForCausalLM.from_pretrained(model_name)</p> <p># Przygotuj zestaw danych dataset = load_dataset("twój_zestaw_danych")</p> <p>def tokenize_function(examples): return tokenizer(examples["text"], padding="max_length", truncation=True)</p> <p>tokenized_datasets = dataset.map(tokenize_function, batched=True)</p> <p># Ustaw parametry szkolenia training_args = TrainingArguments( output_dir="./results", num_train_epochs=3, per_device_train_batch_size=4, per_device_eval_batch_size=4, warmup_steps=500, weight_decay=0.01, logging_dir="./logs", )</p> <p># Zainicjuj Trainer trainer = Trainer( model=model, args=training_args, train_dataset=tokenized_datasets["train"], eval_dataset=tokenized_datasets["test"], )</p> # Rozpocznij doskonalenie trainer.train() <p># Zapisz doskonalony model model.save_pretrained("./fine_tuned_gemma2") tokenizer.save_pretrained("./fine_tuned_gemma2")</p>
Pamiętaj, aby dostosować parametry szkolenia do Twoich konkretnych wymagań i zasobów obliczeniowych.
Zagadnienia etyczne i ograniczenia
Chociaż Gemma 2 oferuje imponujące możliwości, ważne jest, aby być świadomym jej ograniczeń i zagadnień etycznych:
- Założenia: Jak wszystkie modele językowe, Gemma 2 może odzwierciedlać założenia obecne w danych szkoleniowych. Zawsze krytycznie oceniaj jej dane wyjściowe.
- Dokładność faktów: Chociaż bardzo zdolna, Gemma 2 może czasem generować nieprawidłowe lub niespójne informacje. Weryfikuj ważne fakty z wiarygodnych źródeł.
- Długość kontekstu: Gemma 2 ma długość kontekstu 8192 tokenów. Dla dłuższych dokumentów lub rozmów, możesz potrzebować wdrożyć strategie zarządzania kontekstem w sposób efektywny.
- Zasoby obliczeniowe: Szczególnie dla modelu 27B, mogą być wymagane znaczne zasoby obliczeniowe do efektywnej inferencji i doskonalenia.
- Odpowiedzialne użycie: Przestrzegaj zasad odpowiedzialnego AI Google i upewnij się, że Twoje użycie Gemmy 2 jest zgodne z etycznymi zasadami AI.
Podsumowanie
Gemma 2, dzięki zaawansowanym funkcjom, takim jak mechanizm uwagi z przesunięciem, miękkie ograniczanie i nowatorskie techniki łączenia modeli, stanowi potężne narzędzie do szerokiego zakresu zadań związanych z przetwarzaniem języka naturalnego.
Wykorzystując Gemmę 2 w swoich projektach, niezależnie od tego, czy jest to prosta inferencja, złożone systemy RAG, czy dostosowane modele dla określonych dziedzin, możesz skorzystać z mocy najnowocześniejszego AI, zachowując kontrolę nad swoimi danymi i procesami.


