Liderzy opinii
Mosty między zespołami infrastruktury i produktów: Lekcje z budowy platform GenAI

 Dodaj Unite.AI do preferowanych źródeł w Google
Nie ma wątpliwości: Generative AI, czyli GenAI, jest tematem dnia, i tak było przez ostatnie dwa lata. Niezależnie od tego, czy celem jest zautomatyzowanie procesów, wygenerowanie nowych projektów produktów, stworzenie treści, czy jakikolwiek inny cel w różnych dziedzinach, teraz jest czas, aby organizacje zaczęły wykonywać najważniejsze prace i wdrożyć swoje strategie GenAI.
Sukces GenAI, od badań po szkolenie i ostatecznie inferencję, zależy od ścisłej koordynacji wokół wdrożenia, obserwowalności, zarządzania kosztami, telemetrii i celów opóźnienia infrastruktury i usług. Pomagają one osiągnąć poziom wydajności dla obciążenia AI, zapewniając skuteczną równowagę między obliczeniami a komunikacją, zapewniając, że karty graficzne zawsze mają potrzebne dane.
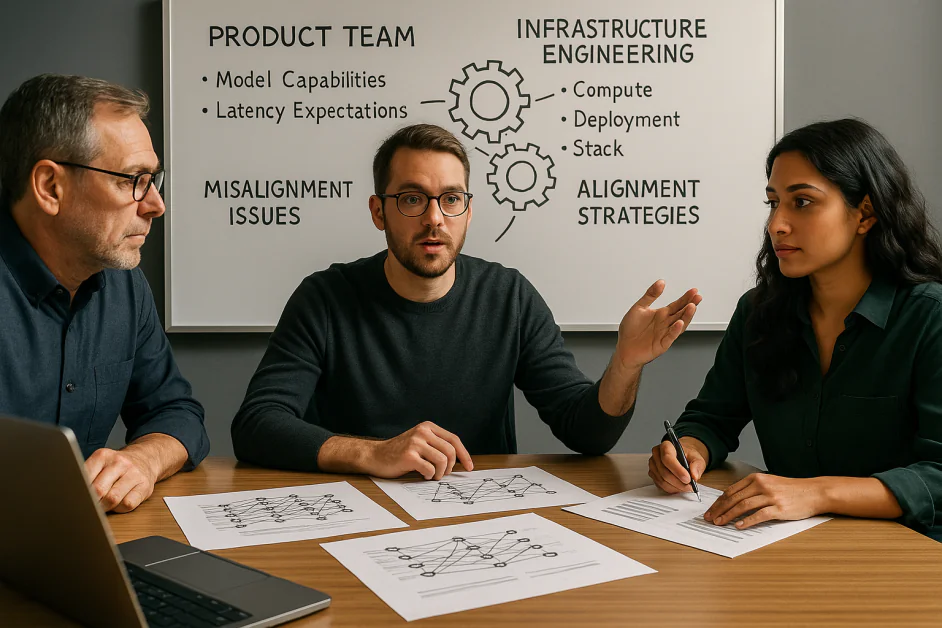
Wyzwaniem jest to, że często występuje strukturalna luka: inżynieria infrastruktury koncentruje się na stosie obliczeniowym i wdrożeniowym, podczas gdy zespoły oprogramowania i produktów skupiają się na tworzeniu aplikacji użytkowych, które wprowadzają GenAI do świata rzeczywistego. Gdy te grupy nie są w pełni zsynchronizowane, często skutkuje to opóźnieniami w dostawie, problemami z wydajnością i problemami z używalnością.
Więc, jak wygląda ta luka w świecie rzeczywistym, i jakie strategie mogą stosować organizacje, aby zsynchronizować zespoły infrastruktury i produktów dla sukcesu GenAI?
Problemy z niesynchronizacją
Gdy zespoły infrastruktury i produktów są niesynchronizowane, objawy są często oczywiste, ale nie zawsze są szybko rozwiązywane. Jednym z charakterystycznych objawów niesynchronizowanych zespołów jest niezgodność założeń dotyczących oczekiwań dotyczących opóźnień lub możliwości modelu. Na przykład zespoły inżynierii infrastruktury mogą planować funkcje lub wdrożenia, które zakładają poziomy wydajności, których rzeczywisty projekt infrastruktury nie spełnia. Prowadzi to do późnych prac nad projektem, zmian w zakresie i opóźnień w dostawie.
Niesynchronizacja może również prowadzić do słabej wydajności z powodu wdrożenia na infrastrukturze, która nie jest zoptymalizowana pod kątem wydajności, co objawia się zmianami opóźnień i problemami ze skalowalnością, które wpływają na wydajność szkolenia lub dużych rozproszonych zadań inferencyjnych. Ryzyka związane z bezpieczeństwem i zgodnością są również charakterystycznymi objawami niesynchronizacji zespołów, ponieważ brak wczesnej współpracy między zespołami oznacza, że wymagania dotyczące prywatności danych i zgodności mogą być pomijane.
I wreszcie, niesynchronizacja zespołów prowadzi do złej jakości doświadczenia użytkownika, co powoduje, że zespoły inżynierii infrastruktury muszą stosować rozwiązania tymczasowe, gdy ograniczenia są niejasne, co spowalnia cykle iteracji i zwiększa dług techniczny. Oczywiście niesynchronizacja między zespołami produktów i infrastruktury może być kosztowna w każdym projekcie oprogramowania, ale w przypadku GenAI stawka jest znacznie wyższa — zwiększone nieefektywności operacyjne, utrata przewagi konkurencyjnej i ryzyka związane z bezpieczeństwem.
Most do sukcesu
Sukces GenAI zależy nie tylko od posiadania solidnej infrastruktury, ale także od stworzenia taktycznego ramienia, które łączy procesy infrastruktury i produktów. Weźmy na przykład pomysł wewnętrznych interfejsów API dla udostępniania GPU. Dla zespołów infrastruktury te API standaryzują dostęp, redukują obciążenie biletów i zapewniają zgodność; dla zespołów produktów zapewniają szybki, przewidywalny dostęp do obliczeń bez oczekiwania w kolejce. Wynikiem jest to, że obie strony pracują na podstawie tego samego “kontraktu” API, usuwając wąskie gardła i wyjaśniając oczekiwania.
Pulpity nawigacyjne w czasie rzeczywistym odgrywają podobną rolę. Przynoszą one inżynierom infrastruktury widoczność obciążenia systemu i wydajności, jednocześnie pokazując zespołom produktów, jak ich obciążenia tłumaczą się na rzeczywiste zużycie. Ponieważ obie strony widzą te same dane, dyskusje na temat wydajności lub wąskich gardeł stają się bardziej współpracujące i mniej antagonistyczne — istnieje jeden źródło prawdy.
Automatyczne skalowanie jest kolejnym mechanizmem ujednolicającym. Uwalnia inżynierów infrastruktury od ciągłego gaszenia pożarów, jednocześnie zapewniając, że deweloperzy produktów nie napotykają na sufity wydajności podczas szczytów obciążenia. To, co mogłoby być walką między stabilnością a elastycznością, staje się wspólną strategią: skala jest zarządzana automatycznie, zgodnie z celami operacyjnej wytrzymałości i wydajności produktu.
Wreszcie, spostrzeżenia dotyczące kosztów dodają wymiar finansowy do tego wspólnego widoku. Zespoły infrastruktury mogą optymalizować przydziały i uzasadniać planowanie pojemności, podczas gdy zespoły produktów zyskują uznanie dla tego, jak ich wybory architektoniczne lub modelowe wpływają na wydatki. Ta przejrzystość sprzyja wspólnej odpowiedzialności, zmieniając wydajność w zbiorową odpowiedzialność, a nie ukrytą troskę.
Ale synchronizacja wymaga więcej niż tylko wspólne narzędzia — wymaga również wspólnej wizji. To jest miejsce, w którym wspólne mapy drogowe wchodzą w grę: Każdy zespół musi nie tylko zrozumieć ogólne cele, ale także kroki niezbędne do ich osiągnięcia. Dla infrastruktury oznacza to spojrzenie poza głębokie korzenie techniczne w sprzęcie i oprogramowaniu, aby zaangażować się w to, jak deweloperzy i użytkownicy końcowi naprawdę doświadczają systemu. Dla zespołów produktów wymaga to szacunku dla ograniczeń, takich jak opóźnienia, koszty i wydajność modelu, doceniając operacyjne realia, które sprawiają, że innowacje są zrównoważone.
Wreszcie, żadne partnerstwo nie może przetrwać bez wzajemnego zobowiązania do bezpieczeństwa i zgodności. Niezależnie od tego, czy mają zastosowanie ramy SOC2, HIPAA, ISO, czy inne — konkretnymi wymogami rządzą bazą klientów i pionem przemysłowym — odpowiedzialność jest współdzielona. Zarówno zespoły infrastruktury, jak i produkty muszą wewnętrznie zrozumieć te zobowiązania, uznając, że zgodność nie jest ćwiczeniem polegającym na odhaczaniu pól, ale podstawą zaufania do użytkowników.
Weźmy te praktyki i nastawienia razem, które łączą infrastrukturę i produkty w spójną jedność, z wspólnym językiem, widocznością i odpowiedzialnością za postępy, wytrzymałość i godność.
Wiedzące zespoły
Posiadanie odpowiednich ludzi jest równie ważne, jak posiadanie odpowiednich systemów. Idealnie, zespoły powinny składać się z członków, którzy już znają się na GenAI lub tych, którzy pochodzą z wysokowydajnych środowisk obliczeniowych i centrów danych. To, co naprawdę ma znaczenie, to praktyczne doświadczenie i lekcje, które można uzyskać tylko poprzez budowanie i wspieranie platform GPU-as-a-service. Oznacza to zrozumienie, jak karty graficzne komunikują się ze sobą, jak ściśle sprzężone szkolenia zachowują się, i jak wrażliwe są na opóźnienia, synchronizację i dostarczanie danych.
Gdy modele nadal rosną i wdrożenia są skalowane, zespoły muszą również wycofać się i pomyśleć o pełnej podróży klienta. Zaczyna się od wczesnych badań i eksperymentów, przechodzi przez duże szkolenia, a następnie dostrajanie i wreszcie inferencję. Każda z tych faz wygląda trochę inaczej, a potrzeby zmieniają się w miarę postępu. Iteracyjny charakter rozwoju modelu ciągle uczy nas, jakiego rodzaju infrastruktury, przepływów pracy i możliwości są wymagane, aby centrum danych GenAI było przydatne.
Zbyt często zespoły infrastruktury i produktów działają w swoich własnych bańkach. Dla każdej firmy, która poważnie myśli o skalowaniu GenAI do produkcji, to musi się zmienić. Sukces zależy od rozbicia tych silosów i stworzenia wspólnej własności platformy. Z odpowiednimi ludźmi, wyraźną wizją i praktycznym ramieniem, obie strony mogą zsynchronizować się na tym samym planie — który pomaga im poruszać się szybciej, pozostać odpowiedzialnymi i ostatecznie dostarczać udane wdrożenia GenAI.