
Andersons vinkel
Fjerning av objekter fra video mer effektivt med maskinlæring

 Legg til Unite.AI blant dine foretrukne kilder på Google
Viktige punkterE2FGVI forener tre stadier av videoinnmaling i ett ende-til-ende-system for betydelige…
Vis mer
- E2FGVI forener tre stadier av videoinnmaling i ett ende-til-ende-system for betydelige effektivitetsgevinster.
- Systemet kjører femten ganger raskere enn tidligere metoder for optisk flyt, samtidig som det oppnår toppmoderne resultater.
- En ny tidsmessig fokal-transformer utvider oppmerksomheten fra 2D til 3D for sammenhengende innholdshallusinering på tvers av bilder.
Ny forskning fra Kina rapporterer om resultater på høyeste nivå i forskningsfeltet – samt en imponerende forbedring i effektivitet – for et nytt videosystem for inpainting som kan fjerne objekter fra filmen med stor dyktighet.
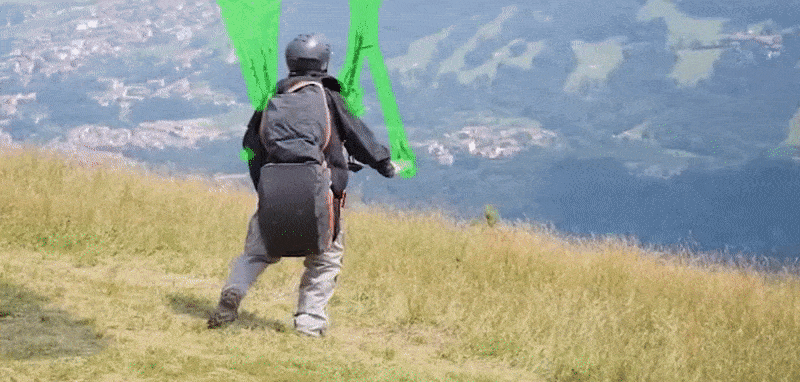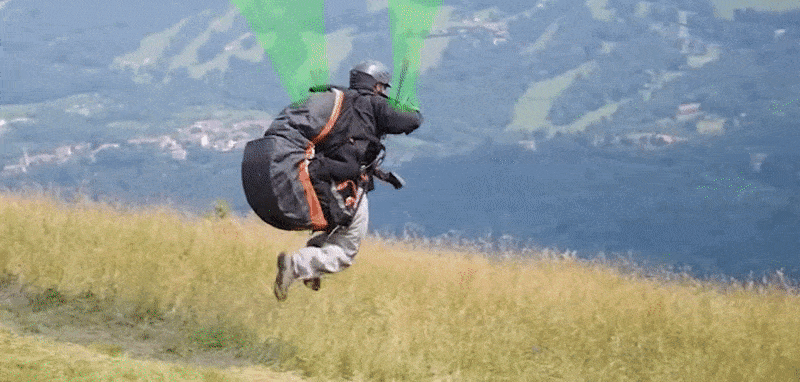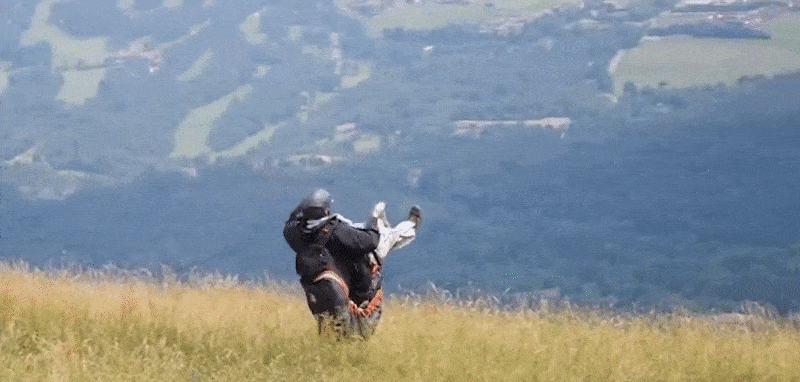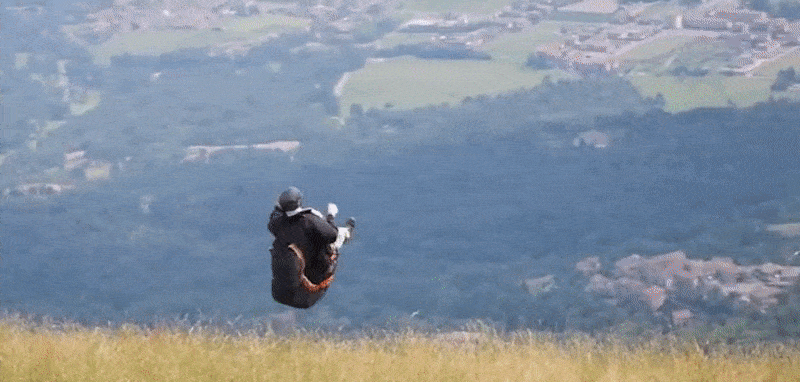
Selen til en hanggliderpilot er malt ut med den nye prosedyren. Se kildevideoen for bedre oppløsning og flere eksempler. Kilde: https://www.youtube.com/watch?v=N–qC3T2wc4
Teknikken, kalt End-to-End-rammeverk for Flow-Guided video Inpainting (E2FGVI), er også i stand til å fjerne vannmerker og andre typer okklusjoner fra videoinnhold.
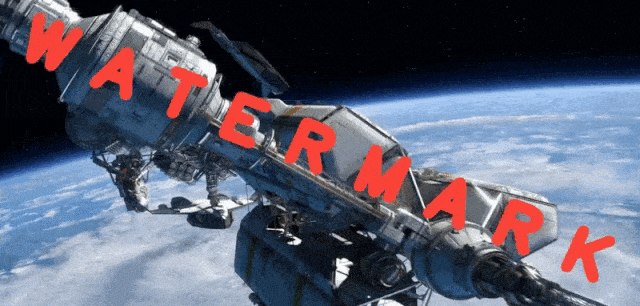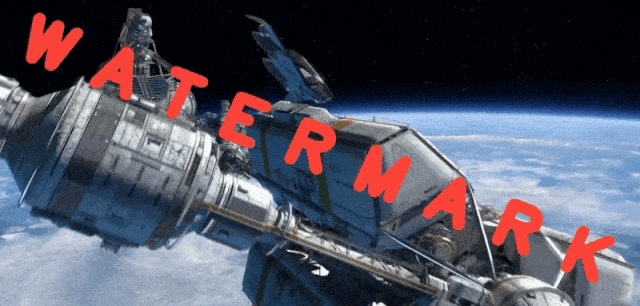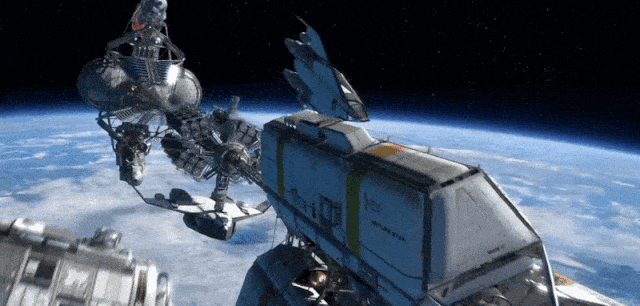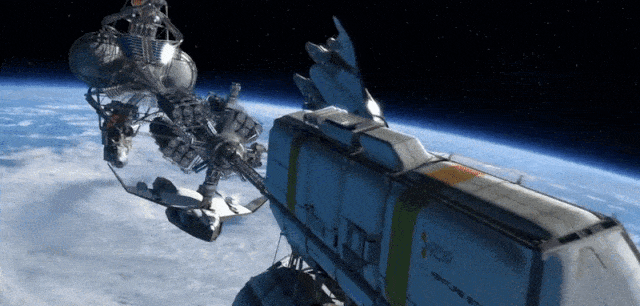
E2FGVI beregner prediksjoner for innhold som ligger bak okklusjoner, og muliggjør fjerning av selv merkbare og vanskelige vannmerker. Kilde: https://github.com/MCG-NKU/E2FGVI
(For å se flere eksempler i bedre oppløsning, se videoen)
Selv om modellen i den publiserte artikkelen ble trent på videoer med 432px x 240px (vanligvis lave inndatastørrelser, begrenset av tilgjengelig GPU-plass vs. optimale batch-størrelser og andre faktorer), har forfatterne siden lansert E2FGVI-HQ, som kan håndtere videoer i vilkårlig oppløsning.
Koden for den nåværende versjonen er tilgjengelig på GitHub, mens HQ-versjonen, som ble lansert forrige søndag, kan lastes ned fra Google Drive og Baidu Disk.

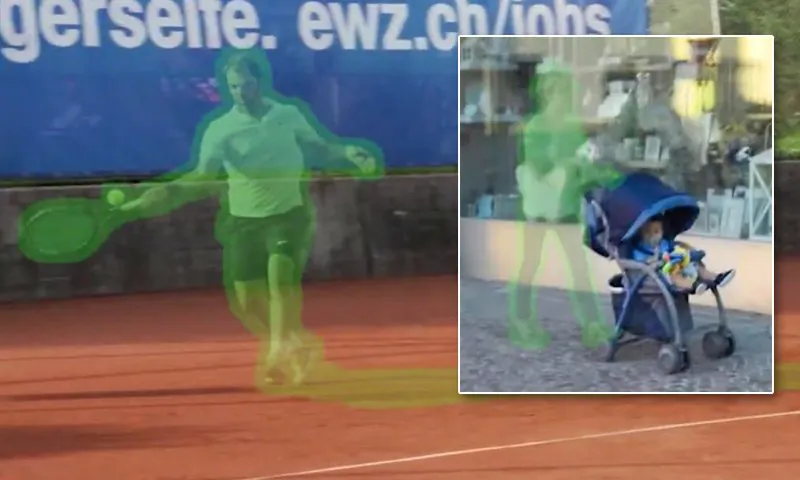
Barnet blir i bildet.
E2FGVI kan prosessere videoer med 432×240 oppløsning på 0,12 sekunder per bilde på en Titan XP-GPU (12GB VRAM), og forfatterne rapporterer at systemet opererer femten ganger raskere enn tidligere ledende metoder basert på optisk strøm.
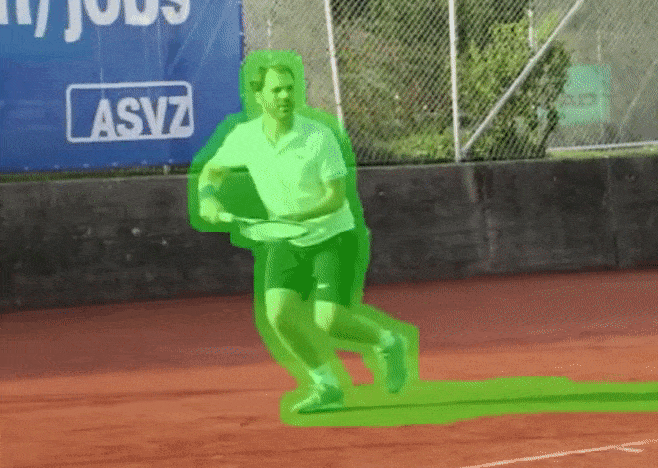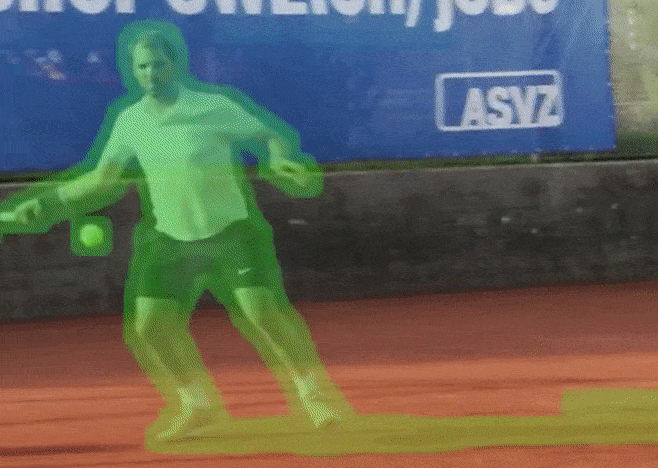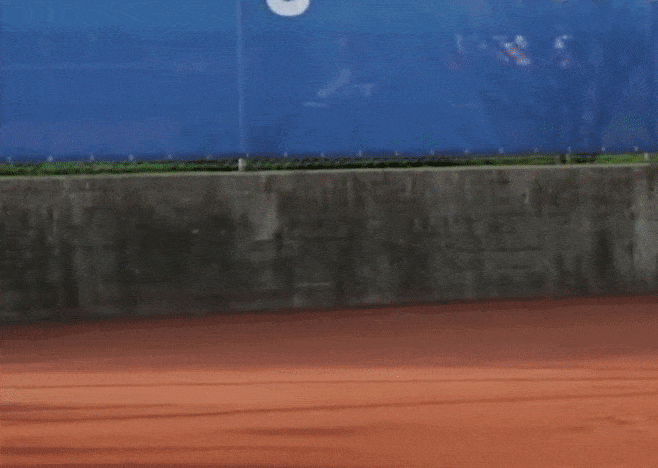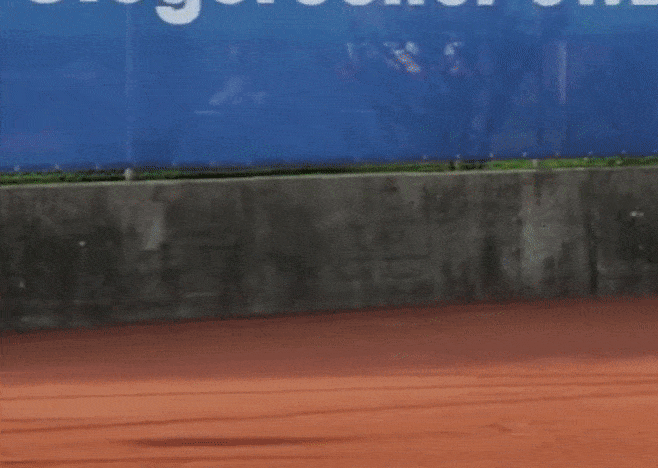
En tennisspiller forlater bildet uventet.
Testet på standarddatasett for denne undersektoren av bilde-synteseforskning, var den nye metoden i stand til å overgå rivaler i både kvalitative og kvantitative evalueringer.

Tester mot tidligere tilnærminger. Kilde: https://arxiv.org/pdf/2204.02663.pdf
Artikkelen heter Towards An End-to-End Framework for Flow-Guided Video Inpainting, og er et samarbeid mellom fire forskere fra Nankai University, sammen med en forsker fra Hisilicon Technologies.
Hva mangler i dette bildet
Foruten de åpenbare anvendelsene for visuelle effekter, vil høykvalitets video-inpainting bli en sentral, definerende funksjon for nye AI-baserte bilde-syntese- og bilde-endrings-teknologier.
Dette er særlig tilfelle for kroppsendrings-motefunksjoner og andre rammeverk som søker å ‘slanke ned’ eller på andre måter endre scener i bilder og videoer. I slike tilfeller er det nødvendig å overbevisende ‘fylle inn’ den ekstra bakgrunnen som blir avdekket av syntesen.

Fra en nylig artikkel, har en algoritme for endring av kroppsform til oppgave å fylle inn den nyoppdagede bakgrunnen når en person i bildet får endret størrelse. Her er denne mangelen representert av den røde konturen som den (i virkeligheten, se bildet til venstre) mer fyldige personen tidligere okkuperte. Basert på kildemateriale fra https://arxiv.org/pdf/2203.10496.pdf
Koherent optisk strøm
Optisk strøm (OF) har blitt en kjerneteknologi i utviklingen av video-objekt-fjerning. Som et atlas, gir OF ett kart over en tidssekvens. Ofte brukt til å måle hastighet i datavisjons-initiativer, kan OF også muliggjøre temporalt konsistent inpainting, hvor oppgaven som helhet kan betraktes i ett enkelt pass, i stedet for Disney-stil ‘per bilde’-oppmerksomhet, som uunngåelig fører til temporal diskontinuitet.
Video-inpainting-metoder til dags dato har sentrert seg rundt en tre-stegs prosess: strøm-fullføring, hvor videoen i stor grad kartlegges ut i en avgrenset og utforskbar enhet; pixel-propagasjon, hvor hullene i ‘korrupte’ videoer fylles inn ved å propagere piksler i begge retninger; og innholdshallusinasjon (piksel-oppfinnelse som er kjent for de fleste av oss fra deepfakes og tekst-til-bilde-rammeverk som DALL-E-serien) hvor det estimerte ‘manglende’ innholdet blir funnet opp og satt inn i filmen.
Den sentrale innovasjonen i E2FGVI er å kombinere disse tre stegene i ett end-to-end-system, og gjøre det unødvendig å utføre manuelle operasjoner på innholdet eller prosessen.

Artikkelen observerer at behovet for manuell inngripen krever at eldre prosesser ikke tar i bruk en GPU, og gjør dem ganske tidskrevende. Fra artikkelen*:
‘Ved å ta DFVI som et eksempel, tar fullføring av en video med størrelsen 432 × 240 fra DAVIS, som inneholder omtrent 70 bilder, omtrent 4 minutter, noe som er uakseptabelt i de fleste virkelige applikasjoner. Foruten de ovennevnte ulemper, ignorerer bare bruk av et forhånds-trent bilde-inpainting-nettverk på innholdshallusinasjons-stadiet innholdets relasjoner over tidsnære naboer, og fører til inkonsistent generert innhold i videoer.’
Ved å forene de tre stegene i video-inpainting, er E2FGVI i stand til å erstatte det andre stadiet, piksel-propagasjon, med spredning av kjennetegn. I de mer segmenterte prosessene i tidligere arbeid, er kjennetegn ikke like omfattende tilgjengelige, fordi hvert stadium er relativt hermetisk, og arbeidsflyten bare semi-automatisert.
I tillegg har forskerne utviklet en temporal fokus-transformator for innholdshallusinasjons-stadiet, som tar i betraktning ikke bare de direkte naboene av piksler i det nåværende bildet (dvs. hva som skjer i den delen av bildet i det foregående eller neste bildet), men også de fjerne naboene som er mange bilder unna, og likevel vil påvirke den kohesive effekten av alle operasjoner som utføres på videoen som helhet.

Arkitektur av E2FGVI.
Den nye kjennetegnbaserte sentrale delen av arbeidsflyten er i stand til å dra nytte av flere prosesser på kjennetegnnivå og lærbare samplingsoffsett, mens prosjektets nye fokus-transformator, ifølge forfatterne, utvider størrelsen på fokus-vinduer ‘fra 2D til 3D’.
Tester og data
For å teste E2FGVI, evaluerte forskerne systemet mot to populære video-objekt-segmenteringsdatasett: YouTube-VOS og DAVIS. YouTube-VOS har 3741 treningsvideoklipp, 474 valideringsklipp og 508 testklipp, mens DAVIS har 60 treningsvideoklipp og 90 testklipp.
E2FGVI ble trent på YouTube-VOS og evaluert på begge datasett. Under trening ble objektmasker (de grønne områdene i bildene ovenfor, og den tilhørende YouTube-videoen) generert for å simulere video-fullføring.
For målinger, adopterte forskerne Peak signal-til-støy-forhold (PSNR), Strukturell likhet (SSIM), Video-basert Fréchet-Inception-avstand (VFID) og Flow Warping-feil – den siste for å måle temporal stabilitet i den berørte videoen.
De tidligere arkitekturene som systemet ble testet mot, var VINet, DFVI, LGTSM, CAP, FGVC, STTN og FuseFormer.

Fra den kvantitative resultatsjekken i artikkelen. Opp- og ned-piler indikerer at høyere eller lavere tall er bedre, henholdsvis. E2FGVI oppnår de beste poengene over hele linjen. Metodene blir evaluert ifølge FuseFormer, selv om DFVI, VINet og FGVC ikke er end-to-end-systemer, og det er umulig å anslå deres FLOPs.
I tillegg til å oppnå de beste poengene mot alle konkurranse-systemer, gjennomførte forskerne en kvalitativ bruker-undersøkelse, hvor videoer transformert med fem representative metoder ble vist individuelt til tyve frivillige, som ble bedt om å vurdere dem i henhold til visuell kvalitet.

Den vertikale aksen representerer prosentandelen av deltakerne som foretrakk E2FGVI-utgangen i henhold til visuell kvalitet.
Forfatterne bemerker at til tross for den enstemmige preferansen for deres metode, gjenspeiler ett av resultatene, FGVC, ikke de kvantitative resultatene, og de antyder at dette indikerer at E2FGVI muligens på misvisende vis genererer ‘mer visuelt behagelige resultater’.
I henhold til effektivitet bemerker forfatterne at deres system kraftig reduserer flyttallsoperasjoner per sekund (FLOPs) og inferens-tid på en enkelt Titan-GPU på DAVIS-datasettet, og observerer at resultater viser at E2FGVI kjører 15 ganger raskere enn strøm-baserte metoder.
De kommenterer:
‘[E2FGVI] har de laveste FLOPs i kontrast til alle andre metoder. Dette indikerer at den foreslåtte metoden er svært effektiv for video-inpainting.’
*Min konvertering av forfatternes kildehenvisninger i løpende tekst til lenker.
Først publisert 19. mai 2022.
Endret tirsdag 28. oktober 2025, for å fjerne feilaktig video-innlemming og endre referanser til innlemmet video i artikkelteksten.


