
Andersons vinkel
Konsistent redigering av AI-videoinnhold med tekststyrte inndata

 Legg til Unite.AI blant dine foretrukne kilder på Google
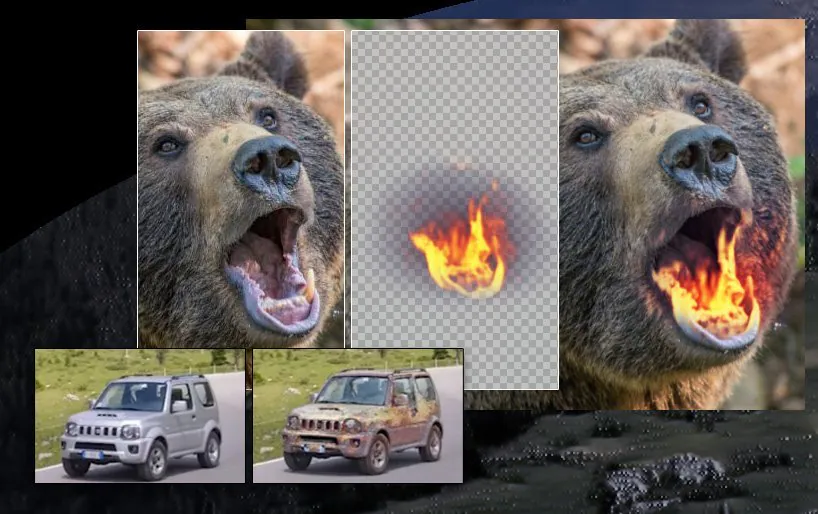
Viktige punkterText2Live muliggjør konsistente videoredigeringer fra tekstinstrukser uten…
Vis mer
- Text2Live muliggjør konsistente videoredigeringer fra tekstinstrukser uten bilde-for-bilde-behandling.
- Systemet bruker et nevralt lagdelt atlas for å bruke redigeringer én gang over hele videotidslinjen.
- Text2Live automatiserer maskering og komposisjon, og eliminerer behovet for rotoscoping eller grønne skjermer.
Mens den profesjonelle VFX-bransjen er fascinert – og noen ganger føler seg litt truet – av nye innovasjoner i bilde- og videosyntese, mangler de fleste av disse prosjektene en temporel kontinuitet, noe som gjør at mange av disse prosjektene havner i den “psykedeliske” sfæren, med skinnende og raskt endrende teksturer og strukturer, inkonsistente effekter og den type grove teknologi-håndtering som minner om fotokjemiske epoken av visuelle effekter.
Hvis du ønsker å endre noe svært spesifikt i en video som ikke faller innenfor området for deepfakes (dvs. å påføre en ny identitet på eksisterende film av en person), opererer de fleste av de nåværende løsningene under ganske strenge begrensninger, når det gjelder nøyaktigheten som kreves for produksjonskvalitets visuelle effekter.
Et unntak er det pågående arbeidet til en løs gruppe av akademikere fra Weizmann Institute of Science. I 2021 annonserte tre av forskerne, i samarbeid med Adobe (ADBE ), en ny metode for å dekomponere video og legge til et konsistent internt kart – et lagdelt nevralt atlas – i et sammensatt resultat med alfakanaler og tidsmessig sammenheng.
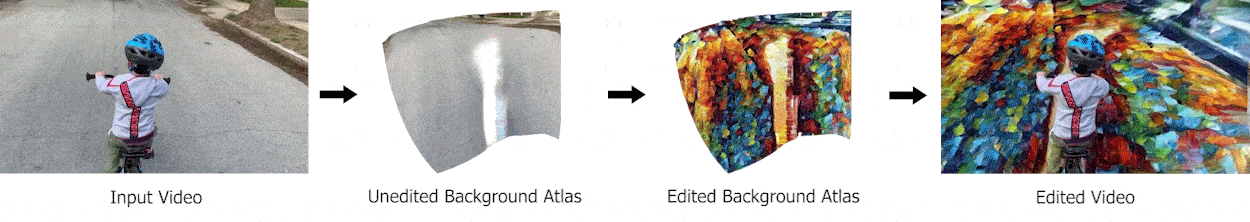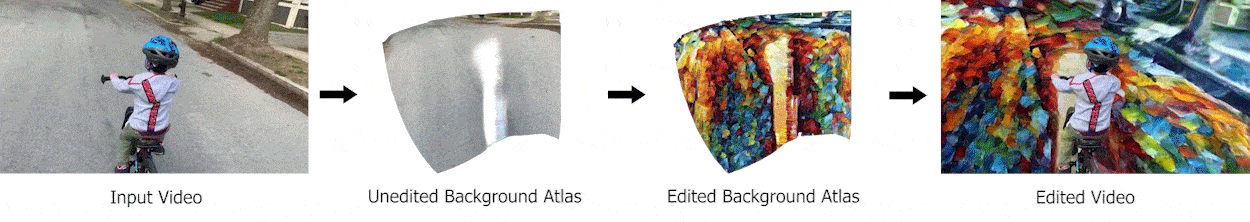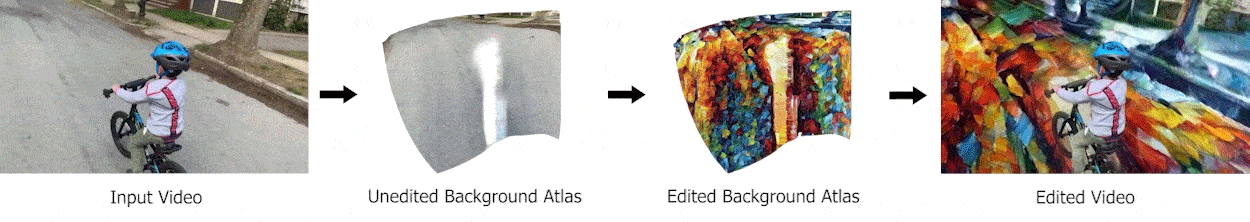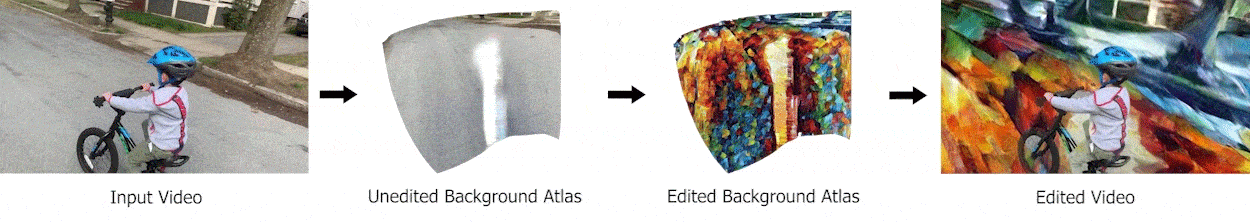
Fra forskningsartikkelen fra 2021: et estimat av den fullstendige gjennomføringen av veien i kildeklippet er redigert via et nevralt nettverk på en måte som tradisjonelt ville kreve omfattende rotoscoping og match-moving. Siden bakgrunn og forgrunnselementer håndteres av forskjellige nettverk, er masker virkelig ‘automatiske’. Kilde: https://layered-neural-atlases.github.io/
Skjønt det faller noen plass innenfor området dekket av optisk flyt i VFX-pipelines, har det lagdelte atlaset ingen direkte ekvivalent i tradisjonelle CGI-arbeidsflyter, siden det essensielt utgjør et ‘tidsbasert teksturkart’ som kan produseres og redigeres gjennom tradisjonelle programvaremetoder. I det andre bildet i illustrasjonen ovenfor, er bakgrunnen av veiens overflate representert (figurativt) over hele kjøretiden til videoen. Å endre dette grunnbildet (tredje bildet fra venstre i illustrasjonen ovenfor) produserer en konsistent endring i bakgrunnen.
Bildene av det ‘utbrettede’ atlaset ovenfor viser bare enkeltstående tolkede bilderuter. Konsistente endringer i en hvilken som helst bilderute i målvideoen kartlegges tilbake til den opprinnelige ruten, samtidig som nødvendige tildekkinger og andre påkrevde sceneeffekter, som skygger og refleksjoner, bevares.
Kjernearkitekturen bruker et flerlagsperseptron (MLP) til å representere de utbrettede atlasene, alfakanalene og kartleggingene. Alt optimaliseres samlet og utelukkende i et todimensjonalt rom. Dermed trengs ikke forhåndskunnskap om 3D-geometripunkter, dybdekart og lignende CGI-strukturer slik NeRF-baserte metoder forutsetter.
Referanseatlaset for enkeltobjekter kan også pålitelig endres:
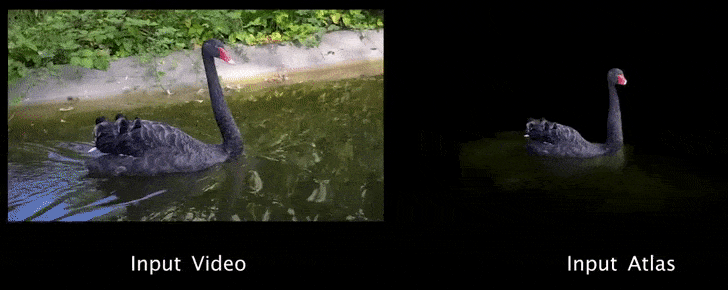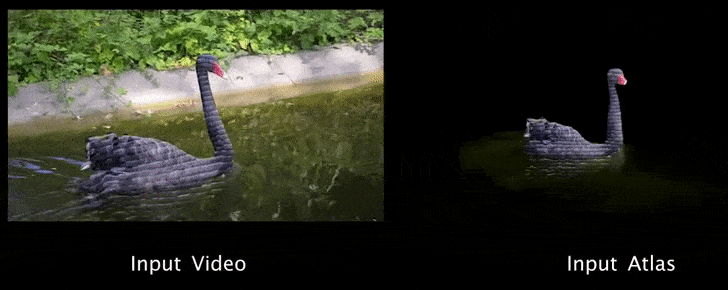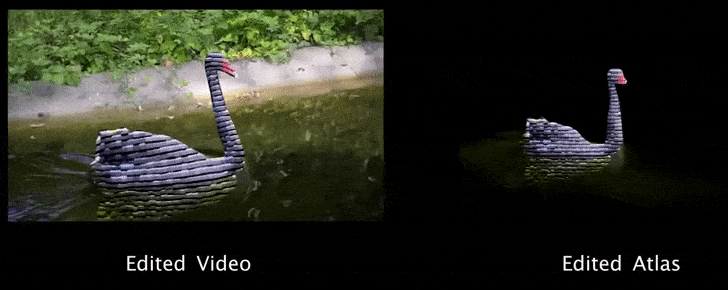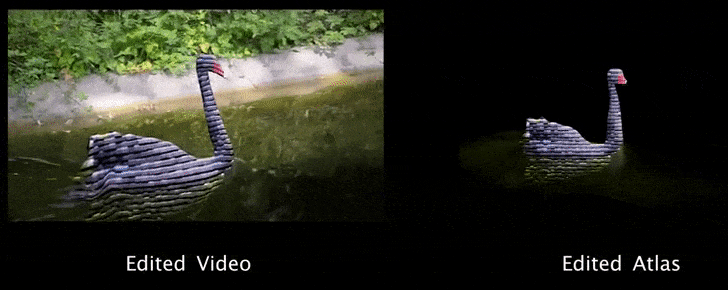
Konsistent endring av et bevegelig objekt under 2021-rammeverket. Kilde: https://www.youtube.com/watch?v=aQhakPFC4oQ
Essensielt kombinerer 2021-systemet geometri-justering, match-moving, kartlegging, re-teksturisering og rotoscoping i en diskret neural prosess.
Text2Live
De tre opprinnelige forskerne bak forskningsartikkelen fra 2021, sammen med NVIDIA (NVDA ) Research, er blant bidragsyterne til en ny innovasjon på teknikken som kombinerer kraften av lagdelte atlas med den type tekst-guidet CLIP-teknologi som har kommet tilbake i søkelyset denne uken med OpenAI’s utgivelse av DALL-E 2-rammeverket.
Den nye arkitekturen, med navnet Text2Live, tillater en sluttbruker å lage lokale redigeringer av faktisk videoinnhold basert på tekst-prompt:
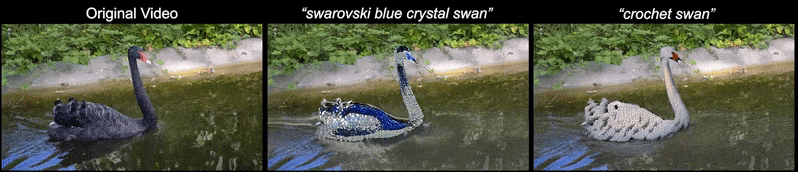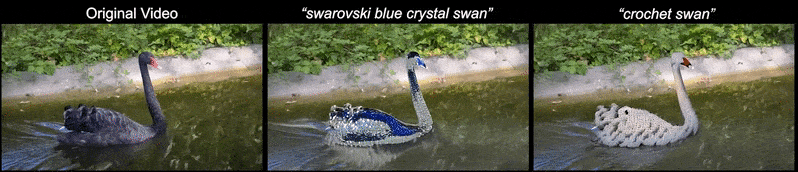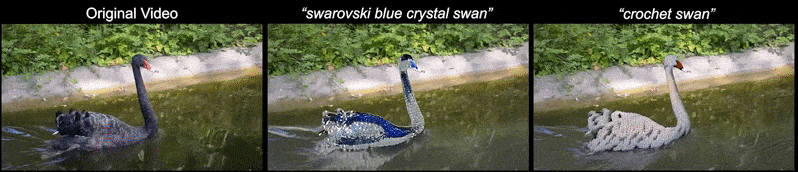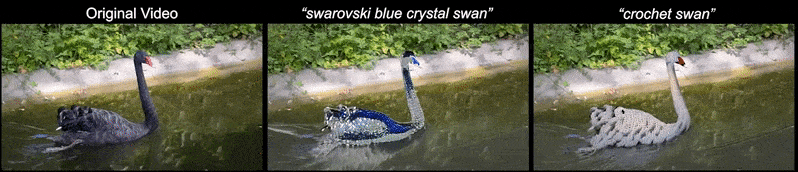
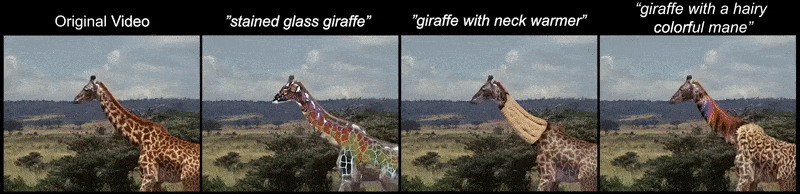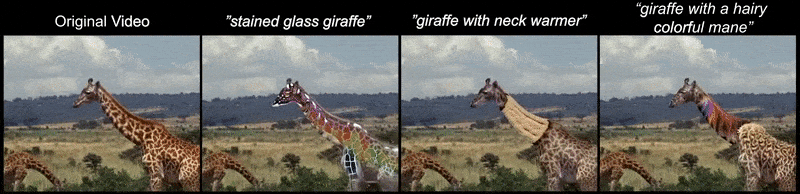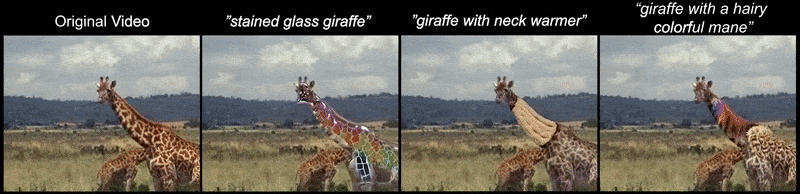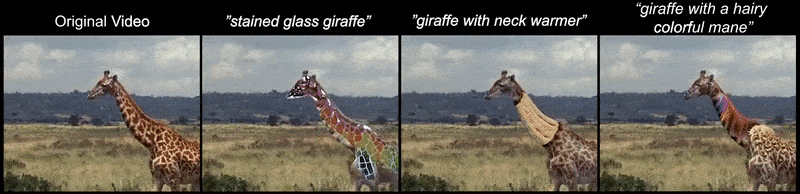
To eksempler på forgrunnredigering. For bedre oppløsning og skarphet, sjekk ut de originale videoene på https://text2live.github.io/sm/pages/video_results_atlases.html
Text2Live tilbyr semantisk og svært lokal redigering uten å bruke en forhånds-trent generator, ved å bruke en intern database som er spesifikk for video-klippet som påvirkes.

Bakgrunn og forgrunn (objekt) transformasjoner under Text2Live. Kilde: https://text2live.github.io/sm/pages/video_results_atlases.html
Teknikken krever ikke bruker-tilbudte masker, som en typisk rotoscoping eller grønn-skjerm-arbeidsflyt, men heller estimerer relevans-kart gjennom en bootstrapping-teknikk basert på 2021-forskning fra The School of Computer Science at Tel Aviv University og Facebook AI Research (FAIR).

Utgangskart generert via en transformer-basert generisk oppmerksomhetsmodell.
Den nye forskningsartikkelen har tittelen Text2LIVE: Text-Driven Layered Image and Video Editing. Omer Bar-Tal fra Weizmann og Yoni Kasten fra NVIDIA Research har sluttet seg til det opprinnelige teamet fra 2021.
Arkitektur
Text2Live består av en generator trent på ett enkelt inndatabilde og mål-tekst-prompt. En Contrastive Language-Image Pretraining (CLIP) modell forhånds-trent på 400 millioner tekst/bilde-par gir assosiert visuelt materiale fra hvilket bruker-innputt-transformasjoner kan tolkes.

Generatoren tar imot et inndatabilde, altså en bilderute, og produserer et RGBA-mållag med informasjon om farge og ugjennomsiktighet. Dette laget er deretter komponert inn i den opprinnelige filmen med ekstra augmentasjoner.

Alfa-kanalen i det genererte RGBA-laget gir en intern komposisjonsfunksjon uten å gå til tradisjonelle pipelines som involverer piksel-basert programvare som After Effects.
Ved å trene på interne bilder som er relevante for mål-videoen eller bildet, unngår Text2Live å måtte invertere innputt-bildet inn i latent-rommet til en Generative Adversarial Network (GAN), en praksis som for tiden er langt ifra nøyaktig nok for produksjonsvideo-redigering-krav, eller å bruke en Diffusjonsmodell som er mer presis og konfigurerbar, men kan ikke opprettholde trofasthet til mål-videoen.

Forskjellige prompt-basert transformasjonsredigeringer fra Text2Live.
Tidligere tilnærminger har enten brukt propagasjonsbaserte metoder eller optisk flyt-basert tilnærminger. Siden disse teknikkene er til en viss grad basert på enkeltbilder, er ingen av dem i stand til å skape en konsistent temporel fremtoning av endringer i utgangs-videoen. Et lagdelt nevralt atlas gir derimot ett felles rom der endringer kan håndteres, slik at resultatet forblir tro mot den valgte endringen mens videoen fortsetter.
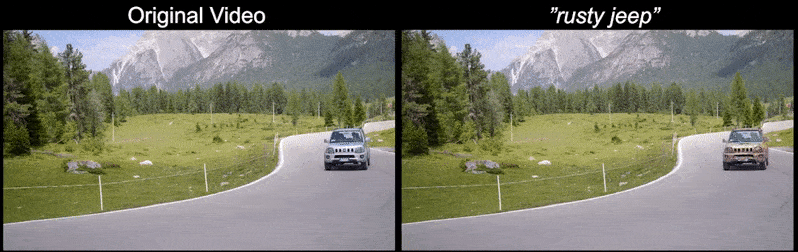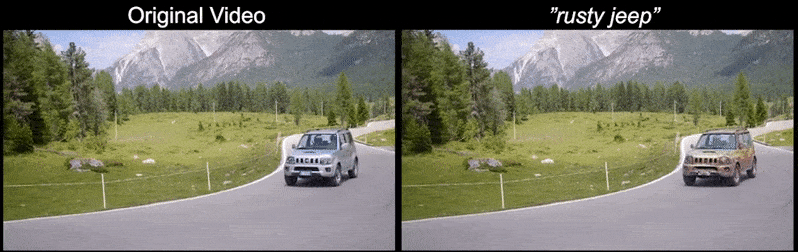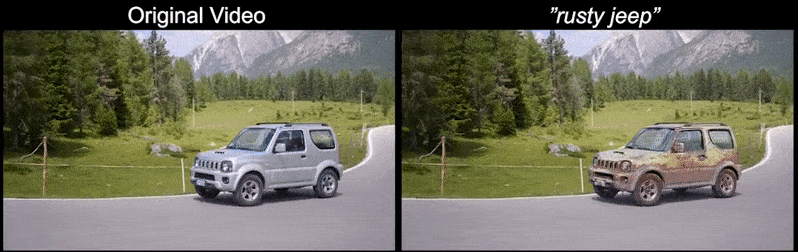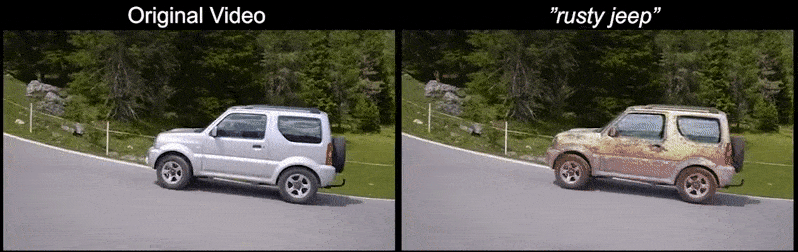
Ingen flimring eller tilfeldige hallucinasjoner: Text2Live får en tolkning av tekst-prompten ‘rusty jeep’, og anvender den en gang til det lagdelte nevrale atlaset av bilen i videoen, i stedet for å starte om transformasjonen for hver tolket ramme.

Arbeidsflyt av Text2Lives konsistente transformasjon av en Jeep til en rusten levning.
Text2Live er nærmere et gjennombrudd i AI-basert komposisjon, enn i det fruktbare tekst-til-bilde-feltet som har tiltrukket så mye oppmerksomhet denne uken med utgivelsen av den andre generasjon av OpenAI’s DALL-E-rammeverk (som kan inkorporere mål-bilder som en del av den transformative prosessen, men forblir begrenset i sin evne til å gripe direkte inn i et bilde, i tillegg til sensur av kildedata til trening og pålegg av filtre, designet for å forhindre bruker-misbruk).
Text2Live tillater derimot sluttbrukeren å trekke ut en atlas og deretter redigere den i én omgang i pikselbaserte miljøer med høy grad av kontroll som Photoshop (og kanskje enda mer abstrakt bilde-syntese-rammeverk som NeRF), før atlaset mates tilbake inn i et korrekt-orientert miljø som likevel ikke avhenger av 3D-estimering eller CGI-baserte tilnærminger som vender tilbake til eldre metoder.
Text2Live, hevder forfatterne, er det første sammenlignbare rammeverket som oppnår masking og komposisjon på en fullstendig automatisk måte.
Publisert første gang 7. april 2022.





