
AI-modeller og plattformer
Nye ferdiglagde (OTS) datasett fra Appen akselerer AI-utvikling

 Legg til Unite.AI blant dine foretrukne kilder på Google
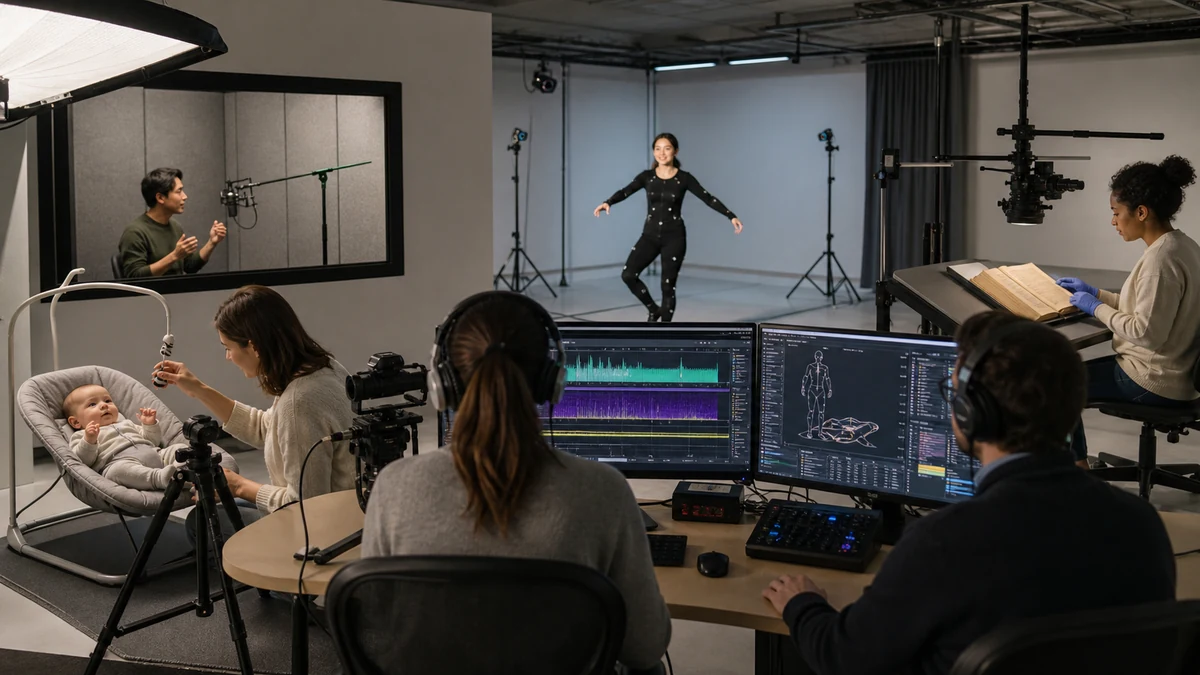
Appen Limited (ASX:APX), den ledende leverandøren av høykvalitets treningdata for organisasjoner som bygger effektive AI-systemer i stor skala, annonserte i dag nye ferdiglagde (OTS) datasett. Disse datasettene er designet for å gjøre det enklere og raskere for bedrifter å skaffe den høykvalitets treningdata som trengs for å akselerere deres kunstig intelligens (AI) og maskinlæring (ML)-prosjekter. De nye OTS-datasettene inkluderer menneskekroppsbevegelser og innovative babyskrik-lyder, samt skriptet tale og bilder med tekst som er egnet for optisk tegngjenkjenning (OCR) for høyt etterspurt, men vanskelig å skaffe språk, som arabisk, kroatisk, gresk, ungarsk, thai og mer. Med de utvidede datasettene, inkluderer Appens totale OTS-tilbud over 250 datasett, som består av over 11 000 timer med lyd, over 25 000 bilder og over 8,7 millioner ord på 80 språk og flere dialekter.
Appens OTS-datasett er et raskt og kostnadseffektivt verktøy for å starte et AI- eller ML-prosjekt med konsistent høykvalitets treningdata. Team som utvider sine AI-kapasiteter, kan også benytte OTS-datasett for å effektivt forbedre nøyaktigheten, utvikle nye modellferdigheter og innføre andre forbedringer i deres AI-modeller. Et OTS-datasett leveres ofte på en uke, for eksempel, sammenlignet med åtte til tolv uker for et nytt datasettsamling- og annoteringsprosjekt – eller enda lenger, avhengig av kompleksiteten. Alle Appen-datasett er utviklet med en fullt gjennomsiktig, frivillig metode, så AI-eksperter kan være sikre på at deres data er ren og samstemt, og eliminerer den potensielle risikoen for bakslag og omdømmeskade.
“AI-team over hele verden som arbeider med prosjekter med stramme frister og fleksible datakrav, kan dra nytte av å bruke ferdiglagde datasett,” sa Wilson Pang, CTO i Appen. “OTS-datasett forkorter tiden til verdi og gir tilgang til høykvalitetsdata til en lavere total kostnad enn tradisjonelle metoder. Vi i Appen tar de nødvendige skrittene for å sikre at alle våre datasett er etisk kilde og demografisk balansert, og muliggjør at selskaper kan opprettholde ansvarlige AI-praksiser ved å minimere bias i deres modeller og sikre rettferdig behandling av dataannotatorer. Du vet alltid den nøyaktige kvaliteten på et OTS-datasett, som hjelper med å bygge bedre AI som fungerer i den virkelige verden.”
MediaInterface har levert språkteknologiløsninger til helse-relaterte institusjoner i Tyskland og andre deler av Europa i over 20 år. Da selskapet utvidet til Frankrike, hadde de fullstendig lokalisiert programvare, men manglet fransk leksikondata, spesielt franske navn og steder, som ofte er referert til i pasienthelseinformasjon. Ved å bruke Appen OTS-datasett, skaffet MediaInterface seg omtrent 21 000 franske navn og 14 000 stedsnavn. “Den kritiske data fra Appen er inkorporert i vår bakgrunnsleksikon for å lykkes med lansering i et nytt marked, og dette hjelper oss med å bygge ut nye vokabularer for våre kunder og styrke vår tilnærming for fremtidige markeds Lanseringer også,” sa Ines Wendler, produktmanager i MediaInterface.
De mest erfarne AI-ekspertene kombinerer OTS-datasett med på forespørsel datainnsamling og annoteringsprosjekter for å møte deres komplekse AI-modell treningdatabehov. Appen er ledende i å tilby kontinuerlig støtte gjennom en rekke spesifikke datainnsamlingstjenester, som pågående dataannotering og smart merking, gjennom AI-drevne verktøy og automatiserte arbeidsflyter for å maksimere effektiviteten.
“Vi interagerer med AI fra det øyeblikk vi våkner til det øyeblikk vi legger oss til å sove – gjennom virtuelle assistenter, chatboter, søkemotorer, sosiale nettverk, medisinske enheter, smarte biler og andre applikasjoner,” sa Judith Bishop, Appens senior direktør for AI-eksperter, som leder et team på 100 AI-lingvister og språkeksperter. “Språk er ofte den primære grensesnittet for mange av disse overbevisende AI-bruksfallene, så for å garantere en god opplevelse, må modellen være trenet for å fungere for alle. Appens forpliktelse til høykvalitetsdata og ansvarlig, etisk AI-utvikling tillater selskaper som kjøper våre ferdiglagde datasett å akselerere sine AI-prosjekter med full tillit til deres data.”
I tillegg til de eksisterende hundrevis av datasett som allerede er tilgjengelige på appen.com, inkluderer listen over nye Appen OTS-datasett som nå er tilgjengelige:
- Skriptet tale for arabisk (Egypt), arabisk (Saudi-Arabia), arabisk (De forente arabiske emirater), sentral khmer (Kambodsja), kroatisk, gresk, ungarsk, polsk, spansk (Spania) og tyrkisk
- Bilde OCR for forenklet kinesisk trykt tekst, thai trykt tekst og finsk trykt tekst – Inkluderer forhåndsinnspilte plakater, ytre emballasje, skilt, magasiner og menyene for å trene og oppdatere datamaskin-syns OCR-modeller
- Menneskekroppsbevegelser (Kina) – Inkluderer annoterte videoer av mennesker som beveger seg, sporet på pikselnivå, egnet for spillutvikling, fitnesapps og mer
- Babyskrik-lyd (Kina) – Inkluderer forhåndsinnspilte og annoterte babyskrik-lyder som kan brukes til å trene AI-modeller til å gjenkjenne forskjellige skrik-lyder og varsle foreldre
For mer informasjon og å be om en Appen OTS-datasett-prøve, klikk her.


