
AI-modeller og plattformer
Inn i OpenAI sine o3 og o4-mini: Å låse opp nye muligheter gjennom multimodalt resonnement og integrerte verktøysett

 Legg til Unite.AI blant dine foretrukne kilder på Google
Den 16. april 2025 lanserte OpenAI oppgraderte versjoner av sine avanserte resonnementmodeller. Disse nye modellene, kalt o3 og o4-mini, tilbyr forbedringer over sine forgjengere, o1 og o3-mini, henholdsvis. De siste modellene leverer forbedret ytelse, nye funksjoner og større tilgjengelighet. Denne artikkelen utforsker de primære fordelene med o3 og o4-mini, kartlegger deres hovedfunksjoner og diskuterer hvordan de kan påvirke fremtiden for AI-applikasjoner. Men før vi dykker ned i hva som gjør o3 og o4-mini spesielle, er det viktig å forstå hvordan OpenAI sine modeller har utviklet seg over tid. La oss begynne med en kort oversikt over OpenAI sitt arbeid med å utvikle stadig kraftigere språk- og resonnementssystemer.
OpenAI sitt utvikling av store språkmodeller
OpenAI sitt arbeid med å utvikle store språkmodeller begynte med GPT-2 og GPT-3, som førte ChatGPT inn i mainstream-bruk på grunn av deres evne til å produsere flytende og kontekstuell nøyaktig tekst. Disse modellene ble bredt brukt til oppgaver som sammenfatting, oversettelse og spørsmålssvar. Imidlertid, da brukerne anvendte dem til mer komplekse scenarioer, ble deres svakheter tydelige. Disse modellene hadde ofte vanskeligheter med oppgaver som krevde dypt resonnement, logisk konsistens og flertrinns problemløsning. For å møte disse utfordringene, introduserte OpenAI GPT-4, og skiftet fokus mot å forbedre resonnementsevnen til sine modeller. Dette skiftet ledet til utviklingen av o1 og o3-mini. Begge modellene brukte en metode kalt chain-of-thought-prompting, som tillot dem å generere mer logiske og nøyaktige svar ved å resonnere trinnvis. Mens o1 er designet for avanserte problemløsningsbehov, er o3-mini bygget for å levere lignende funksjoner på en mer effektiv og kostnadseffektiv måte. Bygget på denne grunnlaget, har OpenAI nå introdusert o3 og o4-mini, som ytterligere forbedrer resonnementsevnen til deres LLM-er. Disse modellene er konstruert for å produsere mer nøyaktige og velfunderede svar, spesielt i tekniske fag som programmering, matematikk og vitenskapelig analyse – områder hvor logisk presisjon er kritisk. I den følgende seksjonen vil vi undersøke hvordan o3 og o4-mini forbedrer sine forgjengere.
Nøkkel-forbedringer i o3 og o4-mini
Forbedret resonnementsevne
En av de viktigste forbedringene i o3 og o4-mini er deres forbedrede resonnementsevne for komplekse oppgaver. I motsetning til tidligere modeller som leverte raskere svar, tar o3 og o4-mini-modellene mer tid til å prosessere hver prompt. Denne ekstra prosesseringen tillater dem å resonnere mer grundig og produsere mer nøyaktige svar, noe som fører til bedre resultater på benchmark. For eksempel, o3 overgår o1 med 9% på LiveBench.ai, en benchmark som vurderer ytelse over flere komplekse oppgaver som logikk, matematikk og kode. På SWE-benchmark, som tester resonnement i software-ingeniør-oppgaver, oppnådde o3 en score på 69,1%, og overgikk selv konkurransemodeller som Gemini 2.5 Pro, som fikk en score på 63,8%. I mellomtiden fikk o4-mini en score på 68,1% på samme benchmark, og tilbød nesten samme resonnement dybde til en mye lavere kostnad.
Multimodalt integrering: Tenkning med bilder
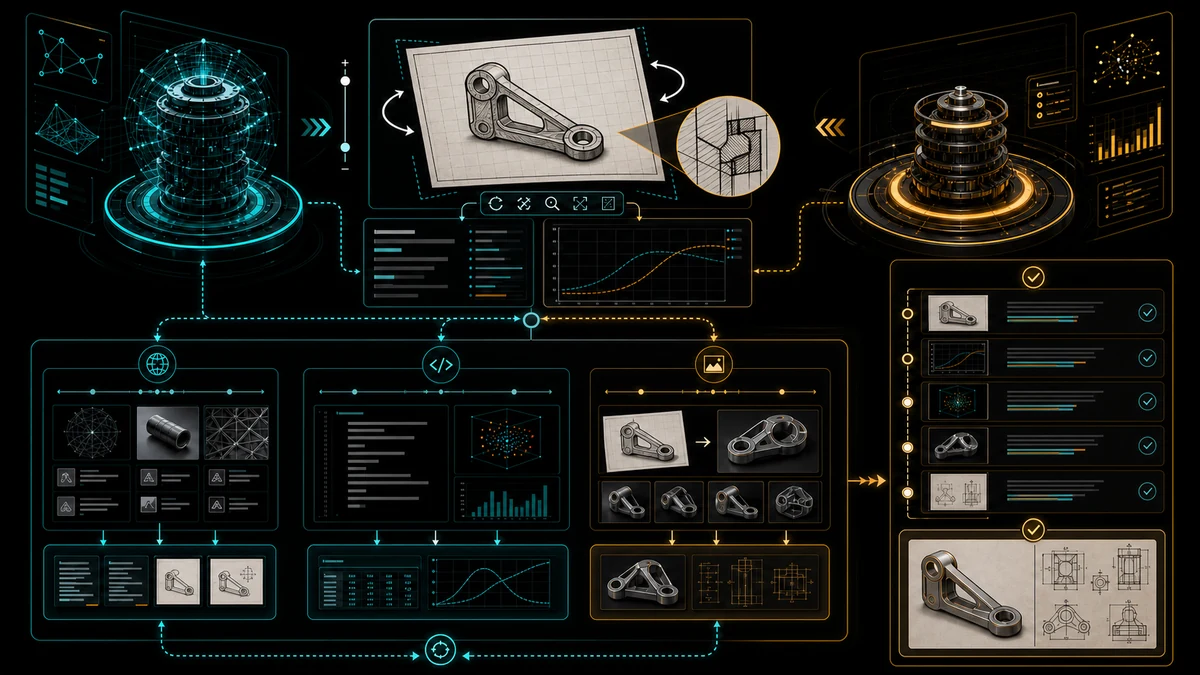
En av de mest innovative funksjonene i o3 og o4-mini er deres evne til å “tenke med bilder”. Dette betyr at de ikke bare kan prosessere tekstinformasjon, men også integrere visuell data direkte i deres resonnementprosess. De kan forstå og analysere bilder, selv om de er av lav kvalitet – som håndskrevne notater, skisser eller diagrammer. For eksempel, kunne en bruker laste opp et diagram av et komplekst system, og modellen kunne analysere det, identifisere potensielle problemer eller til og med foreslå forbedringer. Denne funksjonen broer gapet mellom tekst- og visuell data, og muliggjør mer intuitive og omfattende interaksjoner med AI. Begge modellene kan utføre handlinger som å zoome inn på detaljer eller rotere bilder for bedre å forstå dem. Dette multimodale resonnement er en betydelig forbedring over forgjengere som o1, som hovedsakelig var tekstbasert. Det åpner opp nye muligheter for applikasjoner i fag som utdanning, hvor visuelle hjelpemidler er avgjørende, og forskning, hvor diagrammer og kart er ofte sentrale for å forstå.
Avansert verktøybruk
o3 og o4-mini er de første OpenAI-modellene som bruker alle verktøyene som er tilgjengelige i ChatGPT samtidig. Disse verktøyene inkluderer:
- Nettsøking: som tillater modellene å hente den siste informasjonen for tidskritiske spørsmål.
- Python-kodekøyring: som muliggjør komplekse beregninger eller dataanalyse.
- Bildebehandling og generering: som forbedrer deres evne til å arbeide med visuell data.
Ved å anvende disse verktøyene, kan o3 og o4-mini løse komplekse, flertrinns problemer mer effektivt. For eksempel, hvis en bruker stiller et spørsmål som krever aktuell data, kan modellen utføre en nettsøking for å hente den siste informasjonen. Liksom for oppgaver som involverer dataanalyse, kan den kjøre Python-kode for å prosessere dataene. Denne integreringen er et viktig skritt mot mer autonome AI-agenter som kan håndtere en bredere rekke oppgaver uten menneskelig inngripen. Introduksjonen av Codex CLI, en lettvekts, åpen kildekode-agent som fungerer med o3 og o4-mini, forbedrer ytterligere deres nytte for utviklere.
Konsekvenser og nye muligheter
Lanseringen av o3 og o4-mini har vidtrekkende konsekvenser over industrier:
- Utdanning: Disse modellene kan assistere studenter og lærere ved å gi detaljerte forklaringer og visuelle hjelpemidler, og gjøre læring mer interaktiv og effektiv. For eksempel, kunne en student laste opp en skisse av et matematisk problem, og modellen kunne gi en trinnvis løsning.
- Forskning: De kan akselerere oppdagelse ved å analysere komplekse datasæt, generere hypoteser og tolke visuell data som diagrammer og kart, som er uvurderlige for fag som fysikk eller biologi.
- Industri: De kan optimere prosesser, forbedre beslutningstaking og forbedre kundeinteraksjoner ved å håndtere både tekst- og visuelle spørsmål, som analyse av produktutforming eller feilsøking av tekniske problemer.
- Kreativitet og media: Forfattere kan bruke disse modellene til å omdanne kapitteloversikter til enkle storyboards. Musikkere kan sammenligne visuelle med en melodi. Filmredigeringer mottar pacing-forslag. Arkitekter kan omdanne håndtegnete gulvplaner til detaljerte 3D-utkast som inkluderer struktur- og bærekraftsnotater.
- Tilgjengelighet og inklusjon: For blinde brukere beskriver modellene bilder i detalj. For døve brukere konverterer de diagrammer til visuelle sekvenser eller undertekst. Deres oversettelse av både ord og visuelle data hjelper til å brokke språk- og kulturelle gap.
- Mot autonome agenter: Fordi modellene kan søke på nettet, kjøre kode og prosessere bilder i én arbeidsflyt, danner de grunnlaget for autonome agenter. Utviklere beskriver en funksjon; modellen skriver, tester og distribuerer koden. Kunnskapsarbeidere kan delegere datainnsamling, analyse, visualisering og rapportering til en enkelt AI-assistent.
Begrensninger og hva som kommer neste
Til tross for disse forbedringene, har o3 og o4-mini fortsatt en kunnskapskutt i august 2023, som begrenser deres evne til å svare på de nyeste hendelser eller teknologier med mindre de suppleres med nettsøking. Fremtidige iterasjoner vil sannsynligvis møte denne gapen ved å forbedre sanntidsdatainnsamling.
Vi kan også forvente videre fremgang i autonome AI-agenter – systemer som kan planlegge, resonnere, handle og lære kontinuerlig med minimal overvåking. OpenAI sitt integrering av verktøy, resonnementmodeller og sanntidsdata-tilgang signaliserer at vi nærmer oss slike systemer.
Bunnen av saken
OpenAI sine nye modeller, o3 og o4-mini, tilbyr forbedringer i resonnement, multimodalt forståelse og verktøyintegrering. De er mer nøyaktige, fleksible og nyttige over en bred rekke oppgaver – fra å analysere komplekse data og generere kode til å tolke bilder. Disse forbedringene har potensialet til å betydelig forbedre produktivitet og akselerere innovasjon over ulike industrier. timodal forståelse, og verktøyintegrering. De er mer nøyaktige, fleksible og nyttige over en bred rekke oppgaver – fra å analysere komplekse data og generere kode til å tolke bilder. Disse forbedringene har potensialet til å betydelig forbedre produktivitet og akselerere innovasjon over ulike industrier.





