
AI-modeller og plattformer
DIRFA Transformerer Lydclipp til Livlige Digitale Ansikter

 Legg til Unite.AI blant dine foretrukne kilder på Google
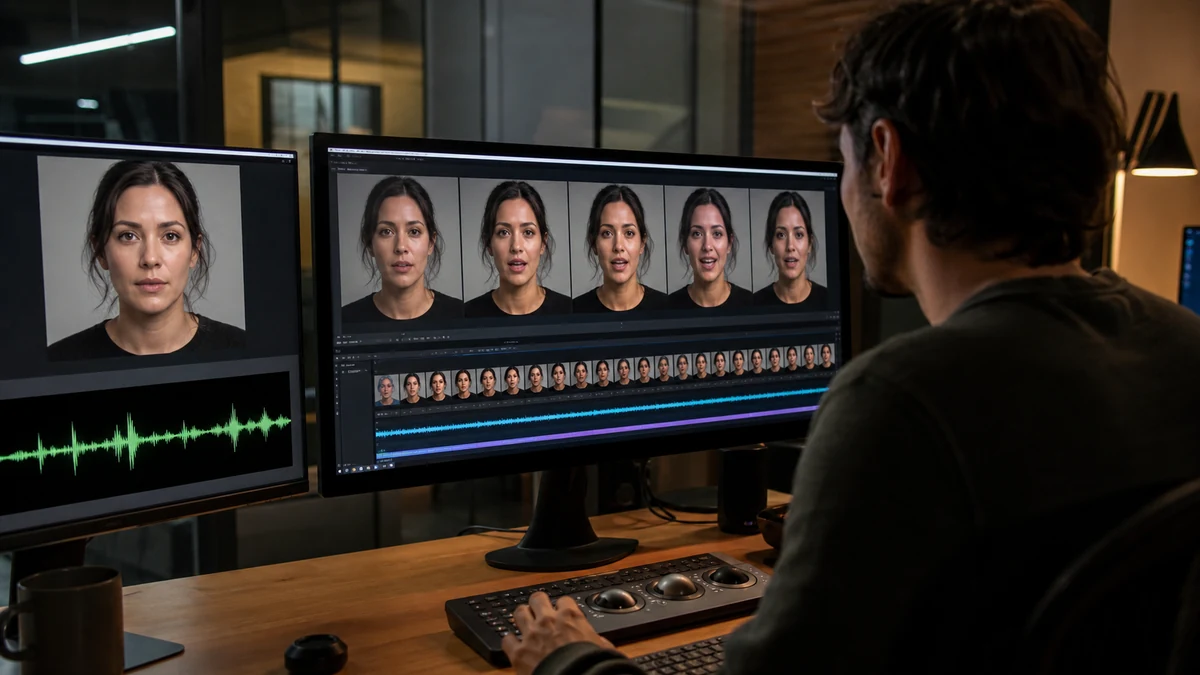
I et bemerkelsesverdig sprang fremover for kunstig intelligens og multimediakommunikasjon, har et team av forskere ved Nanyang Technological University, Singapore (NTU Singapore) avduket et innovativt dataprogram kalt DIRFA (Mangfoldige og Realistiske Ansiktsanimasjoner).
Dette AI-baserte gjennombruddet demonstrerer en imponerende evne: å transformere en enkel lydclip og et statisk ansiktsbilde til realistiske, 3D-animerte videoer. Videoene viser ikke bare nøyaktig lippsynkronisering med lyden, men også en rik variasjon av ansiktsuttrykk og naturlige hodebevegelser, og presses grensene for digital medieproduksjon.
Utviklingen av DIRFA
Kjernen i DIRFAs funksjonalitet ligger i dens avanserte algoritme som sømløst kombinerer lydinput med fotografi for å generere tredimensjonale videoer. Ved å nøye analysere talemønster og toner i lyden, forutsier og replikerer DIRFA intelligently tilhørende ansiktsuttrykk og hodebevegelser. Dette betyr at den resulterende videoen portretterer taleren med en høy grad av realisme, deres ansiktsbevegelser perfekt synkronisert med nyansene i deres talte ord.
DIRFAs utvikling markerer en betydelig forbedring over tidligere teknologier i dette området, som ofte kjempet med kompleksiteten av varierende posisjoner og emosjonelle uttrykk.
Tradisjonelle metoder kjempet vanligvis for å nøyaktig replikere nyansene av menneskelige emosjoner eller var begrenset i deres evne til å håndtere forskjellige hodeposisjoner. DIRFA, derimot, utmerker seg i å fange en bred variasjon av emosjonelle nyanser og kan tilpasse seg forskjellige hodeorienteringer, og tilbyr et mye mer variert og realistisk utgang.
Dette fremsteget er ikke bare et skritt fremover i AI-teknologi, men åpner også opp nye horisonter i hvordan vi kan samhandle med og utnytte digital media, og gir en glimt inn i en fremtid der digital kommunikasjon tar på seg en mer personlig og uttrykksfull karakter.
Trening og Teknologi Bak DIRFA
DIRFAs evne til å replikere menneskelignende ansiktsuttrykk og hodebevegelser med så stor nøyaktighet er et resultat av en omfattende treningprosess. Teamet ved NTU Singapore trente programmet på en massiv datasett – over en million audiovisuelle klipp fra VoxCeleb2 Dataset.
Dette datasettet omfatter en mangfoldig rekke av ansiktsuttrykk, hodebevegelser og talemønster fra over 6 000 individer. Ved å eksponere DIRFA for så stor og variert samling av audiovisuelle data, lærte programmet å identifisere og replikere de fine nyansene som kjennetegner menneskelige uttrykk og tale.
Associate Professor Lu Shijian, den korresponderende forfatteren av studien, og Dr. Wu Rongliang, den første forfatteren, har delt verdifulle innsikter i betydningen av deres arbeid.
“Virkningen av vår studie kan være dyptgående og langtrekkende, ettersom den revolusjonerer området for multimediakommunikasjon ved å muliggjøre skapelsen av høyt realistiske videoer av individer som taler, kombinert med teknikk som AI og maskinlæring”, sa Assoc. Prof. Lu. “Vårt program bygger også på tidligere studier og representerer en fremgang i teknologien, ettersom videoene skapt med vårt program er komplette med nøyaktige lippebevegelser, levende ansiktsuttrykk og naturlige hodeposisjoner, kun ved hjelp av deres lydopptak og statiske bilder.”
Dr. Wu Rongliang la til, “Tale utgjør en mangfold av variasjoner. Individer uttaler de samme ordene forskjellig i ulike kontekster, inkludert variasjoner i varighet, amplitude, tone og mer. Videre, forbi dens lingvistiske innhold, taler rik informasjon om talerens emosjonelle tilstand og identitetsfaktorer som kjønn, alder, etnisitet og selv personlighetstrekk. Vår tilnærming representerer en pionerinnsats i å forbedre ytelsen fra perspektivet av audio-representasjonslæring i AI og maskinlæring.”

Sammenligninger av DIRFA med state-of-the-art audio-drevne taleansikts-genererings-tilnærminger. (NTU Singapore)
Potensielle Anvendelser
En av de mest lovende anvendelsene av DIRFA er i helseindustrien, spesielt i utviklingen av sofistikerte virtuelle assistenter og chatboter. Med dens evne til å skape realistiske og responsive ansiktsanimasjoner, kan DIRFA betydelig forbedre brukeropplevelsen i digitale helseplattformer, gjøre interaksjoner mer personlige og engasjerende. Denne teknologien kan være avgjørende i å tilby emosjonell trøst og personlig omsorg gjennom virtuelle medier, et kritisk aspekt som ofte mangler i nåværende digitale helse løsninger.
DIRFA har også enormt potensial i å hjelpe individer med tale- eller ansiktsfunksjons-hemmeligheter. For de som møter utfordringer i verbal kommunikasjon eller ansiktsuttrykk, kan DIRFA fungere som et kraftig verktøy, muliggjøre dem å uttrykke sine tanker og følelser gjennom uttrykksfulle avatarer eller digitale representasjoner. Den kan forbedre deres evne til å kommunisere effektivt, bro til gapet mellom deres intensjoner og uttrykk. Ved å tilby en digital måte å uttrykke seg på, kan DIRFA spille en avgjørende rolle i å muliggjøre disse individene, og gi dem en ny måte å samhandle og uttrykke seg i den digitale verden.
Ufordringer og Fremtidige Retninger
Å skape livlige ansiktsuttrykk kun fra lydinput presenterer en kompleks utfordring i feltet AI og multimediakommunikasjon. DIRFAs nåværende suksess i dette området er bemerkelsesverdig, men kompleksiteten av menneskelige uttrykk betyr at det alltid er rom for forbedring. Hver enkelt individs talemønster er unikt, og deres ansiktsuttrykk kan variere dramatisk selv med samme lydinput. Å fange denne mangfoldigheten og finheten forblir en nøkkelutfordring for DIRFA-teamet.
Dr. Wu anerkjenner visse begrensninger i DIRFAs nåværende iterasjon. Spesifikt, programmet grensesnitt og graden av kontroll det tilbyr over uttrykksuttrykk, trenger forbedring. For eksempel, evnen til å justere bestemte uttrykk, som å endre et surt uttrykk til et smil, er en begrensning de sikter til å overvinne. Å håndtere disse begrensningene er avgjørende for å utvide DIRFAs anvendelighet og bruker-tilgjengelighet.
I fremtiden planlegger NTU-teamet å forbedre DIRFA med en mer mangfoldig rekke av datasett, inkludert en bredere rekke av ansiktsuttrykk og tale-lyd-klipp. Denne utvidelsen forventes å ytterligere forfine nøyaktigheten og realisme av ansiktsanimasjonene generert av DIRFA, gjøre dem mer varierte og tilpassede til forskjellige kontekster og anvendelser.
DIRFAs Virkning og Potensiale
DIRFA, med sin banebrytende tilnærming til å syntetisere realistiske ansiktsanimasjoner fra lyd, er klar til å revolusjonere området for multimediakommunikasjon. Denne teknologien presser grensene for digital interaksjon, utvisker grensen mellom den digitale og fysiske verden. Ved å muliggjøre skapelsen av nøyaktige, livlige digitale representasjoner, forbedrer DIRFA kvaliteten og autentisiteten av digital kommunikasjon.
Fremtiden for teknologier som DIRFA i å forbedre digital kommunikasjon og representasjon er vid og spennende. Ettersom disse teknologiene fortsetter å utvikle seg, lover de å tilby mer immersive, personlige og uttrykksfulle måter å samhandle i den digitale rommet.
Du kan finne den publiserte studien her.


