
Andersons vinkel
Deteksjon av øyekontakt fra kroppsholdning med maskinlæring

 Legg til Unite.AI blant dine foretrukne kilder på Google
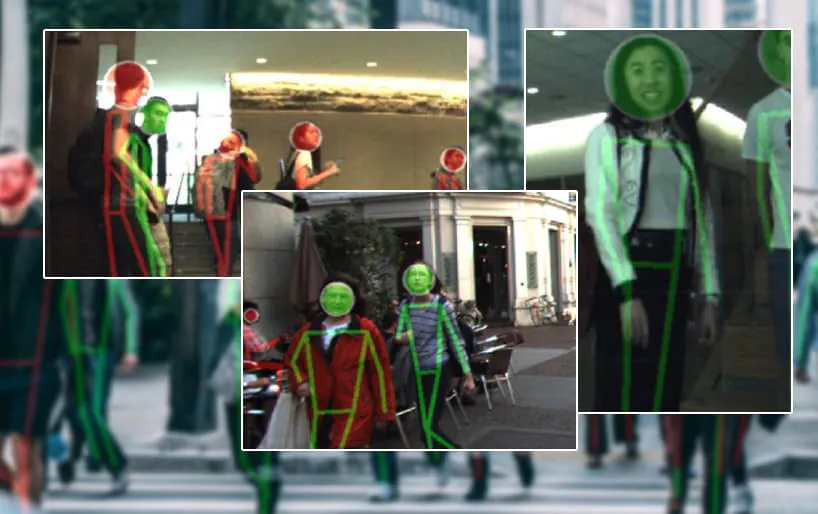
Forskere fra Frankrike og Sveits har utviklet et datavisjonssystem som kan anslå om en person ser direkte på ‘ego’-kameraet i et AI-system basert bare på måten personen står eller beveger seg på.
Det nye rammeverket bruker svært redusert informasjon for å gjøre denne vurderingen, i form av semantiske nøkkelord (se bildet under), snarere enn å forsøke å analysere øyeposisjon i bilder av ansikter. Dette gjør den resulterende deteksjonsmetoden svært lett og smidig, i sammenligning med mer dataintensive objektdetekteringsarkitekturer, som YOLO.
<img class="wp-image-179268 size-full" src="https://www.unite.ai/wp-content/uploads/2021/12/semantic-keypoints.jpg" alt="Det nye rammeverket vurderer om en person på gaten ser på AI-sensoren, basert bare på kroppsholdningen. Her er personer som er merket med grønt sannsynligvis å se på kameraet, mens de som er merket med rødt er mer sannsynlig å se bort. Kilde: https://arxiv.org/pdf/2112.04212.pdf
Selv om arbeidet er motivert av utviklingen av bedre sikkerhetssystemer for autonome kjøretøy, innrømmer forfatterne av den nye artikkelen at det kan ha mer generelle anvendelser i andre industrier, og observerer ‘selv i smarte byer kan øyekontaktdeteksjon være nyttig for å bedre forstå fotgjengeres atferd, f.eks. å identifisere hvor deres oppmerksomhet går eller hva offentlige skilt de ser på’.
For å hjelpe med videre utvikling av dette og senere systemer, har forskerne samlet en ny og omfattende datasett kalt LOOK, som direkte adresserer de spesifikke utfordringene med øyekontaktdeteksjon i vilkårlige scenarioer som gatebilder sett fra et selvkjørende kjøretøys kamera, eller uformelle folkemengder som en robot må navigere gjennom og vike for fotgjengeres vei.

Resultater fra rammeverket, med ‘seere’ identifisert med grønt.
Forskningen hele artikkelen heter Do Pedestrians Pay Attention? Eye Contact Detection in the Wild, og kommer fra fire forskere ved Visual Intelligence for Transportation (VITA) forskningsinitiativet i Sveits, og en ved Sorbonne Université.
Arkitektur
De fleste tidligere arbeider i dette feltet har vært sentrert på sjåfør oppmerksomhet, ved å bruke maskinlæring til å analysere utgangen av sjåfør-rettede kamere, og avhengig av en konstant, fast og nærvær av sjåføren – en luksus som ikke er sannsynlig å være tilgjengelig i de ofte lav-oppløste strømmene av offentlige TV-kameraer, hvor personer kan være for langt borte for et ansiktsanalyse-system å løse deres øyedisposisjon, og hvor andre forstyrrelser (som solbriller) også kommer i veien.
Mer sentral til prosjektets uttalt mål, vil de utvendige kameraene i autonome kjøretøy ikke nødvendigvis være i en optimal scenario heller, gjør ‘lav-nivå’ nøkkelinformasjon ideell som grunnlag for en blikkanalyse-rammeverk. Autonome kjøretøysystemer trenger en svært responsiv og lyn-rask måte å forstå om en fotgjenger – som kan gå av fortauet inn i kjøretøyets vei – har sett AV. I en slik situasjon kan forsinkelse bety forskjellen mellom liv og død.
Den modulære arkitekturen utviklet av forskerne tar inn et (vanligvis) fullkroppsbilde av en person fra hvilken 2D-ledd er trukket ut i en base, skjelettform.

Arkitekturen til det nye fransk-sveitsiske øyekontaktdetekteringssystemet.
Holdningen er normalisert for å fjerne informasjon på Y-aksen, for å skape en ‘flat’ representasjon av holdningen som setter den i likhet med de tusenvis av kjente holdninger som er lært av algoritmen (som også har blitt ‘flattet’), og deres assosierte binære flagg/merker (dvs. 0: Ikke ser eller 1: Ser).
Holdningen sammenlignes mot algoritmens interne kunnskap om hvordan godt denne posturen korresponderer med bilder av andre fotgjengere som har blitt identifisert som ‘ser på kamera’ – annotasjoner gjort ved hjelp av egendefinerte nettleser-verktøy utviklet av forfatterne for Amazon Mechanical Turk-arbeiderne som deltok i utviklingen av LOOK-datasettet.
Hver bilde i LOOK var underlagt skråning av fire AMT-arbeidere, og bare bilder hvor tre av fire var enige om utfallet ble inkludert i den endelige samlingen.
Hodekropps-informasjon, kjernen i mye tidligere arbeid, er blant de minst pålitelige indikatorene for blikk i vilkårlige by-scenarioer, og er inkludert som en valgfri datastrøm i arkitekturen hvor opptakskvaliteten og dekningen er tilstrekkelig til å støtte en beslutning om hvorvidt personen ser på kameraet eller ikke. I tilfelle av svært fjerntliggende personer, vil dette ikke være nyttig informasjon.
Data
Forskere har avledet LOOK fra flere tidligere datasett som ikke er tilgjengelige for denne oppgaven. De to datasettene som direkte deler prosjektets ambisjon er JAAD og PIE, og hver har begrensninger.
JAAD er et tilbud fra 2017 fra York University i Toronto, som inneholder 390 000 merkte eksempler på fotgjengere, inkludert bounding-bokser og atferdsannotering. Av disse er bare 17 000 merket som ser på sjåføren (dvs. ego-kameraet). Datasettet har 346 30fps-klipp som kjører i 5-10 sekunder av on-board kameraopptak registrert i Nord-Amerika og Europa. JAAD har en høy forekomst av gjentakelser, og det totale antallet unike fotgjengere er bare 686.
Den mer nylige (2019) PIE, fra York University i Toronto, er lignende JAAD, i det at det inneholder on-board 30fps-opptak, denne gangen avledet fra seks timers kjøring gjennom downtown Toronto, som gir 700 000 annoterte fotgjengere og 1 842 unike fotgjengere, hvor bare 180 ser på kameraet.
I stedet har forskerne for den nye artikkelen samlet den mest egnede data fra tre tidligere autonome kjøretøydatasett: KITTI, JRDB og NuScenes, henholdsvis fra Karlsruhe Institute of Technology i Tyskland, Stanford og Monash University i Australia, og en tidligere MIT-spin-off Nutonomy.
Denne kurasjonen resulterte i en svært diversifisert samling av opptak fra fire byer – Boston, Singapore, Tübingen og Palo Alto. Med rundt 8000 merkte fotgjengerperspektiver, hevder forfatterne at LOOK er det mest diverse datasettet for ‘i villmark’ øyekontaktdeteksjon.
Trening og resultater
Ekstraksjon, trening og evaluering ble alle utført på en enkelt NVIDIA GeForce GTX 1080ti med 11gb VRAM, som opererte på en Intel Core i7-8700 CPU som kjørte på 3,20GHz.
Forfatterne fant at ikke bare deres metode forbedrer SOTA-baselinjer med minst 5%, men også at de resulterende modellene som er trent på JAAD generaliserer svært godt til usette data, en scenario testet ved å blande en rekke datasett.
Ettersom testingen som ble utført var kompleks, og måtte gjøre provisjon for crop-baserte modeller (mens ansiktsisolering og cropping ikke er sentrale i det nye initiativets arkitektur), se artikkelen for detaljerte resultater.

Resultater for gjennomsnittlig nøyaktighet (AP) som prosent og funksjon av bounding-boks høyde i piksler for testing over JAAD-datasettet, med forfatterens resultater i fet skrift.
Forskere har gjort koden offentlig tilgjengelig, med datasettet tilgjengelig her, og kildekoden på GitHub.
Forfatterne konkluderer med håp om at deres arbeid vil inspirere videre forskningsinnsats i hva de beskriver som en ‘viktig men oversett tema’.


