
Andersons vinkel
‘Kreativ’ Ansiktverifisering med Generative Adversarial Networks

 Legg til Unite.AI blant dine foretrukne kilder på Google

En ny artikkel fra Stanford University har foreslått en ny metode for å lure ansiktsgodkjennelsessystemer på plattformer som dating-apper, ved å bruke en Generative Adversarial Network (GAN) til å lage alternative ansiktsbilder som inneholder samme essensielle ID-informasjon som et ekte ansikt.
Metoden bypasset med hell ansiktsgodkjennelsesprosesser på dating-applikasjonene Tinder og Bumble, og i ett tilfelle ble sogar en kjønnsbyttet (mannlig) ansikt godkjent som ekte for den opprinnelige (kvinnelige) identiteten.

Forskjellige genererte identiteter som inneholder den spesifikke kodingen av artikkelforfatterens (avbildet i første bilde ovenfor). Kilde: https://arxiv.org/pdf/2203.15068.pdf
Ifølge forfatteren representerer arbeidet det første forsøket på å bypass ansiktsgodkjennelse med bruk av genererte bilder som har blitt innført med spesifikke identitetsstrekk, men som forsøker å representere en alternativ eller vesentlig endret identitet.
Teknikken ble testet på et eget lokalt ansiktsgodkjennelsessystem, og fungerte godt i black box-tester mot to dating-applikasjoner som utfører ansiktsgodkjennelse på brukerlastede bilder.
Den nye artikkelen heter Ansiktsgodkjennelse Bypass, og kommer fra Sanjana Sarda, en forsker ved avdelingen for elektroteknikk ved Stanford University.
Kontroll av Ansiktsrommet
Selv om “injeksjon” av ID-spesifikke trekk (dvs. fra ansikter, veiskilt osv.) inn i konstruerte bilder er en standardprosess i adversarial angrep, foreslår den nye studien noe annet: at forskningssektorens økende evne til å kontrollere den latente rommet i GANer vil til slutt muliggjøre utviklingen av arkitekturer som kan lage konsekvente alternative identiteter til en bruker – og, effektivt, muliggjøre uttrekk av identitetsstrekk fra web-tilgjengelige bilder av en uforberedt bruker for å innlemme i en “skygge”-konstruert identitet.
Konsistens og navigasjon har vært de primære utfordringene når det gjelder den latente rommet i GAN siden oppfinnelsen av Generative Adversarial Networks. En GAN som har suksessfullt assimilert en samling av treningsbilder inn i sitt latente rom tilbyr ingen enkel kart for å “pushe” trekk fra en klasse til en annen.
Mens teknikker og verktøy som Gradient-weighted Class Activation Mapping (Grad-CAM) kan hjelpe med å etablere latente retninger mellom de etablerte klassene, og muliggjøre transformasjoner (se bilde under), gjør den ytterligere utfordringen av entanglement vanligvis for en “approximativ” reise, med begrenset fin kontroll over overgangen.
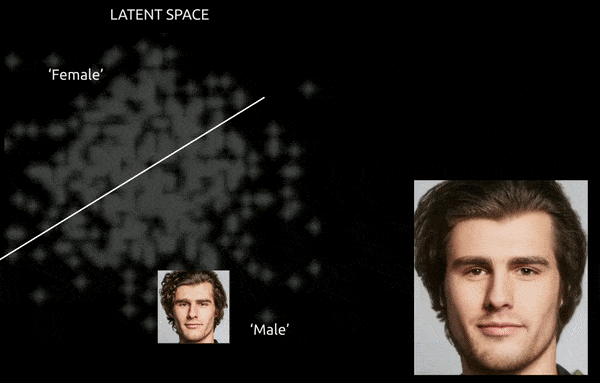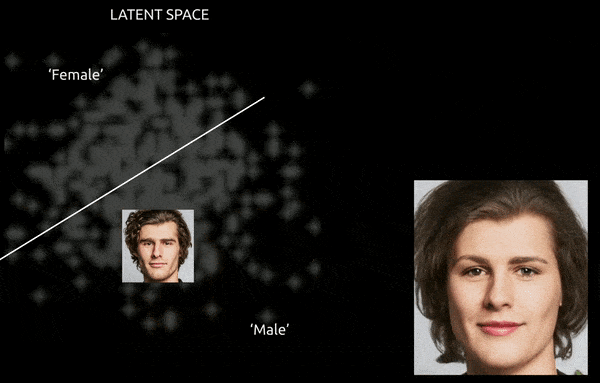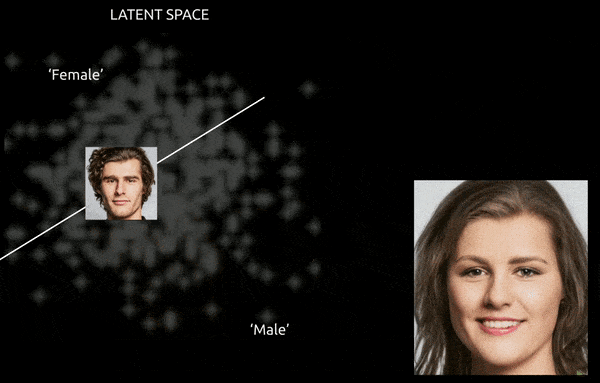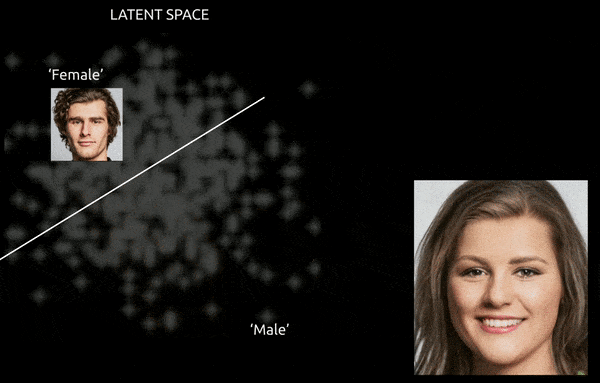
En grov reise mellom kodete vektorer i en GANs latente rom, som presser en data-avledet mannlig identitet inn i “kvinne”-kodingene på den andre siden av en av mange lineære hyperplaner i det komplekse og arkane latente rommet. Bildefilet hentet fra materiale på https://www.youtube.com/watch?v=dCKbRCUyop8
Evnen til å “fryse” og beskytte ID-spesifikke trekk mens de flyttes inn i transformative kodinger andre steder i det latente rommet kan muliggjøre å lage en konsekvent (og sogar animert) enkeltindivid hvis identitet leses av maskinsystemer som noen andre.
Metode
Forfatteren brukte to datasett som basis for eksperimenter: et Human User Dataset bestående av 310 bilder av hennes ansikt over en periode på fire år, med varierende lys, alder og vinkel), med avkortede ansikter trukket ut via Caffe; og det rasebalanserte 108 501 bildene i FairFace-datasettet, trukket ut og avkortet på samme måte.
Det lokale ansiktsgodkjennelsesmodellen ble avledet fra en basisimplementering av FaceNet og DeepFace, forhåndstrener på ConvNet Inception, med hver bilde representert av en 128-dimensjonal vektor.
Tilnærmingen bruker ansiktsbilder fra et trent undersett fra FairFace. For å passere ansiktsgodkjennelse, blir den beregnede avstanden forårsaket av et bilde sitt Frobenius-norm justert mot målbrukeren i databasen. Enhver bilde under terskelen på 0,7 tilsvarer samme identitet, ellers anses godkjennelse for å ha feilet.
En StyleGAN-modell ble finjustert på forfatterens personlige datasett, og produserte en modell som ville generere gjenkjennelige variasjoner av hennes identitet, selv om ingen av disse genererte bildene var identiske med treningsdataene. Dette ble oppnådd ved å fryse de fire første lagene i diskriminatoren, for å unngå overfitting av dataene og produsere varierte utdata.
Selv om diverse bilder ble oppnådd med den grunnleggende StyleGAN-modellen, førte den lave oppløsningen og troverdigheten til et nytt forsøk med StarGAN V2, som tillater trening av seed-bilder mot et målansikt.
StarGAN V2-modellen ble forhåndstrener over omtrent 10 timer ved hjelp av FairFace-valideringssettet, på en batch-størrelse på fire og en valideringsstørrelse på åtte. I den mest suksessfulle tilnærmingen, ble forfatterens personlige datasett brukt som kilde med treningsdata som referanse.
Verifiserings-eksperimenter
Et ansiktsgodkjennelsesmodell ble konstruert basert på en undergruppe på 1000 bilder, med intensjonen å verifisere et vilkårlig bilde fra settet. Bilder som passerte verifisering suksessfullt, ble deretter testet mot forfatterens eget ID.

Til venstre, artikkelforfatteren, et ekte foto; midten, et vilkårlig bilde som feilet verifisering; høyre, et ubeslektet bilde fra datasettet som passerte verifisering som forfatteren.
Målet med eksperimentene var å skape så stor en åpning som mulig mellom den opplevde visuelle identiteten, samtidig som de essensielle trekkene til målidentiteten ble beholdt. Dette ble evaluert med Mahalanobis-avstand, en metode brukt i bildebehandling for mønster- og mal-søk.
For den grunnleggende generative modellen, viser de lav-oppløste resultater begrensede variasjoner, til tross for at de passerte lokal ansiktsgodkjennelse. StarGAN V2 viste seg å være mer i stand til å lage diverse bilder som kunne autentisere.

Alle bildene avbildet passerte lokal ansiktsgodkjennelse. Ovenfor er de lav-oppløste StyleGAN-basismodellene, under er de høy-oppløste og høykvalitets StarGAN V2-modellene.
De tre siste bildene ovenfor brukte forfatterens eget ansiktsdatasett både som kilde og referanse, mens de foregående bildene brukte treningsdata som referanse og forfatterens datasett som kilde.
De resulterende genererte bildene ble testet mot ansiktsgodkjennelsessystemene på dating-applikasjonene Bumble og Tinder, med forfatterens identitet som basis, og passerte verifisering. En “mannlig” generering av forfatterens ansikt passerte også Bumbles verifisering, selv om lyset måtte justeres i det genererte bildet før det ble akseptert. Tinder aksepterte ikke den mannlige versjonen.

Mannlige versjoner av forfatterens (kvinnelige) identitet.
Konklusjon
Disse er seminale eksperimenter i identitetsprosjeksjon, i sammenheng med GANs latente rommanipulasjon, som fortsatt er en ekstraordinær utfordring i bilde-syntese og deepfake-forskning. Likevel åpner arbeidet opp for konseptet om å innlemme svært spesifikke trekk konsekvent over diverse identiteter, og å lage “alternative” identiteter som “leses” som noen andre.
Først publisert 30. mars 2022.


