Grunnleggende AI
Koding og AI: En nybegynners vei inn i kunstig intelligens

 Legg til Unite.AI blant dine foretrukne kilder på Google
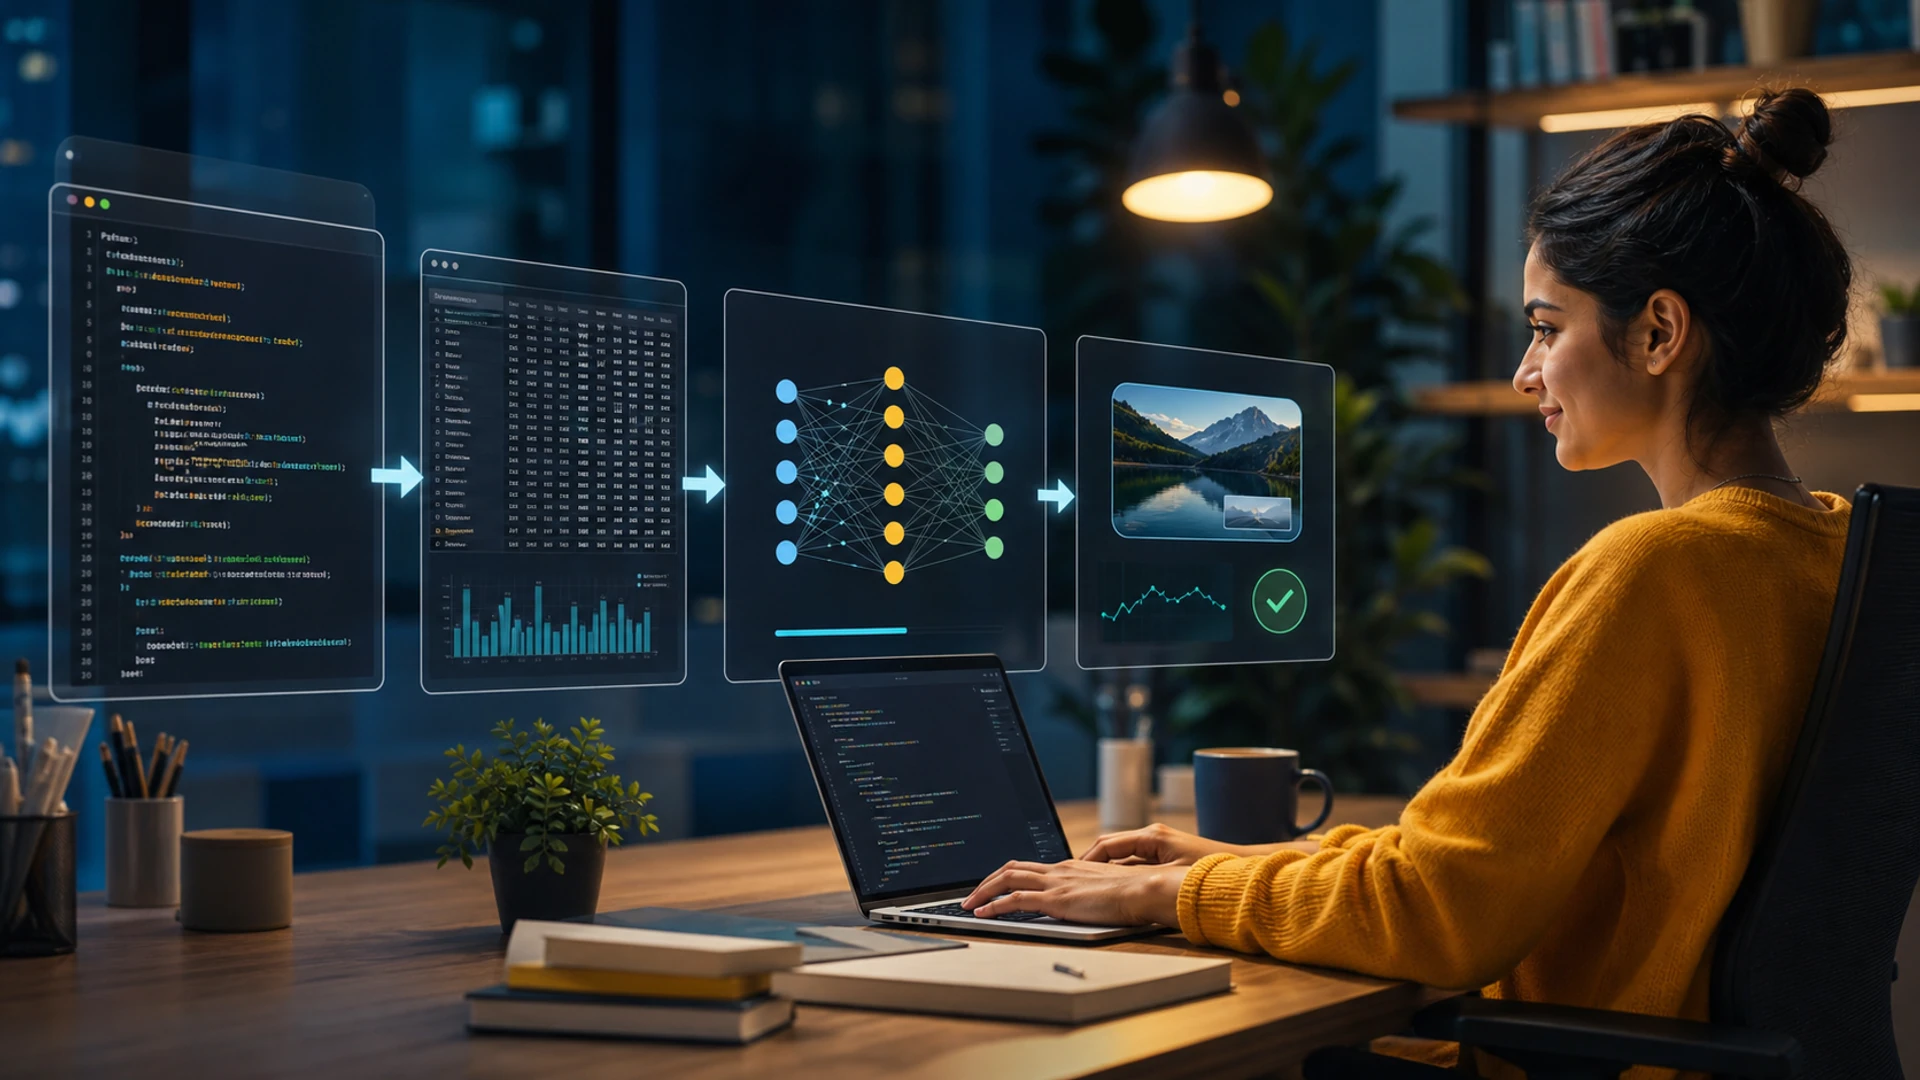
Du kan begynne å lære AI uten tidligere profesjonell programmeringserfaring, men for å bygge pålitelige systemer kreves etter hvert tilstrekkelig kode‑, data‑ og evalueringskompetanse til å inspisere hva verktøyene gjør. Den raskeste veien er en liten sekvens av prosjekter knyttet til grunnleggende konsepter i stedet for en lang reise gjennom uavhengige opplæringsprogrammer.
AI‑assistert koding kan forklare syntaks, generere eksempler og hjelpe med feilsøking. Behandle resultatet som et utkast: kjør det, test det, les dokumentasjonen, og forstå dataene og tillatelsene før du stoler på det.
Nøkkelpunkter
- Lær grunnleggende Python, notatbøker, Git, kommandolinjen og hvordan du leser feil.
- Bygg ett lite prosjekt med overvåket læring før du hopper til agenter eller store modeller.
- Bruk trenings‑, validerings‑ og testdata korrekt; sammenlign med en enkel basislinje.
- La AI assistere tilbakemeldingssløyfen, men verifiser kode, kilder, lisenser, sikkerhet og resultater selv.
Trinn 1: programmeringsgrunnlag
Lær variabler, samlinger, betingelser, løkker, funksjoner, moduler, filer, miljøer og unntak. Øv på å lese en CSV, transformere poster, kalle et dokumentert API, skrive en test og bruke Git for å spore endringer.
Du trenger ikke avansert matematikk før du skriver kode, men du bør lære grunnleggende sannsynlighet, vektorer, gjennomsnitt, fordelinger og grafer etter hvert som de blir relevante. Computational thinking hjelper med å omforme et vagt mål til testbare steg.
Trinn 2: et komplett ML‑prosjekt
Velg et lite offentlig datasett og et tydelig prediksjonsspørsmål. Utforsk dataene, lag en uavhengig deling, bygg en basislinje, tren en enkel modell, inspiser feil, og noter begrensninger. Bruk scikit-learn før et tilpasset nevralt nettverk når det passer.
Dette prosjektet gjør machine-learning-konsepter konkrete: funksjoner, etiketter, lekkasje, overtilpasning, måleparametre, reproduserbarhet, og forskjellen mellom en modellscore og en nyttig beslutning.
Trinn 3: dyp læring og språkmodeller
Lær tensorer, batcher, tap, gradientnedstigning og tilbakepropagering gjennom en liten bilde‑ eller tekstmodell. Bruk deretter en forhåndstrent modell via et API eller et åpent bibliotek, registrer prompt og versjoner, og sammenlign den med en enklere metode.
Utforsk generative AI gjennom en avgrenset applikasjon med gjenfinning eller verktøybruk. Legg til validering, sitater, tillatelser og fallback slik at prosjektet lærer systemteknikk i tillegg til prompting.
Bruk AI‑kodeassistenter bevisst
Be om små funksjoner, tester, forklaringer, kanttilfeller og dokumentasjonsreferanser. Kjør statiske sjekker og tester, gjennomgå avhengighetsendringer, og lim aldri inn hemmeligheter eller private data uten autorisasjon. Hvis du ikke kan forklare en kritisk linje, bremse ned.
En nyttig portefølje viser spørsmålet, datarettigheter, basislinje, metode, evaluering, feil og hva du ville forbedre. Ferdige, dokumenterte små prosjekter demonstrerer mer dømmekraft enn kopiert kode fra en stor demonstrasjon.
En praktisk læringsvei fra problem til prototype
Start med en spesifikk oppgave og et lite sett av representative eksempler i stedet for en bred ambisjon om å ‘lære AI.’ Å klassifisere støttemeldinger, trekke ut fakturafelter eller svare på spørsmål fra godkjente dokumenter gir observerbare innganger og utganger. Beskriv hvordan et godt resultat ser ut før du velger modell eller verktøy.
Ingen‑kode‑grensesnitt kan lære prompting, datapreparering, evaluering og arbeidsflytdesign, men de fjerner ikke behovet for teknisk dømmekraft. Lær tabeller, filer, API‑er, autentisering, variabler, betingelser og grunnleggende statistikk. Disse konseptene forklarer hvordan data beveger seg, hvorfor integrasjoner feiler, og hva et modellresultat betyr – og ikke betyr.
Bygg en basislinje med en enkel regel, søkemetode, regneark eller liten modell. Sammenlign deretter en AI‑tilnærming på de samme testtilfellene. En basislinje viser om kompleksitet tilfører verdi og gir nybegynnere et konkret feilsøkingsmål. Hold testdata adskilt fra eksempler som brukes til å konfigurere eller prompt systemet.
Prompting, API‑er og overgangen til kode
En nyttig prompt angir oppgaven, relevant kontekst, begrensninger, utdata‑skjema og eksempler når det er nødvendig. Prompt‑endringer er programvareendringer: versjonér dem, test dem mot et fast evalueringssett, og inspiser feil. Ikke betrakt flytende forklaringer fra modellen som bevis på at svaret eller den siterte evidensen er korrekt.
Arbeidsflyt‑byggere kobler modellkall til skjemaer, databaser, filer og forretningsapplikasjoner. Forstå hvilke data hvert steg sender til tredjeparter, hvordan legitimasjon lagres, og hva som skjer ved tidsavbrudd eller gjentakelse. Legg til inndata‑validering, strukturerte utdata, hastighetsbegrensninger, menneskelig godkjenning og logger før du bruker en prototype med ekte brukere.
Kode blir verdifull når arbeidsflyten krever egendefinert logikk, repeterbare tester, skalerbarhet, ytelse, portabilitet eller detaljerte sikkerhetskontroller. Python og JavaScript er vanlige inngangspunkter, men språket er mindre viktig enn grunnleggende kunnskaper: funksjoner, datastrukturer, pakker, feil, versjonskontroll og tester. Bruk generert kode kun etter at du har lest den og kjørt den på en sikker måte.
Porteføljeprosjekter, evaluering og karriereutvikling
Et solid nybegynnerprosjekt dokumenterer problemet, brukerne, datatillatelser, basislinje, arkitektur, evalueringssett, måleparametre, feil, risikoer og neste steg. Et polert grensesnitt uten evaluering viser mindre enn et lite, reproduserbart eksperiment. Fjern private data og hemmeligheter før du publiserer kode, skjermbilder, prompt eller logger.
Evaluer oppgavens suksess i stedet for modellens imponerende egenskaper. Klassifisering krever klasse‑spesifikk presisjon og tilbakekalling; uttrekk krever feltnøyaktighet; gjenfinning krever evidensdekning; generering krever faktualitet, nytte, sikkerhet, latency og kostnad. Gå gjennom ytelse på tvers av språk, kanttilfeller og berørte grupper, og definer når et menneske må ta avgjørelsen.
AI‑arbeid inkluderer produktledelse, domenekompetanse, data‑operasjoner, evaluering, design, sikkerhet, retningslinjer og endringsledelse i tillegg til modellutvikling. Bygg dybde i ett domene og tilstrekkelig teknisk forståelse til å samarbeide på tvers av roller. Troverdige porteføljer forklarer avveininger og begrensninger i stedet for å presentere hver prototype som produksjonsklar automatisering.
Arbeids‑eksempel: en nybegynner bygger en dokument‑triage‑assistent
En lærende samler et lite sett med offentlige eller tillatte dokumenter og definerer tre kategorier pluss et ‘usikkert’ resultat. De merker eksempler ved hjelp av en skriftlig regel, reserverer et testsett, og implementerer en nøkkelord‑basislinje i et regneark. En ingen‑kode‑modell eller API returnerer deretter en strukturert kategori og tillit, som sammenlignes med de samme tilfellene. Feilaktige og tvetydige eksempler blir læringsmaterialet, ikke noe skjult i en demonstrasjon.
Arbeidsflyten godtar en fil, ekstraherer tekst, fjerner ikke‑støttede formater, kaller modellen med et fast skjema, validerer svaret, og sender usikre tilfeller til gjennomgang. Den lagrer kun nødvendige felter og inkluderer aldri legitimasjon i prompt eller delte skjermbilder. Lærende registrerer modellnavn, prompt‑versjon, latency, kostnad og utdata slik at endringer kan testes i stedet for å bli vurdert fra hukommelsen.
En portefølje‑rapport beskriver presisjon og tilbakekalling per klasse, personverns‑antakelser, feil‑eksempler og grensen mellom prototype og produksjon. Neste kode‑steg kan erstatte en skjør manuell integrasjon med en liten testet funksjon eller API. Denne progresjonen lærer overførbare ferdigheter: problemdefinisjon, datakvalitet, evaluering, grensesnitt, feil‑håndtering, sikkerhet og kommunikasjon. Disse grunnprinsippene betyr mer enn å hevde at man har bygget en sofistikert agent etter ett vellykket eksempel.
Praktisk implementeringssjekkliste
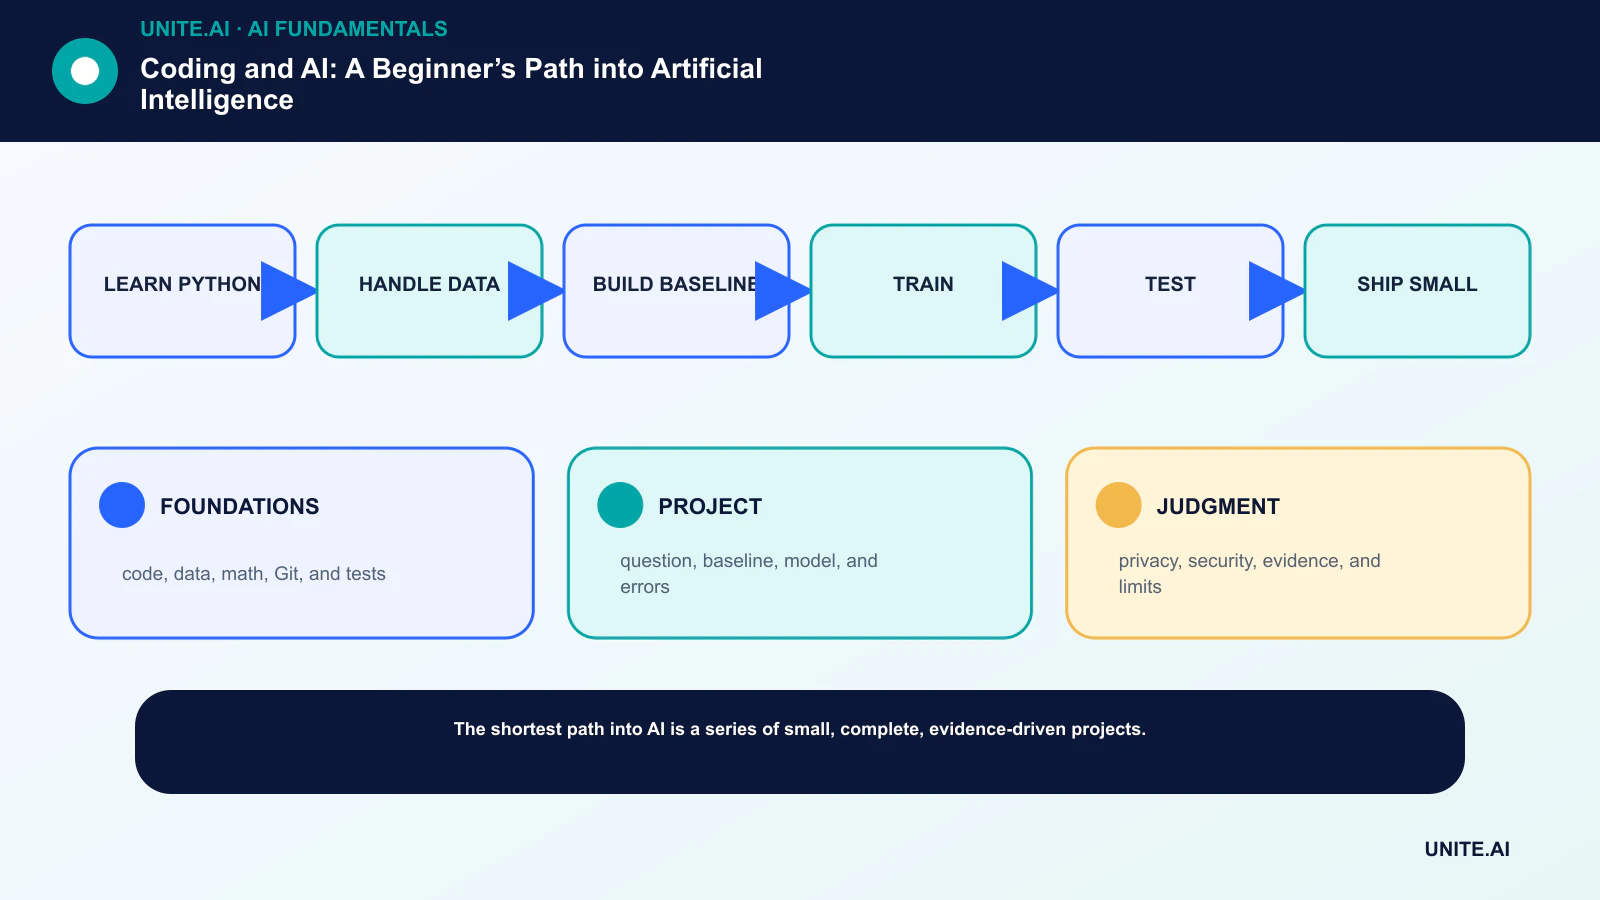
Gjør konseptet til en avgrenset, testbar arbeidsflyt: lær python → håndter data → bygg basislinje → tren → test → lever smått. Navngi en ansvarlig eier, dokumenter dataene og avhengighetene, etabler en enkel basislinje, sett aksept‑ og stoppkriterier, test representative feil, og definer overvåking, tilbakeføring og gjennomgang før du utvider omfanget. Registrer versjoner og forutsetninger slik at et annet team kan gjenskape resultatet og forstå hva som har endret seg.
Før lansering, gjennomfør en dokumentert beredskapsgjennomgang med personene som bygger, drifter, sikrer og påvirkes av systemet. Test normale tilfeller, grensetilstander, avhengighets‑feil og misbruk; bevar evidensen og uløste risikoer. Definer hvem som kan godkjenne utgivelse, endre en terskel, overstyre en utdata eller stoppe driften. Gå gjennom beslutningen på nytt når virkelige data ankommer, fordi en teknisk vellykket pilot ikke garanterer pålitelig ytelse i større skala.
- GRUNNLAG: kode, data, matematikk, Git og tester.
- PROSJEKT: spørsmål, basislinje, modell og feil.
- SKJØNN: personvern, sikkerhet, evidens og grenser.
Ofte stilte spørsmål
Trenger jeg en datavitenskapsgrad for å jobbe med AI?
Nei. Roller inkluderer ingeniørarbeid, forskning, produkt, design, drift, data, evaluering, policy og domenekompetanse. Hver rolle har ulik dybde i kodekrav.
Hvilket programmeringsspråk bør en nybegynner lære?
Python er et praktisk førstevalg fordi syntaksen er lett å forstå og økosystemet for data og ML er omfattende. De underliggende problemløsningsferdighetene overføres til andre språk.
Primære referanser