

AI-modeller og plattformer
AniPortrait: Lyd-drevet syntese av fotorealistiske portrettanimasjoner

 Legg til Unite.AI blant dine foretrukne kilder på Google
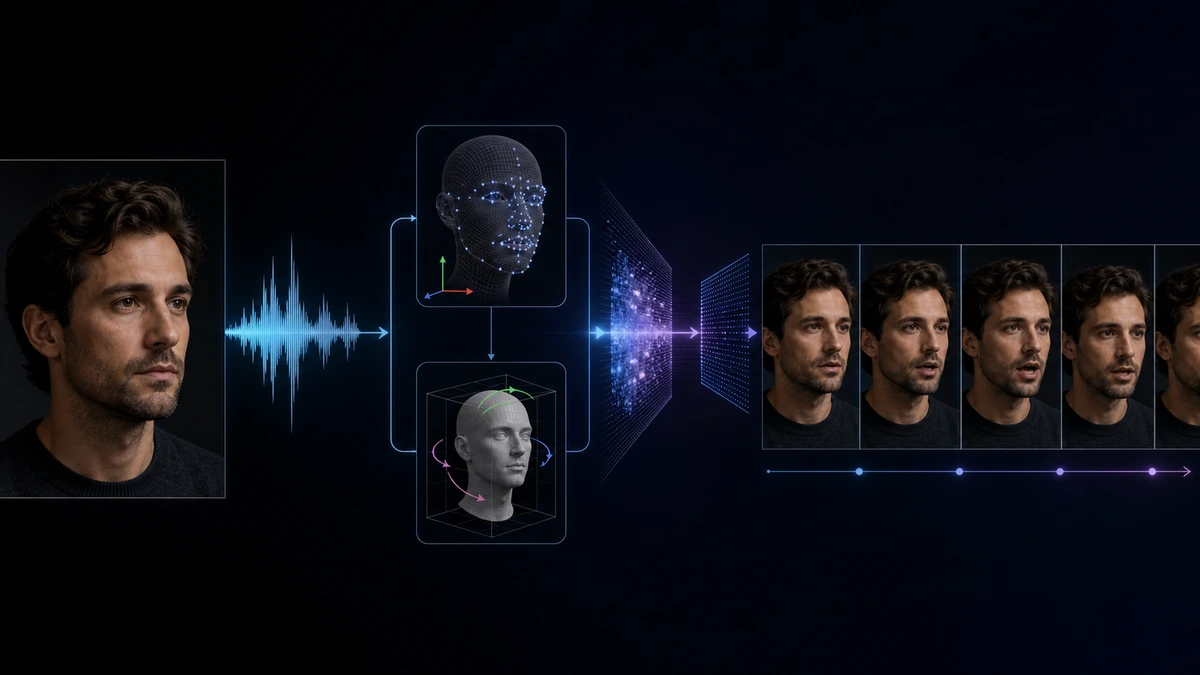
Gjennom årene har skapingen av realistiske og uttrykksfulle portrettanimasjoner fra statiske bilder og lyd funnet en rekke anvendelser, inkludert spill, digital media, virtuell virkelighet og mye mer. Til tross for sin potensielle anvendelse, er det fortsatt vanskelig for utviklere å skape rammeverk som kan generere høykvalitets animasjoner som opprettholder tidsmessig konsistens og er visuelt tiltrekkende. En hovedårsak til kompleksiteten er behovet for intrikat koordinering av leppebevegelser, hodeposisjoner og ansiktsuttrykk for å skape en visuelt tiltrekkende effekt.
I denne artikkelen vil vi snakke om AniPortrait, et nytt rammeverk designet for å generere høykvalitets animasjoner drevet av et referanseportrettbilde og en lydfil. AniPortraits arbeid er delt inn i to stadier. Først ekstraherer AniPortrait-rammeverket mellomliggende 3D-representasjoner fra lydfilene og projiserer dem inn i en sekvens av 2D-ansiktslandemerker. Deretter anvender rammeverket en robust diffusjonsmodell kombinert med en bevegelsesmodul for å konvertere landemerkesekvensen til tidsmessig konsistente og fotorealistiske animasjoner. De eksperimentelle resultater demonstrerer overlegenheten og evnen til AniPortrait-rammeverket til å generere høykvalitets animasjoner med unik visuell kvalitet, posisjonsdiversitet og ansiktsnaturlighet, og tilbyr dermed en forbedret og beriket perseptuell opplevelse. Videre har AniPortrait-rammeverket bemerkelsesverdig potensial i terms of kontroll og fleksibilitet, og kan anvendes effektivt i områder som inkluderer ansiktsreenactment, ansiktsbevegelsesredigering og mer. Denne artikkelen har som mål å dekke AniPortrait-rammeverket i dybden, og vi utforsker mekanismen, metodologien, arkitekturen til rammeverket samt sammenligningen med state-of-the-art-rammeverk. La oss begynne.
AniPortrait: Fotorealistiske portrettanimasjoner
Skaping av realistiske og uttrykksfulle portrettanimasjoner har vært fokus for forskere i en stund nå, på grunn av dens usedvanlige potensial og anvendelser som spenner fra digital media og virtuell virkelighet til spill og mer. Til tross for års forskning og utvikling, er det fortsatt en betydelig utfordring å produsere høykvalitets animasjoner som opprettholder tidsmessig konsistens og er visuelt tiltrekkende. En hovedhinder for utviklere er behovet for intrikat koordinering mellom hodeposisjoner, visuelle uttrykk og leppebevegelser for å skape en visuelt tiltrekkende effekt. Eksisterende metoder har ikke klart å håndtere disse utfordringene, hovedsakelig fordi de fleste av dem avhenger av begrensede kapasitetsgenereringer som NeRF, bevegelsesbaserte dekodere og GAN for visuell innholdsskaping. Disse nettverkene viser begrensede generaliseringsmuligheter og er ustabile i å generere høykvalitetsinnhold. Imidlertid har den nylige oppblomstringen av diffusjonsmodeller muliggjort generering av høykvalitetsbilder, og noen rammeverk bygget på toppen av diffusjonsmodeller samt tidsmessige moduler har muliggjort skapingen av tiltrekkende videoer, og lar diffusjonsmodellene utmerke seg.
Bygget på toppen av diffusjonsmodellenes fremgang, har AniPortrait-rammeverket som mål å generere høykvalitets animerte portretter ved hjelp av et referansebilde og en lydfil. AniPortraits arbeid er delt inn i to stadier. I det første stadiet anvender AniPortrait-rammeverket transformer-baserte modeller for å ekstrahere en sekvens av 3D-ansiktsmesh og hodeposisjon fra lydinput, og projiserer dem deretter inn i en sekvens av 2D-ansiktslandemerker. Det første stadiet muliggjør for AniPortrait-rammeverket å fange leppebevegelser og subtile uttrykk fra lyden, i tillegg til hodebevegelser som synkroniserer med rytmen av lydfilen. Det andre stadiet anvender AniPortrait-rammeverket en robust diffusjonsmodell og integrerer den med en bevegelsesmodul for å konvertere landemerkesekvensen til en fotorealistisk og tidsmessig konsistent animert portrett. For å være mer spesifik, bygger AniPortrait-rammeverket på nettverksarkitekturen fra den eksisterende AnimateAnyone-modellen, som anvender Stable Diffusion 1.5, en potensuell diffusjonsmodell for å generere livlige og flytende animasjoner basert på et referansebilde og en kroppbevegelsessekvens. Det som er verdt å merke seg er at AniPortrait-rammeverket ikke anvender poseguidermodulen i dette nettverket, som er implementert i AnimateAnyone-rammeverket, men redesigner den, og lar AniPortrait-rammeverket ikke bare opprettholde en lett design, men også utviser forbedret nøyaktighet i å generere leppebevegelser.
Eksperimentelle resultater demonstrerer overlegenheten til AniPortrait-rammeverket i å skape animasjoner med imponerende ansiktsnaturlighet, utmerket visuell kvalitet og variasjoner i posisjoner. Ved å anvende 3D-ansiktsrepresentasjoner som mellomliggende funksjoner, får AniPortrait-rammeverket fleksibiliteten til å modifisere disse representasjonene etter eget ønske. Fleksibiliteten forbedrer betydelig anvendeligheten av AniPortrait-rammeverket i ulike domener, inkludert ansiktsreenactment og ansiktsbevegelsesredigering.
AniPortrait: Arbeid og Metodologi
Det foreslåtte AniPortrait-rammeverket består av to moduler, nemlig Lmk2Video og Audio2Lmk. Audio2Lmk-modulen forsøker å ekstrahere en sekvens av landemerker som fanger intrikate leppebevegelser og ansiktsuttrykk fra lydinput, mens Lmk2Video-modulen anvender denne landemerkesekvensen for å generere høykvalitets portrettvideoer med tidsmessig stabilitet. Følgende figur presenterer en oversikt over AniPortrait-rammeverkets arbeid. Som det kan observeres, ekstraherer AniPortrait-rammeverket først 3D-ansiktsmesh og hodeposisjon fra lyden, og projiserer disse to elementene inn i 2D-nøkkel punkter deretter. I det andre stadiet anvender rammeverket en diffusjonsmodell for å konvertere 2D-nøkkel punktene til en portrettvideo med to stadier som trenes samtidig innenfor nettverket.

Audio2Lmk
For en gitt sekvens av taleklipp, er det primære målet for AniPortrait-rammeverket å forutsi den tilsvarende 3D-ansiktsmesh-sekvensen med vektorrepresentasjoner av translasjon og rotasjon. AniPortrait-rammeverket anvender den forhånds trenede wav2vec-metoden for å ekstrahere lydfunksjoner, og modellen viser en høy grad av generalisering, og er i stand til å gjenkjenne intonasjon og uttale fra lyden nøyaktig, noe som spiller en avgjørende rolle i å generere realistiske ansiktsanimasjoner. Ved å utnytte de tilegnede robuste talefunksjonene, er AniPortrait-rammeverket i stand til å effektivt anvende en enkel arkitektur bestående av to fc-lag for å konvertere disse funksjonene til 3D-ansiktsmesh. AniPortrait-rammeverket observerer at denne enkle designen implementert av modellen ikke bare forbedrer effektiviteten av inferensprosessen, men også sikrer nøyaktighet. Når det gjelder å konvertere lyd til posisjon, anvender AniPortrait-rammeverket den samme wav2vec-nettverket som bakgrunnen, selv om modellen ikke deler vektene med audio-til-mesh-modulen. Dette skyldes hovedsakelig at posisjon er assosiert mer med tone og rytme i lyden, som holder en annen betoning sammenlignet med audio-til-mesh-oppdrag. For å håndtere påvirkningen av de forrige tilstandene, anvender AniPortrait-rammeverket en transformer-dekoder for å dekodere posisjonssekvensen. Under denne prosessen integrerer rammeverket lydfunksjonene i dekoderen ved hjelp av kryss-oppmerksomhetsmekanismer, og for begge modulene trenes de ved hjelp av L1-tap. Når modellen mottar posisjons- og mesh-sekvensen, anvender den perspektivprosjeksjon for å konvertere disse sekvensene til en 2D-sekvens av ansiktslandemerker som deretter anvendes som inngangssignaler for det påfølgende stadiet.
Lmk2Video
For en gitt referanseportrettbilde og en sekvens av ansiktslandemerker, skaper Lmk2Video-modulen en tidsmessig konsistent portrettanimasjon, og denne animasjonen samstemmer med bevegelsen av landemerkesekvensen, og opprettholder et utseende som er konsistent med referansebildet, og til slutt representerer portrettanimasjonen som en sekvens av portrett-rammer. Designen av Lmk2Videos nettverksstruktur søker inspirasjon fra den eksisterende AnimateAnyone-rammeverket. AniPortrait-rammeverket anvender en Stable Diffusion 1.5, en ekstremt potensuell diffusjonsmodell som bakgrunn, og inkorporerer en tidsmessig bevegelsesmodul som effektivt konverterer multi-ramme støyinndata til en sekvens av video-rammer. Samtidig anvender en ReferencenNet-nettverkskomponent strukturen til Stable Diffusion 1.5, og anvender den til å ekstrahere utseendeinformasjon fra referansebildet, og integrerer den i bakgrunnen. Den strategiske designen sikrer at ansikts-ID forblir konsistent gjennom hele utgangsvideoen. I motsetning til AnimateAnyone-rammeverket, forbedrer AniPortrait-rammeverket kompleksiteten i PoseGuider-designet. Den originale versjonen av AnimateAnyone-rammeverket består bare av noen konvolusjonslag etterfulgt av at landemerkefunksjonene slås sammen med latente på inngangslaget til bakgrunnen. AniPortrait-rammeverket oppdager at designen mangler i å fange intrikate bevegelser av leppene, og for å håndtere dette problemet, anvender rammeverket en multi-skala-strategi av ConvNet-arkitekturen, og inkorporerer landemerkefunksjoner av tilsvarende skalaer inn i ulike blokker av bakgrunnen. Videre introduserer AniPortrait-rammeverket en ytterligere forbedring ved å inkludere landemerker fra referansebildet som en ekstra inngang. Kryss-oppmerksomhetsmodulen i PoseGuider-komponenten muliggjør interaksjonen mellom mål-landemerker for hver ramme og referanse-landemerker. Denne prosessen gir nettverket ekstra hint for å forstå korrelasjonen mellom utseende og ansiktslandemerker, og hjelper dermed i å generere portrettanimasjoner med mer presis bevegelse.
AniPortrait: Implementering og Resultat
For Audio2Lmk-stadiet, anvender AniPortrait-rammeverket wav2vec2.0-komponenten som bakgrunn, og anvender MediaPipe-arkitekturen for å ekstrahere 3D-mesh og 6D-pose for annoteringer. Modellen henter treningsdata for Audio2Mesh-komponenten fra sin interne datasett som består av omtrent 60 minutter med høykvalitets taledata hentet fra en enkelt taler. For å sikre at 3D-meshen som ekstraheres av MediaPipe-komponenten er stabil, instrueres stemmeskuespilleren til å møte kameraet og opprettholde en stabil hodeposisjon gjennom hele opptakprosessen. For Lmk2Video-modulen, implementerer AniPortrait-rammeverket en to-stegs treningsprosess. I det første stadiet fokuserer rammeverket på å trene ReferenceNet og PoseGuider, 2D-komponenten av bakgrunnen, og lar bevegelsesmodulen være. I det andre stadiet fryser AniPortrait-rammeverket alle andre komponenter og konsentrerer seg om å trene bevegelsesmodulen. For dette stadiet anvender rammeverket to store skala høykvalitets ansiktsvideo-datasett for å trene modellen, og prosesserer alle dataene ved hjelp av MediaPipe-komponenten for å ekstrahere 2D-ansiktslandemerker. Videre, for å forbedre nettverkets sensitivitet overfor leppebevegelser, differensierer AniPortrait-modellen mellom øvre og nedre lepper med distinkte farger når det gjelder å rendre posisjonsbildet fra 2D-landemerker.
Som vist i følgende bilde, genererer AniPortrait-rammeverket en rekke animasjoner som demonstrerer overlegen kvalitet og realisme.

Rammeverket anvender deretter en mellomliggende 3D-representasjon som kan redigeres for å manipulere utgangen etter behov. For eksempel, kan brukerne ekstrahere landemerker fra en bestemt kilde og endre dens ID, og lar dermed AniPortrait-rammeverket skape en ansiktsreenactment-effekt.
Slutt tanker
I denne artikkelen har vi snakket om AniPortrait, et nytt rammeverk designet for å generere høykvalitets animasjoner drevet av et referanseportrettbilde og en lydfil. Ved å bare innputte et referansebilde og en lydfil, er AniPortrait-rammeverket i stand til å generere en portrettvideo som viser naturlig bevegelse av hoder og glatte leppebevegelser. Ved å utnytte de robuste generaliseringsmulighetene til diffusjonsmodellen, genererer AniPortrait-rammeverket animasjoner som viser imponerende realistisk bildekvalitet og livlige bevegelser. AniPortraits arbeid er delt inn i to stadier. Først ekstraherer AniPortrait-rammeverket mellomliggende 3D-representasjoner fra lydfilene og projiserer dem inn i en sekvens av 2D-ansiktslandemerker. Deretter anvender rammeverket en robust diffusjonsmodell kombinert med en bevegelsesmodul for å konvertere landemerkesekvensen til tidsmessig konsistente og fotorealistiske animasjoner. De eksperimentelle resultater demonstrerer overlegenheten og evnen til AniPortrait-rammeverket til å generere høykvalitets animasjoner med unik visuell kvalitet, posisjonsdiversitet og ansiktsnaturlighet, og tilbyr dermed en forbedret og beriket perseptuell opplevelse. Videre har AniPortrait-rammeverket bemerkelsesverdig potensial i terms of kontroll og fleksibilitet, og kan anvendes effektivt i områder som inkluderer ansiktsreenactment, ansiktsbevegelsesredigering og mer.


