Andersons vinkel
AI‑bildematting som forstår scener

 Legg til Unite.AI blant dine foretrukne kilder på Google
I den ekstra dokumentaren som følger med DVD‑utgivelsen fra 2003 av Alien3 (1992), husket visuelleffektslegenden Richard Edlund med skrekk ‘sumowrestling’ av fotokjemisk matteuttrekk som dominerte VFX‑arbeidet mellom de sene 1930‑tallet og slutten av 1980‑tallet. Edlund beskrev prosessens treff‑og‑miss‑natur som ‘sumowrestling’, i sammenligning med de digitale blå‑/grønn‑skjerm‑teknikkene som tok over på begynnelsen av 1990‑tallet (og han har vendt tilbake til metaforen siden da).
Uttrekning av et forgrunnselement (som en person eller en romskip‑modell) fra en bakgrunn, slik at det utskårne bildet kan settes sammen med en bakgrunnsplate, ble opprinnelig oppnådd ved å filme forgrunnsobjektet foran en ensartet blå eller grønn bakgrunn.
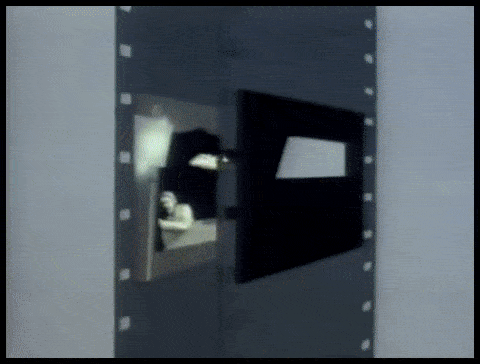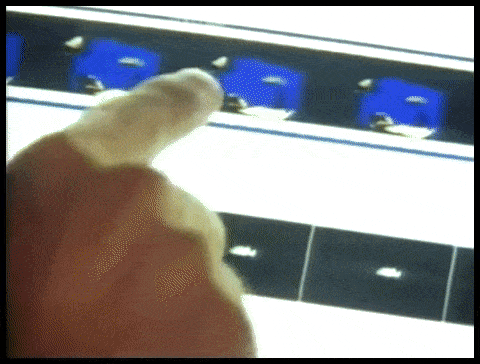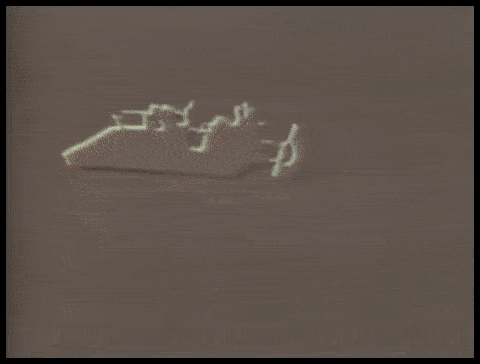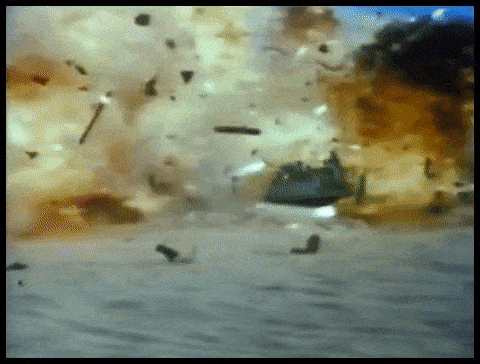
Arbeidskrevende fotokjemiske uttrekksprosesser for en VFX‑scene av ILM for ‘Return of the Jedi’ (1983).
I det resulterende opptaket ville bakgrunnsfargen deretter bli isolert kjemisk og brukt som en mal for å gjenskape forgrunnsobjektet (eller personen) i en optisk skriver som et ‘flytende’ objekt i en ellers transparent filmcelle.
Prosessen ble kjent som color separation overlay (CSO) – selv om dette begrepet etter hvert ble mer assosiert med de grove ‘Chromakey’-videoeffektene i lavbudsjett‑tv‑produksjoner på 1970‑ og 1980‑tallet, som ble oppnådd med analoge snarere enn kjemiske eller digitale metoder.

En demonstrasjon av Color Separation Overlay i 1970 for det britiske barneprogrammet ‘Blue Peter’. Kilde: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
Uansett, enten det gjelder film‑ eller videoelementer, kunne det uttatte opptaket deretter settes inn i annet opptak.
Selv om Disneys merkbart dyrere og proprietære natriumdampprosess (som nøkkelte på gult, spesifikt, og også ble brukt for Alfred Hitchcocks skrekkfilm fra 1963 The Birds) ga bedre definisjon og skarpere masker, forble fotokjemisk uttrekning arbeidskrevende og upålitelig.

Disneys proprietære uttrekkingsprosess med natriumdamp krevde bakgrunner nær den gule enden av spekteret. Her er Angela Lansbury hengt opp i vaiere under produksjonen av en VFX‑tung sekvens for ‘Bedknobs and Broomsticks’ (1971). Kilde
Utover digital matting
På 1990‑tallet avskaffet den digitale revolusjonen kjemikaliene, men ikke behovet for grønnskjerm. Det ble nå mulig å fjerne den grønne (eller hvilken som helst) bakgrunnen ved bare å søke etter piksler innenfor et toleranseområde for den fargen, i pikselredigeringsprogrammer som Photoshop, samt en ny generasjon av videokomponeringspakker som automatisk kunne fjerne de fargede bakgrunnene. Nesten over natten ble seksti år med den optiske trykkeribransjen lagt bak historien.
De siste ti årene med GPU‑akselerert datavisjonsforskning innfører matteuttrekk i en tredje æra, og utfordrer forskere til å utvikle systemer som kan trekke ut masker av høy kvalitet uten behov for grønnskjerm. På Arxiv alene er artikler om innovasjoner innen maskinlæringsbasert forgrunnsuttrekk en ukentlig foreteelse.
Setter oss i bildet
Dette sentrum for akademisk og industriell interesse for AI‑uttrekk har allerede påvirket forbrukermarkedet: grove men funksjonelle implementasjoner er kjent for oss alle i form av Zoom– og Skype-filtre som kan erstatte bakgrunnen i stuen med tropiske øyer osv., i videokonferanser.
Imidlertid krever de beste maskene fortsatt en grønnskjerm, som Zoom bemerket sist onsdag.

Venstre: en mann foran en grønnskjerm, med godt ekstrahert hår via Zooms Virtual Background‑funksjon. Høyre: en kvinne foran en vanlig hjemmeinnredning, med hår ekstrahert algoritmisk, mindre nøyaktig, og med høyere beregningskrav. Kilde: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Et ytterligere innlegg fra Zoom Support‑plattformen advarer om at uttrekning uten grønnskjerm også krever større beregningskraft i opptaksenheten.
Behovet for å kutte det ut
Forbedringer i kvalitet, bærbarhet og ressursøkonomi for ‘i det fri’ matteuttrekkssystemer (dvs. isolering av personer uten behov for grønnskjerm) er relevante for mange flere sektorer og formål enn bare videokonferansefiltre.
For datasettutvikling gir forbedret ansikts‑, helhode‑ og helkropps‑gjenkjenning muligheten til å sikre at overflødige bakgrunnselementer ikke blir trent inn i datavisjonsmodeller av menneskelige subjekter; mer nøyaktig isolering vil i stor grad forbedre semantisk segmentering-teknikker designet for å skille og assimilere domener (dvs. ‘katt’, ‘person’, ‘båt’), og forbedre VAE– og transformer-baserte bildesyntesesystemer som OpenAIs nye DALL‑E 2; og bedre uttrekksalgoritmer vil redusere behovet for kostbar manuell rotoskopering i dyre VFX‑produksjonslinjer.
Faktisk gjør fremveksten av multimodale (vanligvis tekst/bilde) metodologier, hvor et domene som ‘cat’ kodes både som et bilde og med tilknyttede tekstreferanser, allerede innhogg i bildebehandling. Et nylig eksempel er Text2Live-arkitekturen, som bruker multimodal (tekst/bilde) trening for å lage videoer av, blant utallige andre muligheter, krystallsvaner og glassgiraffer.
Scene‑bevisst AI‑matting
En god del av forskningen på AI‑basert automatisk matting har fokusert på kantgjenkjenning og evaluering av pikselbaserte grupperinger i et bilde eller videoramme. Imidlertid tilbyr ny forskning fra Kina en uttrekks‑pipeline som forbedrer avgrensning og mattekvalitet ved å utnytte tekstbaserte beskrivelser av en scene (en multimodal tilnærming som har fått fotfeste i datavisjonsforskningssektoren de siste 3‑4 årene), og hevder å ha forbedret tidligere metoder på flere måter.

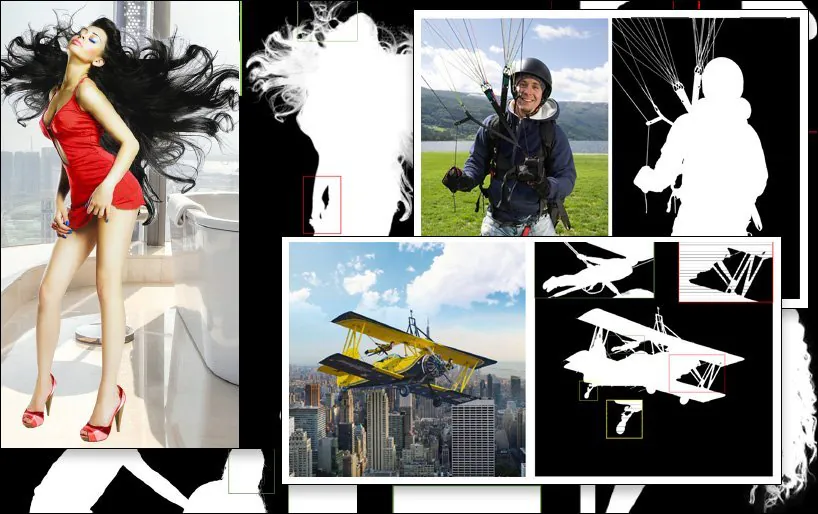
Et eksempel på SPG‑IM‑uttrekk (siste bilde, nederst til høyre), sammenlignet med konkurrerende tidligere metoder. Kilde: https://arxiv.org/pdf/2204.09276.pdf
Utfordringen for uttrekksforskningsundersektoren er å produsere arbeidsflyter som krever et minimum av manuell annotering og menneskelig inngripen – ideelt sett ingen. I tillegg til kostnadsmessige implikasjoner observerer forskerne i den nye artikkelen at annoteringer og manuelle segmenteringer utført av eksterne crowdworkers på tvers av ulike kulturer kan føre til at bilder blir merket eller til og med segmentert på forskjellige måter, noe som resulterer i inkonsistente og utilfredsstillende algoritmer.
Et eksempel på dette er den subjektive tolkningen av hva som definerer et ‘forgrunnsobjekt’:

Fra den nye artikkelen: tidligere metoder LFM og MODNet (‘GT’ står for Ground Truth, et ‘ideelt’ resultat som ofte oppnås manuelt eller med ikke‑algoritmiske metoder), har ulike og varierende effektive oppfatninger av definisjonen av forgrunnsinnhold, mens den nye SPG‑IM‑metoden mer effektivt avgrenser ‘nært innhold’ gjennom scenekontekst.
For å løse dette har forskerne utviklet en to‑trinns pipeline kalt Situational Perception Guided Image Matting (SPG‑IM). Den to‑trinns encoder/decoder‑arkitekturen består av Situational Perception Distillation (SPD) og Situational Perception Guided Matting (SPGM).

SPG‑IM‑arkitekturen.
Først fortrener SPD transformasjoner av visuelle trekk til tekstlige trekk, og genererer bildetekster som passer til de tilhørende bildene. Deretter aktiveres forgrunnsmaskesprediksjonen ved å koble pipelinen til en ny saliency‑prediksjon-teknikk.
Deretter gir SPGM ut en estimert alfa‑matte basert på den rå RGB‑bilde‑inndataen og den genererte masken som ble oppnådd i første modul.
Målet er situasjons‑persepsjonsveiledning, hvor systemet har en kontekstuell forståelse av hva bildet består av, noe som gjør det i stand til å ramme inn – for eksempel – utfordringen med å trekke ut komplekst hår fra en bakgrunn basert på kjente egenskaper for en slik spesifikk oppgave.

I eksemplet nedenfor forstår SPG‑IM at snorene er en integrert del av en ‘fallskjerm’, hvor MODNet mislykkes i å beholde og definere disse detaljene. På samme måte ovenfor blir den komplette strukturen til lekeapparatet vilkårlig tapt i MODNet.
Den nye artikkelen heter Situational Perception Guided Image Matting, og kommer fra forskere ved OPPO Research Institute, PicUp.ai og Xmotors.
Intelligente automatiserte masker
SPG‑IM tilbyr også et Adaptive Focal Transformation (AFT) Refinement‑nettverk som kan behandle lokale detaljer og global kontekst separat, og muliggjør ‘intelligente masker’.

Forståelse av scenekontekst, i dette tilfellet ‘jente med hest’, kan potensielt gjøre forgrunnsuttrekk enklere enn tidligere metoder.
Artikkelen sier:
‘Vi mener at visuelle representasjoner fra den visuell‑til‑tekst‑oppgaven, f.eks. bildebeskriving, fokuserer på mer semantisk omfattende signaler mellom a) objekt til objekt og b) objekt til omgivelsene for å generere beskrivelser som kan dekke både den globale informasjonen og lokale detaljer. I tillegg, sammenlignet med den kostbare piksel‑annoteringen av bildematting, kan tekstlige etiketter samles inn i stor skala til svært lav kostnad.’
SPD‑grenen av arkitekturen er forhåndstrent i samarbeid med University of Michigan sin VirTex-transformer‑baserte tekstdekoder, som lærer visuelle representasjoner fra semantisk tette bildetekster.

VirTex trener i fellesskap et ConvNet og Transformere via bilde‑tekst‑par, og overfører de oppnådde innsiktene til nedstrøms visjonsoppgaver som objektdeteksjon. Kilde: https://arxiv.org/pdf/2006.06666.pdf
Blant andre tester og ablasjonsstudier testet forskerne SPG‑IM mot toppmoderne trimap-baserte metoder som Deep Image Matting (DIM), IndexNet, Context‑Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA og Semantic Image Matting (SIM).
Andre tidligere rammeverk som ble testet inkluderte trimap‑frie tilnærminger LFM, HAttMatting og MODNet. For rettferdig sammenligning ble testmetodene tilpasset basert på de ulike metodologiene; der kode ikke var tilgjengelig, ble artikkelens teknikker gjenskapt fra den beskrevne arkitekturen.
Den nye artikkelen sier:
‘Vår SPG‑IM overgår alle konkurrerende trimap‑frie metoder ([LFM], [HAttMatting] og [MODNet]) med stor margin. Samtidig viser vår modell bemerkelsesverdig overlegenhet over de toppmoderne (SOTA) trimap‑baserte og mask‑styrte metodene med hensyn til alle fire måleparametere på de offentlige datasett (dvs. Composition‑1K, Distinction‑646 og Human‑2K), og vår Multi‑Object‑1K‑benchmark.’
Og fortsetter:
‘Det er tydelig at vår metode bevarer fine detaljer (f.eks. hårspisser, transparente teksturer og kanter) uten veiledning fra trimap. Dessuten, sammenlignet med andre konkurrerende trimap‑frie modeller, kan vår SPG‑IM opprettholde bedre global semantisk fullstendighet.’


Først publisert 24. april 2022.