
AGI en toekomstige AI
Wat is de Turing-test en waarom is hij belangrijk?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
De Turing-test is voortgekomen uit Alan Turing’s paper uit 1950 “Computing Machinery and Intelligence.” In plaats van te proberen denken te definiëren, stelde Turing een imitatie‑spel voor: een menselijke ondervrager wisselt geschreven berichten uit met niet‑zichtbare deelnemers en beoordeelt welke mens is en welke machine.
De test blijft invloedrijk omdat hij een abstracte filosofische vraag omzet in een observeerbare interactie. Hij is echter beperkt: menselijk lijken in een gesprek is niet hetzelfde als eerlijk, deskundig, veilig, bewust of algemeen intelligent zijn.
Belangrijkste conclusies
- Turing’s oorspronkelijke imitatie‑spel is een tekstgebaseerde gedragstest, geen checklist van interne cognitieve eigenschappen.
- Resultaten hangen af van de beoordelaar, prompt, duur, instructies voor deelnemers en de beoordelingsregel.
- Een model kan menselijke conversatie nabootsen terwijl het feiten verzint of faalt bij eenvoudige robuustheidstests.
- Moderne evaluatie vereist taak‑metriek, adversariële tests, menselijke beoordeling en risicospecifiek bewijs naast conversatie.
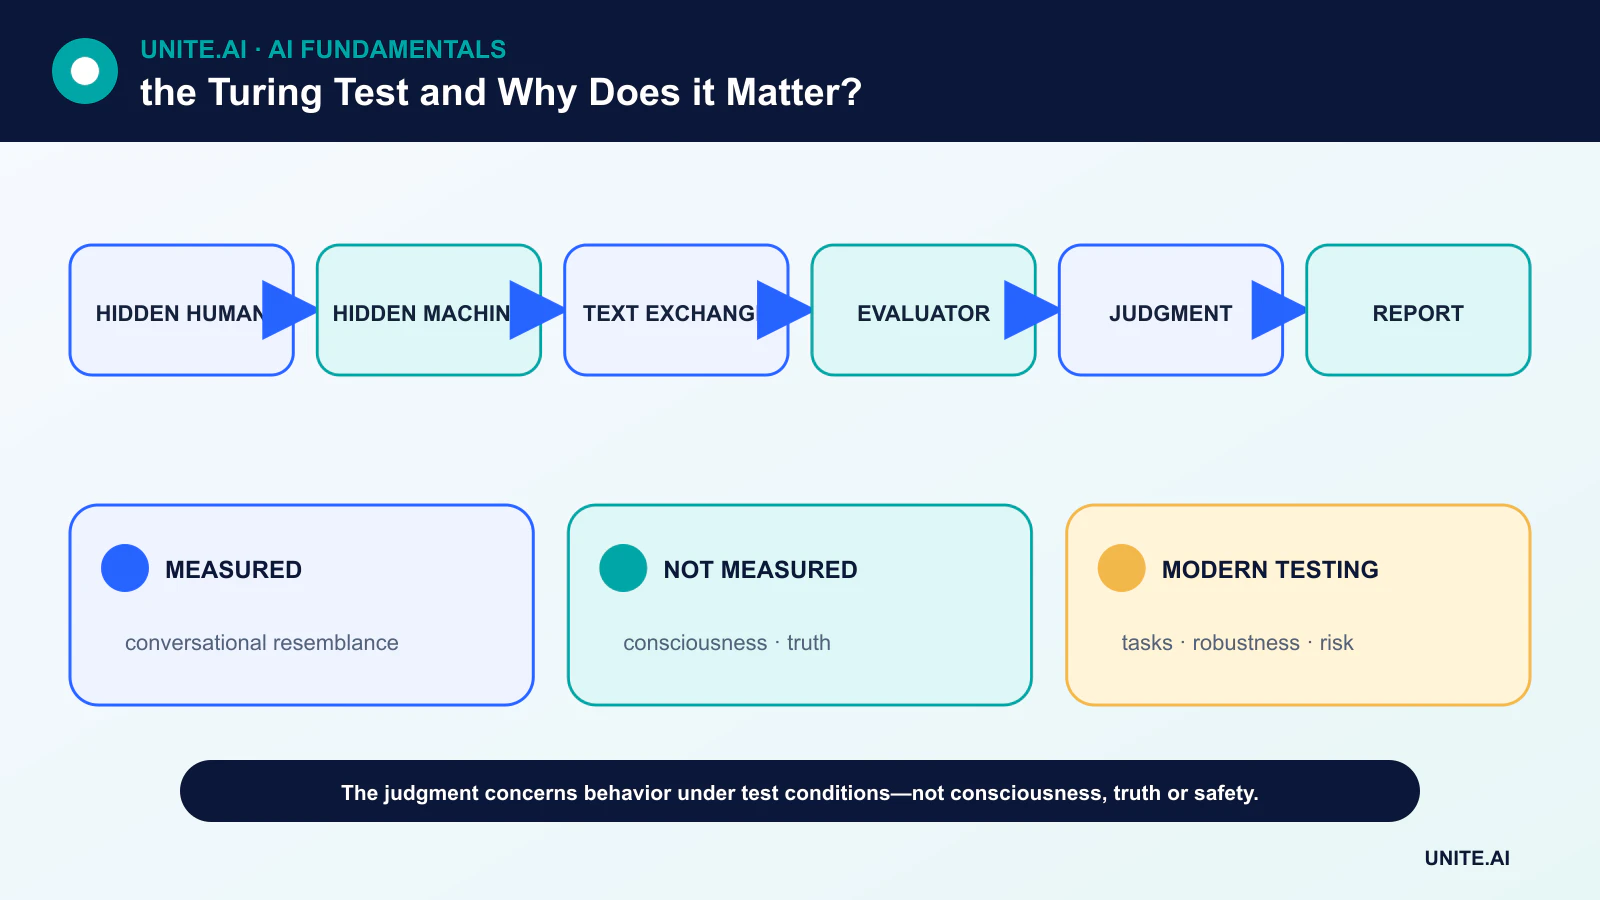
Turing’s imitatie‑spel
In de oorspronkelijke opzet communiceerde een ondervrager op afstand zodat stem en uiterlijk de identiteit niet onthulden. Turing vroeg of een machine goed genoeg kon presteren in het spel zodat een beoordelaar haar niet betrouwbaar kon onderscheiden van een persoon.
Deze operationele benadering vermijdde de noodzaak om één definitie van denken vast te stellen. Hij beweerde niet dat elke overtuigende uitwisseling intelligentie bewijst, noch specificeerde hij een universele slaag‑drempel die op latere chatbot‑demonstraties van toepassing zou zijn.
Wat een resultaat werkelijk meet
Een proef meet gedragsononderscheidbaarheid onder gedefinieerde omstandigheden. Korte gesprekken, onervaren juryleden of prompts die door de systeemontwikkelaar zijn gekozen, kunnen de taak vergemakkelijken. Een rigoureus rapport moet de selectie van transcripties, het aantal en de achtergrond van de juryleden, de vergelijkings‑personen, de tijdslimiet en de statistische methode openbaar maken.
Een systeem kan ook verwachtingen exploiteren: ontwijkend gedrag, humor, typografische fouten en rollenspel kunnen menselijk lijken zonder betrouwbaar redeneren te tonen. Omgekeerd kan een ongewoon formele menselijke reactie ten onrechte als machinaal gegenereerd worden geclassificeerd.
Wat de Turing-test niet vaststelt
De test meet niet direct bewustzijn, subjectieve ervaring, feitelijke juistheid, causaal begrip of morele handelingsbekwaamheid. Hij onthult niet de trainingsdata, modelarchitectuur of foutmodi buiten het gesprek. Hij zegt ook weinig over niet‑taalgebonden intelligentie, zoals fysieke manipulatie.
Moderne taalsystemen zijn gebouwd met transformer‑neurale netwerken en deep learning, maar hun vloeiende output kan nog steeds voortkomen uit aangeleerde statistische structuren in plaats van een geverifieerd wereldmodel.
Hoe moderne AI-evaluatie de vraag uitbreidt
Hedendaagse evaluatie maakt gebruik van gereserveerde takenreeksen, gekalibreerde onzekerheid, robuustheidstests, red‑team‑aanvallen, feitelijkheidscontroles en studies naar menselijke voorkeuren. Een tekst‑classificatie-metriek kan een gedefinieerd gedrag testen, terwijl scenario‑gebaseerde evaluatie kan nagaan of een systeem onder druk het beleid volgt.
Geen enkele benchmark vangt elke inzetomgeving. Testvervuiling kan scores opblazen, en statische benchmarks stimuleren overfitting. Evaluatie moet herhaald worden naarmate modellen, data, prompts, tools en gebruikerspopulaties veranderen.
Waarom de test nog steeds belangrijk is
De Turing-test voorzag al in een kernles van AI‑evaluatie: beoordeel observeerbare capaciteit in plaats van te vertrouwen op beweringen over een interne essentie. Hij dwingt ons ook te vragen welke menselijke gedragingen als bewijs tellen en hoe een experimentele opzet een conclusie vormt.
Het meest waardevolle moderne gebruik is als historisch en conceptueel referentiepunt. Het slagen voor een imitatie‑spel kan interessant zijn, maar beslissingen over inzet vereisen bewijs dat gekoppeld is aan de daadwerkelijke taak, de betrokken gebruikers en de te voorziene schade.
Wat de Turing-test meet
Het imitatie‑spel van Alan Turing vroeg of een ondervrager die via tekst communiceert, betrouwbaar een machine van een persoon kan onderscheiden. Het herformuleerde een abstract debat over of machines denken tot een observeerbaar gespreksexperiment. De test hangt af van deelnemers, duur, protocol, onderwerpen en beoordelingsregel; er bestaat geen enkele universele score. Slagen betekent dat er onder die opzet mensachtige antwoorden worden geproduceerd. Het meet niet direct feitelijke juistheid, redeneren, bewustzijn, autonomie, perceptie, belichaming, betrouwbaarheid of nuttig gedrag in de echte wereld.
Menselijke imitatie kan ontwijking, persona, fouten, humor of manipulatie belonen. Een jurylid kan een mens verwarren met een machine of beïnvloed worden door verwachtingen, taal en culturele context. Korte gesprekken maken trucjes mogelijk die falen bij langdurige interactie. Omgekeerd kan een zeer nuttig systeem voor wiskunde, vertaling of eiwitmodellering falen omdat het zich niet voordoet als mens. De test meet dus een sociale en linguïstische capaciteit die door de beoordelaar wordt gevormd, niet een volledige rangschikking van intelligentie.
Moderne taalmodellen en strengere evaluatie
Grote taalmodellen kunnen vloeiend dialoog voeren door reeksen te voorspellen op basis van brede trainingsdata en latere afstemming, maar vloeiendheid is een zwak bewijs voor waarheid of begrip. Gememoriseerde patronen, tool‑toegang, verborgen prompts, latentie en steekproefinstellingen beïnvloeden de resultaten. Gecontroleerde evaluaties moeten model en protocol openbaar maken, informatie‑lekken voorkomen, adversariële en domeinspecifieke vragen opnemen, en onzekerheid en citatie scoren. Een demonstratie geselecteerd uit succesvolle gesprekken kan de betrouwbaarheid over de gehele gebruiksverdeling niet inschatten.
Moderne evaluatie is multidimensionaal: taak‑nauwkeurigheid, kalibratie, robuustheid, consistentie op lange termijn, veiligheid, bias, privacy, beveiliging, efficiëntie en menselijke uitkomsten. Gedragstests moeten worden aangevuld met proces‑bewijs, red‑team‑aanvallen, reproduceerbare benchmarks en monitoring in de echte wereld. Benchmarks kunnen verzadigen of in trainingsdata terechtkomen, dus private en geactualiseerde testsets zijn nodig. Voor systemen die handelen, moeten tool‑rechten, herstel en consequenties apart van de gesprekskwaliteit worden geëvalueerd.
Waarom de test nog steeds belangrijk is
De Turing-test blijft historisch belangrijk omdat hij zich richt op gedrag en de moeilijkheid om intelligentie te definiëren. Hij roept ook voortdurende vragen op over antropomorfisme en misleiding. Interfaces moeten synthetische agenten identificeren in plaats van een vergissing in identiteit als succes te beschouwen, vooral in kritieke omgevingen. Gebruik de test als een filosofische lens en één conversatie‑evaluatie, niet als een certificering van algemene intelligentie of persoonsstatus. De cruciale vraag bij inzet is wat het systeem betrouwbaar kan doen, op basis van welk bewijs en welke grenzen, en wie aansprakelijk is wanneer het faalt.
Voorbeeld: een gecontroleerde conversatie‑evaluatie
Beoordelaars vergelijken mensen en verschillende AI‑systemen in tekstgesprekken met vaste duur, onderwerpen, taal en geblindeerde identiteiten. Juryleden noteren of ze denken dat elke deelnemer mens is en scoren daarnaast feitelijkheid, consistentie, behulpzaamheid, onzekerheid en manipulatie. Meerdere juryleden en gesprekken schatten variatie, en het protocol voorkomt dat modelontwikkelaars gunstige transcripties selecteren. Menselijke misclassificatie biedt een noodzakelijke basislijn voor de interpretatie van het resultaat.
Een systeem dat juryleden misleidt maar feiten verzint, wordt niet als algemeen intelligent verklaard, terwijl een duidelijk bekend specialistisch model zeer nuttig kan zijn ondanks het falen in imitatie. Resultaten omvatten prompt, model, sampler, tool‑toegang en kenmerken van de juryleden. Het experiment wordt gepresenteerd als één test van mensachtige conversatie. Beslissingen over inzet gebruiken afzonderlijk bewijs voor taakcorrectheid, veiligheid, privacy en herstel, en de interface identificeert de agent in plaats van misleiding tot productdoel te maken.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare basislijn en een versie‑gecontroleerde evaluatieset vast vóór afstemming. Test gewone gevallen, grenscondities, onjuiste of ontbrekende invoer, distributieverandering, uitval van afhankelijkheden, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend blijven. Meet taakkwaliteit samen met kalibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor releases, uitzonderingen, wijzigingen, terugdraaiingen en uitfasering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk ingevoerde fouten. Operationele telemetrie moet de kwaliteit van invoer, het gedrag van uitvoer, model‑ of regelversie, gezondheid van afhankelijkheden, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige gegevens te verzamelen. Definieer alarmdrempels en een verantwoordelijke voor respons, en evalueer vervolgens het bewijs uit de praktijk na inzet in plaats van aan te nemen dat offline prestaties blijven bestaan. Her‑evalueer telkens wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleidsregels, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures nodig, en een duidelijk moment waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Heeft een AI definitief de Turing-test doorstaan?
Er is geen enkele officiële testautoriteit of universeel geaccepteerd protocol. Publieke demonstraties hanteren verschillende regels, waardoor “doorstaan”‑claims niet direct vergelijkbaar zijn.
Bewijst het falen van de test dat een systeem niet intelligent is?
Nee. Een gespecialiseerd systeem kan zeer capabel zijn zonder een menselijke gespreksstijl te imiteren.
Primaire referenties












