
AI-basisprincipes
Generatieve vs. Discriminatieve Machine Learning-modellen

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
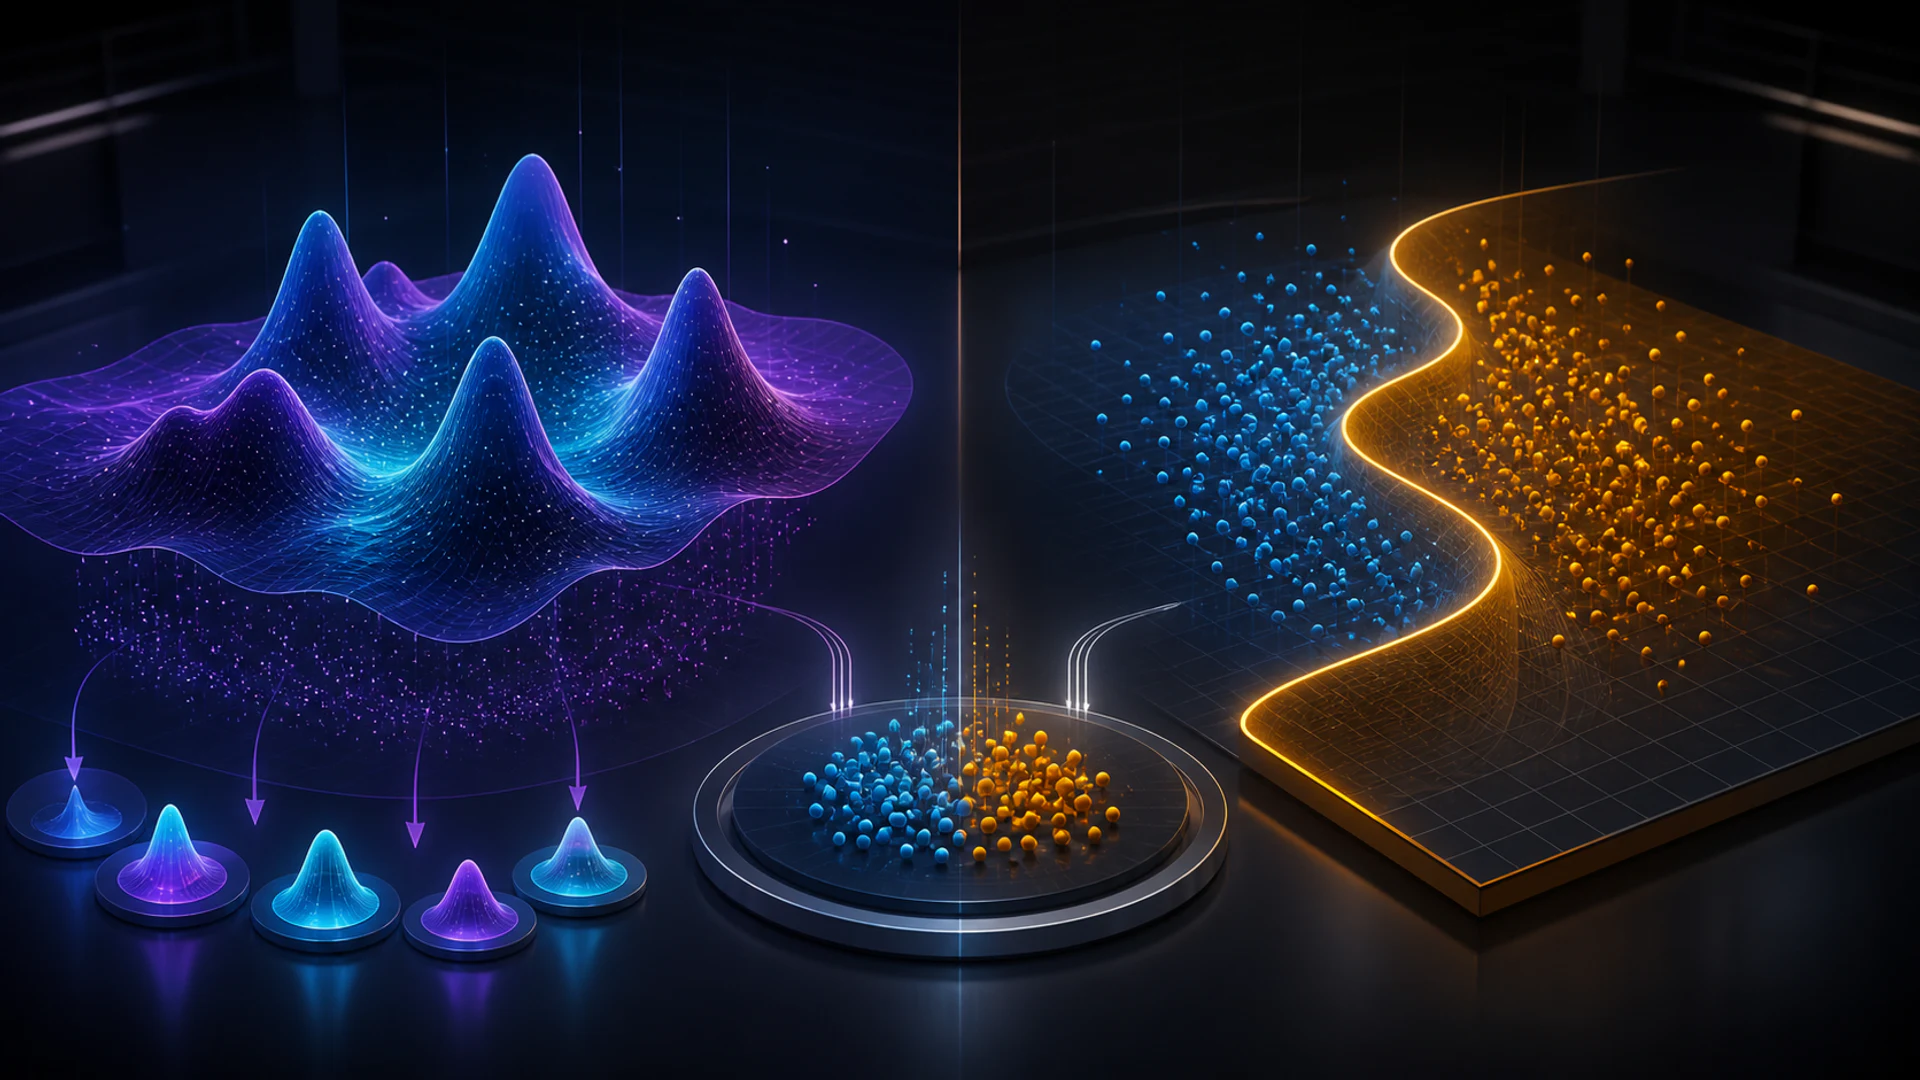
Generatief en discriminatief beschrijven wat een model leert over data en doelvariabelen. Bij klassieke, begeleide classificatie leert een generatief model een gezamenlijke verdeling zoals P(x, y) of een klasse‑voorwaardelijke P(x|y), terwijl een discriminatief model P(y|x) of een directe beslissingsgrens leert.
Het onderscheid is nuttig, maar moderne systemen combineren vaak doelstellingen. Een model kan generatieve representaties leren en later worden fijngestemd voor discriminatieve voorspelling, of één backbone delen tussen generatie en classificatie.
Belangrijkste conclusies
- Generatieve classifiers modelleren hoe invoer en labels ontstaan; discriminatieve classifiers modelleren het label gegeven de invoer of een grens.
- Generatieve aannames kunnen helpen bij beperkte gelabelde data, maar kunnen ook onjuist zijn.
- Discriminatieve methoden richten de capaciteit vaak op de voorspellingsopdracht en kunnen een lagere asymptotische classificatiefout behalen.
- GAN’s, VAE’s en taalmodellen zijn generatieve systemen, maar “generatief” betekent niet dat elk onderdeel een generatieve classifier is.
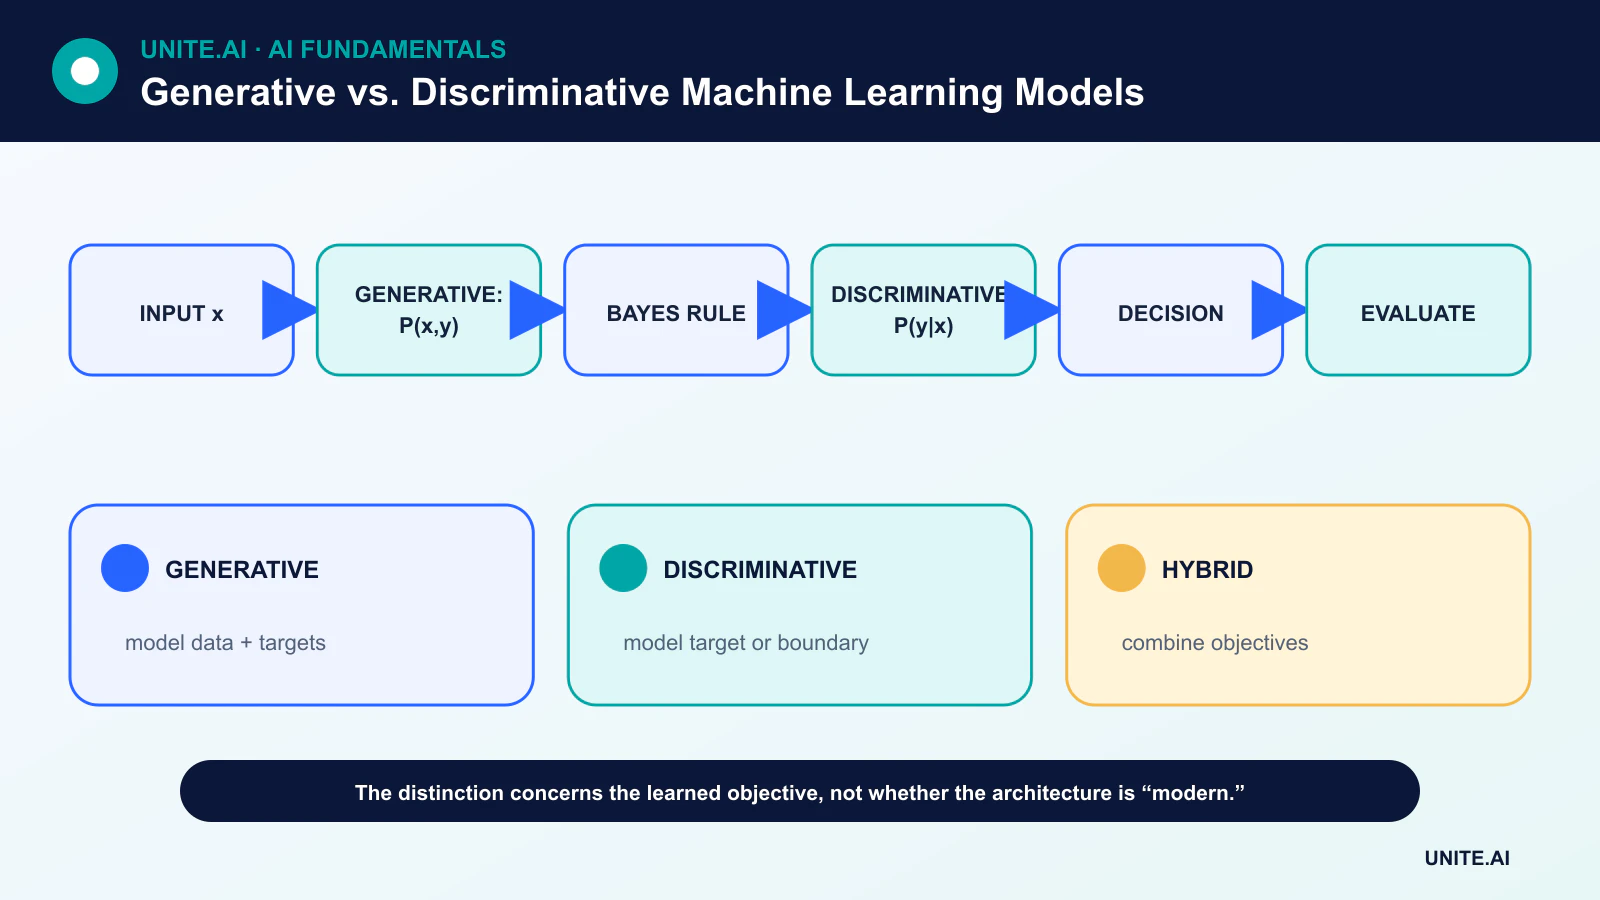
De probabilistische factorisatie
Een generatieve classifier kan P(x|y) en P(y) schatten, en vervolgens de Bayesiaanse stelling gebruiken om P(y|x) af te leiden. Naïeve Bayes is een klassiek voorbeeld. Een discriminatieve classifier, zoals logistische regressie, schat P(y|x) direct; een SVM leert een scheidingsgrens.
Het modelleren van P(x,y) is een bredere taak dan het voorspellen van y op basis van x. Die extra structuur kan sampling of redeneren over missende data ondersteunen, maar vereist ook aannames over de invoerverdeling.
Data‑efficiëntie en asymptotisch gedrag
De vergelijking van Ng en Jordan tussen naïeve Bayes en logistische regressie toonde een nuttig compromis: onder hun aannames kan het generatieve model met minder voorbeelden zijn limietprestaties benaderen, terwijl het discriminatieve model een lagere asymptotische fout kan bereiken.
Dit is geen universele rangschikking. Resultaten hangen af van of de modelfamilie bij de data past, de dimensie, regularisatie, optimalisatie en de kwaliteit van de labels. Een empirische vergelijking op een representatief validatie‑ontwerp blijft essentieel.
Representatieve modelfamilies
Generatieve modellen omvatten klasse‑voorwaardelijke verdelingen, verborgen Markov-modellen, mengmodellen, variationale auto‑encoders, autoregressieve taalmodellen, diffusiemodellen en GAN’s.
Discriminatieve modellen omvatten logistische regressie, beslisbomen, conditionele random fields, support vector machines en neurale classifiers. dezelfde neurale backbone kan in beide categorieën deelnemen, afhankelijk van het trainingsdoel en de output.
Hybride en zelf‑superviseerde systemen
Een voorgetraind taal‑ of visiemodel kan leren van ongelabelde data met een generatief of zelf‑superviserend doel, en vervolgens een discriminatieve kop krijgen voor een doeltaak. Half‑superviseerde methoden kunnen gelabelde classificatie en een doel voor ongelabelde data tegelijk optimaliseren.
Hybridisatie maakt architectuurlabels minder informatief dan de volledige trainings‑pipeline. Documentatie moet het doel, de data, de outputs en de beoogde inferentie vermelden — niet simpelweg een model als generatief bestempelen.
Kiezen tussen benaderingen
Gebruik de taak om te beslissen. Als het doel een gekalibreerde grens is met overvloedige labels, is een discriminatief model een natuurlijke basislijn. Als sampling, dichtheidsinschatting, missende‑datastuctuur of ongelabelde data centraal staan, kan een generatief component helpen.
Vergelijk robuustheid, steekproefficiëntie, rekencapaciteit, likelihood of kalibratie waar passend. Een goed gegenereerd monster bewijst geen goede classifier, en een classifier met hoge nauwkeurigheid impliceert geen realistisch model van de invoerverdeling.
Probabiliteitsrichtingen en modelleerdoelen
Een discriminatief model leert een grens of conditionele verdeling P(y|x): gegeven kenmerken x, voorspel label y. Logistische regressie, support vector machines, conditionele random fields en vele classifiers zijn discriminatief. Een generatief model leert een gezamenlijke verdeling P(x,y), een klasse‑voorwaardelijke verdeling P(x|y), of een onvoorwaardelijke dataverdeling, waardoor sampling of likelihood‑gerelateerde taken mogelijk zijn. Naïeve Bayes en lineaire discriminantanalyse zijn generatieve classifiers; GAN’s, variationale auto‑encoders, diffusiemodellen en autoregressieve modellen genereren data via verschillende doelstellingen.
Het onderscheid betreft welke verdeling of beslissingsregel gemodelleerd wordt, niet of een neuraal netwerk wordt gebruikt. Een generatief taalmodel kan worden aangezet om te classificeren, terwijl een discriminatieve re‑ranker generatie kan sturen. Generatieve aannames kunnen de data‑efficiëntie verbeteren of missende variabelen afhandelen, maar brengen risico op model‑mispecificatie met zich mee. Discriminatieve methoden blinken vaak uit bij overvloedige gelabelde data omdat ze zich direct op de voorspellingsgrens richten. Vergelijk families onder gelijke kenmerken, data, afstemming en rekencapaciteit in plaats van één categorie als universeel superieur te beschouwen.
Training en evaluatie per gebruiksgeval
Classificatie‑evaluatie gebruikt precisie, recall, kalibratie, robuustheid en foutkosten. Generatieve evaluatie moet zich richten op getrouwheid, diversiteit, dekking, likelihood of taak‑nut, memorisatie en veiligheid. Een model kan aantrekkelijke monsters produceren terwijl het modi verliest, of een goede likelihood behalen met een slechte perceptuele output. Het nut van synthetische data moet worden getest door downstream‑modellen te trainen en evalueren op onafhankelijke echte data, inclusief zeldzame groepen. Houd testdata buiten generatie‑prompts en selectie.
Bij semi‑supervised leren kan een generatief model ongelabelde structuur benutten; bij anomaliedetectie kan likelihood falen wanneer out‑of‑distribution data een hoge dichtheid krijgt om irrelevante redenen. Bij retrieval‑augmented generation vormen een generatief antwoordmodel en een discriminatieve retriever of re‑ranker een hybride. Diagnoseer fasen afzonderlijk zodat vloeiende output een retrieval‑fout niet verbergt. Kies de decompositie die bewijs en controle waarneembaar maakt.
Implementatie en governance
Generatieve systemen voegen risico’s toe op het gebied van content‑herkomst, intellectueel eigendom, impersonatie, prompt‑injectie en output‑moderatie; discriminatieve systemen brengen risico’s met zich mee op het gebied van drempels, weigering en ongelijke fouten. Beide vereisen gegevensrechten, beveiligde artefacten, versiebeheer, representatieve tests, monitoring en menselijke autoriteit evenredig met de consequenties. Houd het precieze doel en de output‑semantiek bij in de documentatie. Generatief versus discriminatief is een nuttig statistisch onderscheid, maar echte systemen combineren ze vaak, en betrouwbaarheid hangt af van de volledige data‑ en beslissings‑pipeline.
Voorbeeld: classificeren en genereren van ondersteuningsreacties
Een ondersteuningsplatform gebruikt een discriminatieve classifier om het type probleem en de urgentie te identificeren en een generatief model om een reactie op te stellen op basis van goedgekeurde beleidsregels. De classifier wordt geëvalueerd met klassen‑specifieke recall en kalibratie; de retriever met bewijs‑recall; de generator met onderbouwing, juistheid en weigering. Elke fase heeft een onbekende uitkomst, en het generatieve model kan de classificatie of klant‑rechten niet wijzigen via overtuigende tekst.
Agenten zien de voorspelde route, bronnen en het concept en keuren goed of corrigeren vóór verzending. Toestemmingsfilters worden toegepast vóór retrieval, en prompt‑injectie in klanttekst kan geen tools autoriseren. Monitoring scheidt routeringsfouten, retrieval‑gaten, niet‑ondersteunde uitspraken en agent‑bewerkingen. Een beleidswijziging werkt bronnen onmiddellijk bij en triggert regressietests; afstemming is gereserveerd voor stabiel gedrag. Het hybride ontwerp benut discriminatieve en generatieve sterktes terwijl het bewijs en menselijke autoriteit behoudt.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare basislijn en een versie‑gecodeerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, onjuiste of missende invoer, distributieverschuiving, uitval van afhankelijkheden, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend zijn. Meet de taakkwaliteit samen met kalibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde storingen. Operationele telemetrie moet de kwaliteit van invoer, het gedrag van uitvoer, model‑ of regelversie, gezondheid van afhankelijkheden, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige gegevens te verzamelen. Definieer alarm‑drempels en een verantwoordelijke voor respons, en beoordeel vervolgens bewijs uit de praktijk na implementatie in plaats van aan te nemen dat offline prestaties behouden blijven. Evalueer opnieuw wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleidsregels, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerde herstel‑, incident‑leer‑, verwijder‑ en retentieprocedures nodig, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Is de discriminator van een GAN een discriminatief model?
Hij voert discriminatie uit tijdens het trainen, maar de GAN als geheel is een generatief kader waarvan de output wordt geproduceerd door de generator.
Is discriminatief leren altijd begeleid?
Nee. De term beschrijft de gemodelleerde relatie of grens, terwijl supervisie het trainingssignaal beschrijft. Moderne doelstellingen kunnen de categorieën vervagen.
Primaire referenties












