
Anderson의 관점
Stable Diffusion이 직면한 세 가지 과제

 Unite.AI를 Google의 선호 소스에 추가
핵심 포인트Stable Diffusion은 훈련 데이터 주석의 세분화 부족으로 인해 인간의 팔다리 표현에 어려움을 겪습니다.
더 보기
- Stable Diffusion은 훈련 데이터 주석의 세분화 부족으로 인해 인간의 팔다리 표현에 어려움을 겪습니다.
- 타일 기반 업스케일링 방법은 광범위한 문맥 인식 없이 단절된 이미지를 생성할 위험이 있습니다.
- 모델의 기본 해상도 512x512는 출력 품질을 제한하며 복잡한 우회 방법을 필요로 합니다.
몇 주 전 이루어진 공개 는 stability.ai의 Stable Diffusion이라는 잠재 확산 기반 이미지 합성 모델을 세상에 내놓았다. 이는 가장 중요한 기술 공개 중 하나일 수 있다. 1999년 DeCSS 이후로 말이다. AI 생성 이미지 분야에서는 2017년 deepfakes 코드 가 GitHub에 복사되고 분기되어 훗날 DeepFaceLab 와 FaceSwap, 그리고 실시간 스트리밍 deepfake 소프트웨어 DeepFaceLive로 발전한 이래 최대 사건임은 분명하다.
단숨에 사용자들의 불만 이 해소되었다. 그 원인이었던 콘텐츠 제한 은 DALL-E 2 이미지 합성 API에 있었지만, Stable Diffusion의 NSFW 필터는 코드 한 줄만 바꾸면 끌 수 있다는 사실이 드러났기 때문이다. 음란물에 초점을 맞춘 Stable Diffusion Reddit 커뮤니티가 거의 즉시 생겼고 곧바로 폐쇄되었다. 개발자와 사용자는 Discord에서 공식 커뮤니티와 NSFW 커뮤니티로 나뉘었고, Twitter에는 Stable Diffusion으로 만든 환상적인 창작물이 쏟아지기 시작했다.
현재는 이 시스템을 채택한 개발자들이 날마다 놀라운 혁신을 내놓는 듯하다. 플러그인과 외부 보조 도구가 빠르게 작성되어 Krita, Photoshop, Cinema4D, Blender등 여러 응용 프로그램 플랫폼에 적용되고 있다.
한편 프롬프트 작성 기술 은 이제 전문적인 ‘AI와 속삭이기’의 예술이 되었다. ‘Filofax 정리 담당자’ 이후 가장 수명이 짧은 직업이 될 수도 있는 이 기술은 이미 상업화되고 있다. Stable Diffusion의 초기 수익화는 Patreon 수준에서 진행되지만, 더 정교한 서비스도 분명 등장할 것이다. 이는 Conda 기반 소스 코드 설치나 웹 구현의 엄격한 NSFW 필터를 다루기 싫은 사람들을 위한 것이다.
개발 속도와 사용자의 자유로운 탐색이 너무 빨라 앞을 멀리 내다보기 어렵다. 기본적으로 우리는 아직 무엇을 다루고 있는지, 그 모든 한계와 가능성이 무엇인지 정확히 알지 못한다.
그래도 빠르게 형성되고 성장하는 Stable Diffusion 커뮤니티가 맞닥뜨리고, 바라건대 극복할 가장 흥미롭고 어려운 장애물 세 가지를 살펴보자.
1: 타일 기반 처리 파이프라인 최적화
하드웨어 자원과 학습 이미지 해상도의 엄격한 제한을 고려하면, 개발자들은 Stable Diffusion 결과의 품질과 해상도를 모두 높일 우회 방법을 찾아낼 가능성이 크다. 여러 프로젝트가 512×512픽셀에 불과한 기본 해상도 같은 시스템의 한계를 활용할 것이다.
컴퓨터 비전과 이미지 합성 프로젝트에서 늘 그렇듯, Stable Diffusion도 정사각형 이미지로 학습했다. 여기서는 이미지를 512×512로 다시 샘플링해 원본을 규격화하고, 모델을 학습한 GPU의 제약에 맞췄다.
따라서 Stable Diffusion은 ‘생각’한다면 512×512 단위로, 분명 정사각형 틀 안에서 생각한다. 시스템의 한계를 탐색하는 많은 사용자는 이 상당히 제한된 화면비에서 가장 안정적이고 오류가 적은 결과를 얻는다고 말한다(아래 팔다리 문제 참조).
여러 구현은 RealESRGAN 으로 해상도를 높일 수 있다( GFPGAN 으로 잘못 생성된 얼굴도 고칠 수 있다). 하지만 일부 사용자는 이미지를 512×512픽셀 구역으로 나눠 이어 붙이고 더 큰 합성 작품을 만드는 방법을 개발하고 있다.

이 1024×576 렌더링은 보통 Stable Diffusion의 단일 생성으로는 불가능한 해상도지만, DoggettX Stable Diffusion 분기의 attention.py Python 파일을 다른 분기에 복사해 만들었다. 해당 분기는 타일 기반 확대를 구현한다. 출처: https://old.reddit.com/r/StableDiffusion/comments/x6yeam/1024x576_with_6gb_nice/
이런 시도 중 일부는 자체 코드나 다른 라이브러리를 사용하지만, GOBIG의 txt2imghd 포트 는 조만간 이 기능을 주 개발 분기에 제공할 예정이다. GOBIG는 VRAM을 많이 소비하는 ProgRockDiffusion의 모드다. txt2imghd는 GOBIG를 전용으로 이식한 것이며, 다른 커뮤니티 개발자들은 GOBIG를 다르게 구현하고 있다.

이 사례에 적합한 추상 이미지의 원래 512×512픽셀 렌더링(왼쪽과 왼쪽에서 두 번째). 이제 거의 모든 Stable Diffusion 배포판에 기본으로 들어가는 ESGRAN으로 확대했고, GOBIG 구현을 통해 ‘특별한 주의’를 부여했다. 적어도 해당 이미지 구역 안에서는 더 잘 확대된 듯한 세부 정보가 생긴다. 출처: https://old.reddit.com/r/StableDiffusion/comments/x72460/stable_diffusion_gobig_txt2imghd_easy_mode_colab/
이 추상 사례에는 자기 구역만 바라보는 확대 방식에 적합한 세부 정보의 ‘작은 왕국’이 많다. 그러나 반복되지 않고 일관되며 여러 조각을 모아 만든 것처럼 보이지 않는 확대 결과를 얻으려면 더 어려운 코드 기반 해결책이 필요할 수 있다. 특히 사람 얼굴의 어긋남이나 거슬리는 인공 흔적에 우리는 매우 민감하다. 따라서 얼굴은 결국 전용 해법이 필요할 수도 있다.
Stable Diffusion에는 아직 사람이 얼굴 정보를 우선하듯 렌더링 중 얼굴에 주의를 집중하는 장치가 없다. Discord의 일부 개발자가 이런 ‘강화된 주의’의 구현을 검토하고 있지만, 현재는 첫 렌더링 후 얼굴을 수동으로 개선하는 편이 훨씬 쉽다. 장차 자동화될 수도 있다.
사람 얼굴에는 건물 아래쪽 모서리 같은 ‘타일’에 없는 내부적이고 완결된 의미 논리가 있다. 따라서 현재는 Stable Diffusion 결과의 거친 스케치 같은 얼굴을 확대해 다시 렌더링하는 방법이 매우 효과적이다.

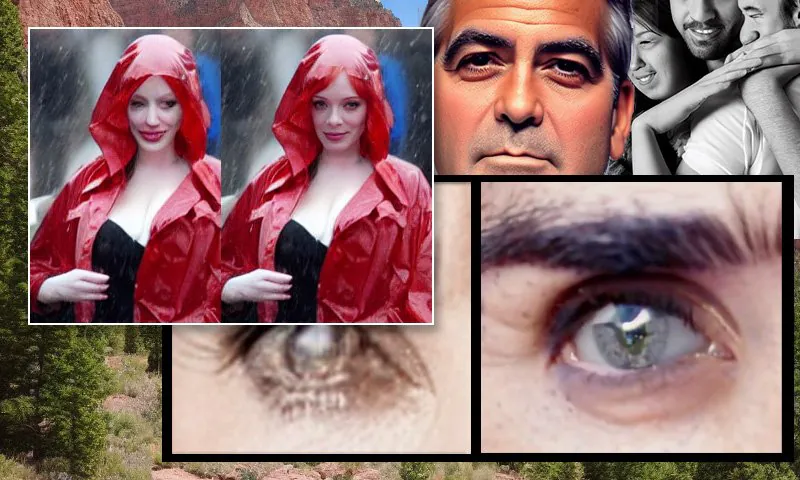
왼쪽: ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’ 프롬프트에 대한 Stable Diffusion의 첫 시도. 오른쪽: 첫 결과의 흐릿하고 거친 얼굴을 Img2Img로 다시 입력해 Stable Diffusion의 주의를 집중시켜 개선한 얼굴(아래 움직이는 이미지 참조).
전용 Textual Inversion 해법이 없다면(아래 참조), 이 방법은 Stable Diffusion 학습에 쓰인 LAION 하위 집합에 이미 충분히 포함된 유명인 이미지에만 통한다. 따라서 Tom Cruise, Brad Pitt, Jennifer Lawrence 등 원본 데이터에 사진이 많은 제한된 수의 실제 미디어 유명인에게 적용된다.
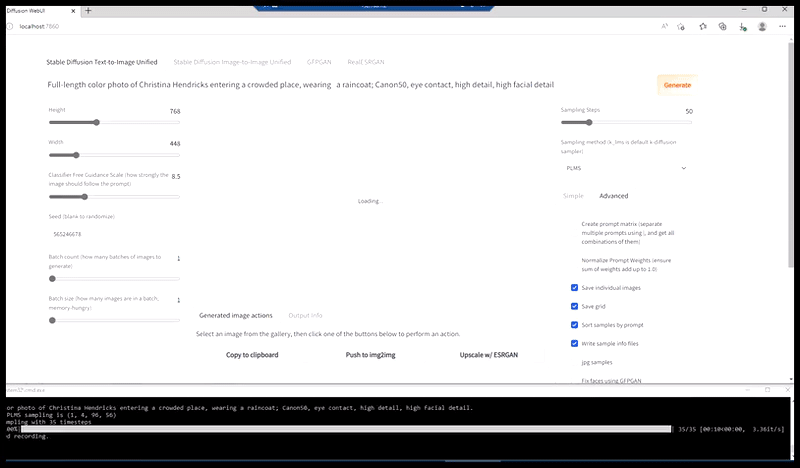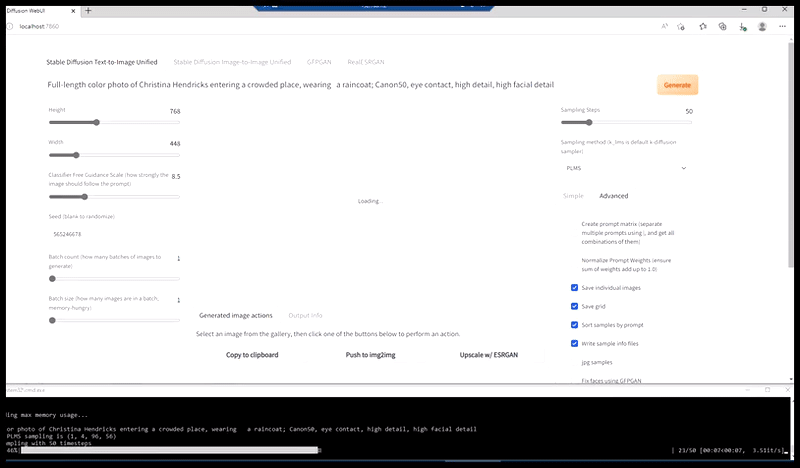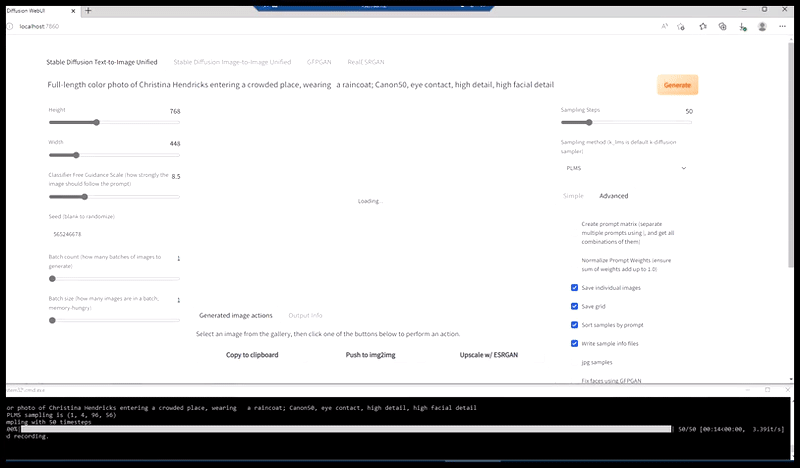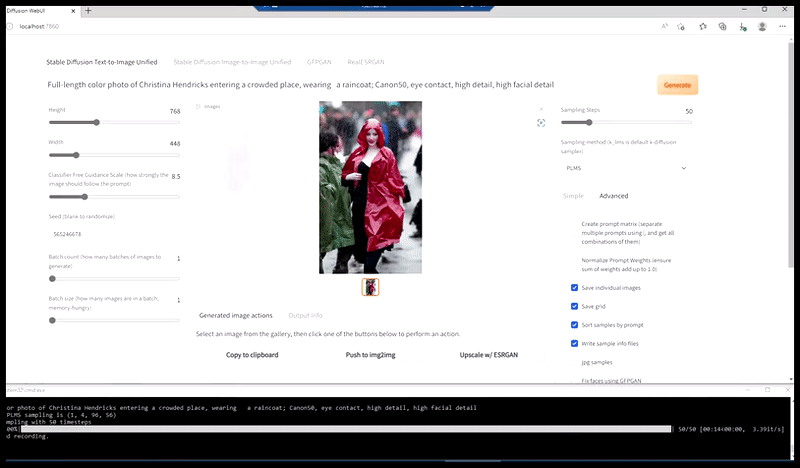
‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’ 프롬프트로 그럴듯한 보도 사진 만들기.
오랜 기간 활동한 유명인에 대해서는 Stable Diffusion이 보통 최근, 즉 더 나이 든 모습의 이미지를 생성한다. 더 젊어 보이는 이미지를 만들려면 프롬프트에 ‘young’ 또는 ‘in the year [YEAR]’ 같은 말을 덧붙여야 한다.

거의 40년 동안 두드러지고 꾸준한 경력을 이어 오며 사진도 많이 찍힌 배우 Jennifer Connelly는 LAION에서 Stable Diffusion이 다양한 나이를 표현할 수 있게 해 주는 몇 안 되는 유명인이다. 출처: 미리 구성된 로컬 Stable Diffusion, v1.4 체크포인트; 나이 관련 프롬프트.
이는 주로 2000년대 중반부터 값비싼 감광 유제 방식 대신 디지털 보도 사진이 널리 쓰였고, 이후 광대역 속도가 빨라지면서 이미지 생산량이 늘어난 결과다.
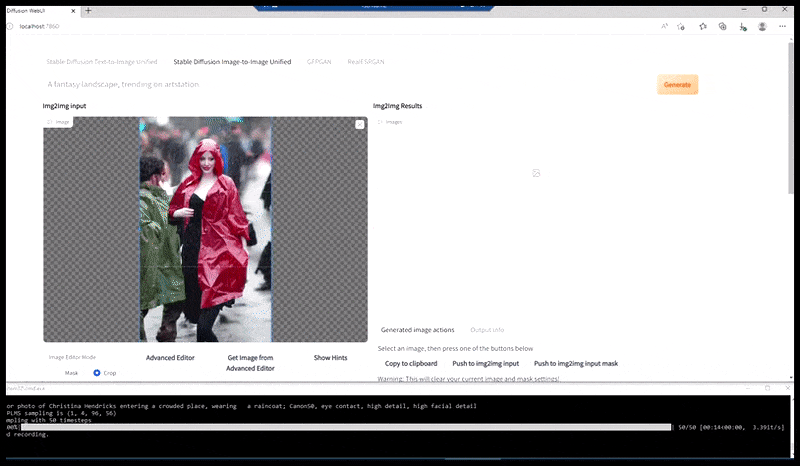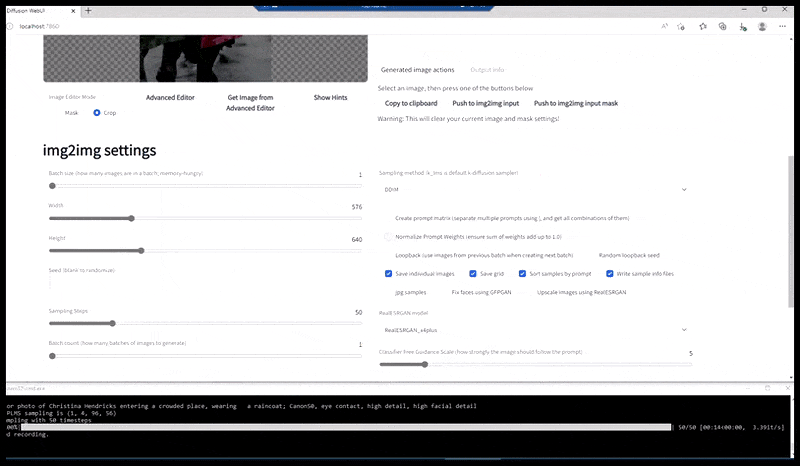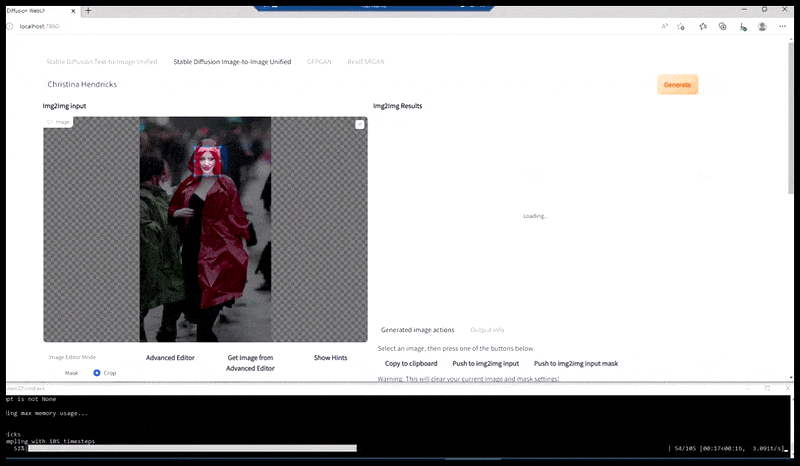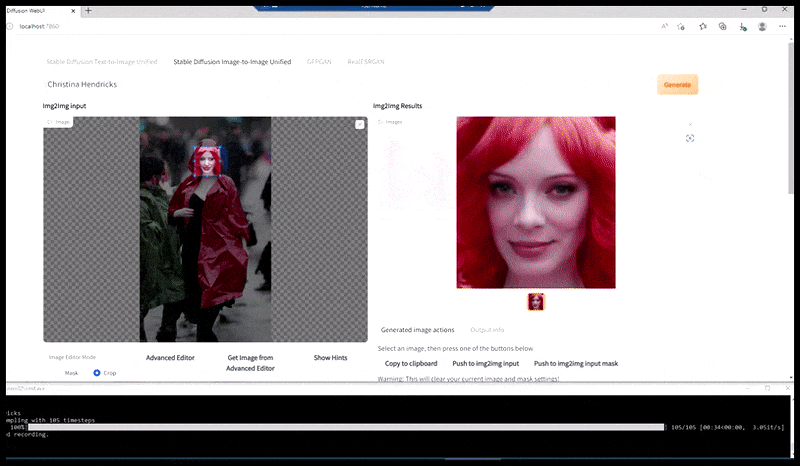
생성된 이미지를 Stable Diffusion의 Img2Img에 전달한 뒤 ‘집중 영역’을 선택하고 그 부분만 최대 크기로 새로 렌더링한다. Stable Diffusion이 얼굴을 재구성하는 데 모든 자원을 집중할 수 있다.
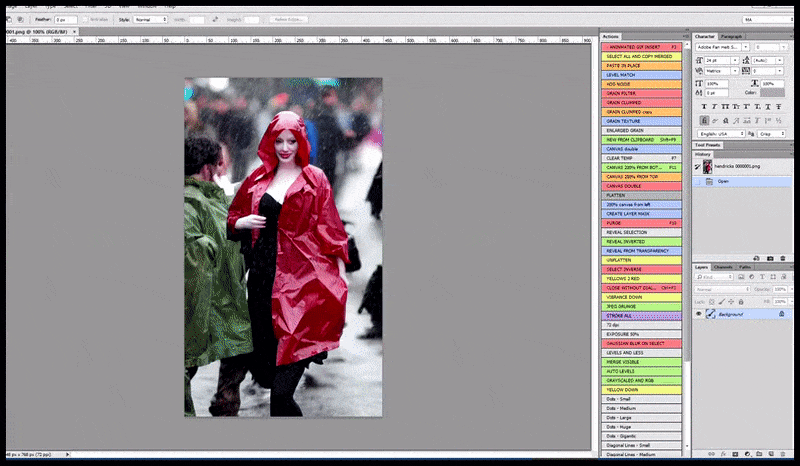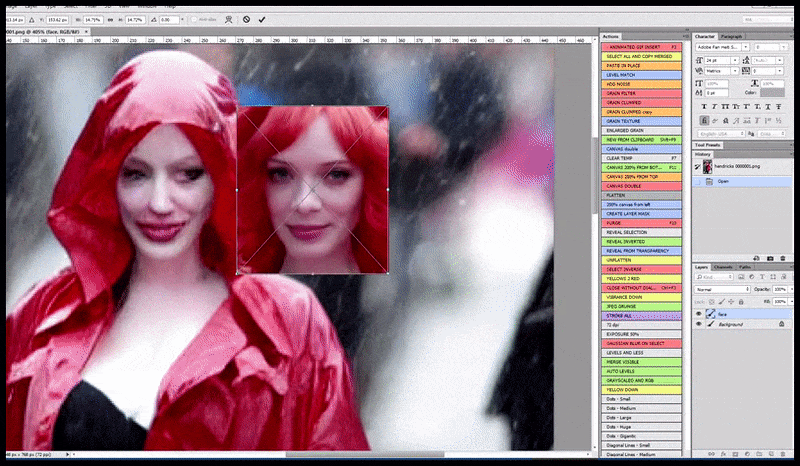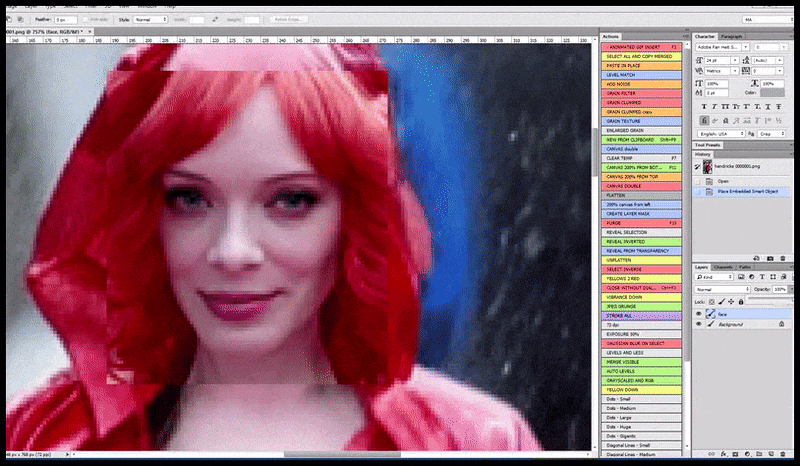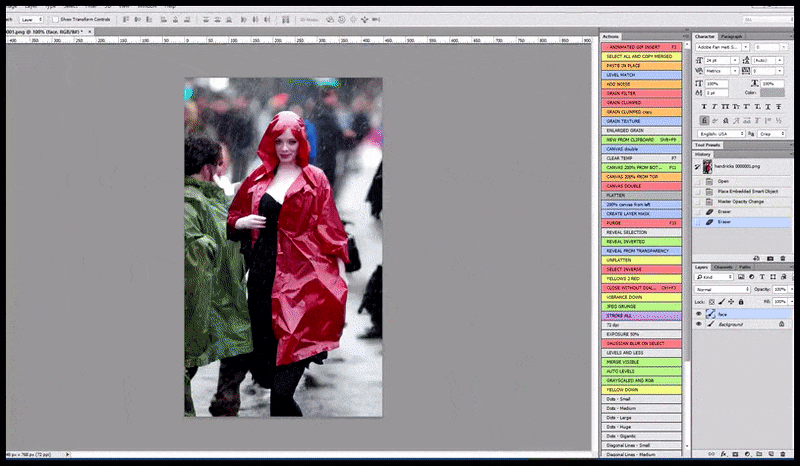
‘높은 주의’로 만든 얼굴을 원래 렌더링에 합성한다. 얼굴 외에는 외관이 알려져 있고 일관되며 완결될 수 있는 대상에만 적용된다. 예를 들어 원본 사진 일부에 시계나 자동차 같은 뚜렷한 물체가 있는 경우다. 벽 일부를 확대하면 다시 조립한 벽이 매우 이상해질 것이다. 타일을 생성할 때 이 ‘퍼즐 조각’의 더 넓은 문맥이 없었기 때문이다.
데이터베이스의 어떤 유명인은 이미 시간 속에 ‘고정’되어 있다. Marilyn Monroe처럼 일찍 세상을 떠났거나, 짧은 기간만 대중적 주목을 받아 한정된 시기에 많은 이미지가 만들어졌기 때문이다. Stable Diffusion에 질문하는 것은 현대와 과거 스타의 일종의 ‘현재’ 인기 지표를 제공한다고 볼 수 있다. 과거와 현재의 일부 유명인은 원본 데이터에 사진이 충분하지 않아 매우 닮은 모습을 얻기 어렵다. 반대로 오래전 사망하거나 잊힌 특정 스타의 꾸준한 인기는 시스템에서 꽤 닮은 모습을 얻도록 해 준다.

Stable Diffusion 결과는 어떤 유명인의 얼굴이 학습 데이터에 충분히 포함되는지 금세 보여 준다. 작성 당시 십대 후반으로 엄청난 인기를 누렸던 Millie Bobby Brown도 LAION 원본 데이터가 웹에서 수집되었을 때는 더 어리고 덜 알려져 있었다. 그래서 현재 Stable Diffusion으로 매우 닮은 고품질 모습을 만드는 데 어려움이 있다.
데이터가 있으면 Stable Diffusion의 타일 기반 확대는 단순한 얼굴 집중을 넘어설 수 있다. 얼굴 특징을 나누고 재조립 전에 각각의 두드러진 특징에 로컬 GPU의 모든 자원을 쏟으면 더 정밀하고 상세한 얼굴을 만들 수 있다. 이 역시 현재는 수작업이다.

이것은 얼굴만의 문제는 아니지만, 전체 물체의 문맥 안에서 적어도 그만큼 예측 가능한 위치에 있으며 초대규모 데이터셋에서 충분히 기대할 만한 상위 수준 임베딩에 맞는 물체 부분으로 제한된다.
실제 한계는 데이터셋에서 쓸 수 있는 참조 데이터의 양이다. 지나치게 반복해 세밀하게 만든 정보는 결국 완전히 ‘환각’, 즉 허구가 되어 진실성이 떨어진다.
Jennifer Connelly는 다양한 연령대가 LAION-aesthetics 에 잘 나타나기 때문에 이런 세밀한 확대가 통한다. 이 데이터는 LAION 5B 에서 Stable Diffusion이 쓰는 주요 하위 집합이며, LAION 전체에서도 그녀의 이미지가 풍부하다. 다른 많은 경우에는 데이터 부족으로 정확도가 떨어지므로 미세 조정, 즉 추가 학습(아래 ‘맞춤화’ 참조), 또는 Textual Inversion(아래 참조)이 필요하다.
타일은 Stable Diffusion으로 고해상도 결과를 얻는 강력하고 비교적 저렴한 방식이다. 그러나 더 넓고 상위 수준의 주의 장치가 없으면 이런 알고리즘 기반 타일 확대는 여러 종류의 콘텐츠에서 기대 수준에 못 미칠 수 있다.
2: 사람의 팔다리 문제 해결
사람의 신체 말단을 복잡하게 묘사할 때 Stable Diffusion은 그 이름만큼 안정적이지 않다. 손이 무작위로 늘고, 손가락이 합쳐지며, 세 번째 다리가 느닷없이 나타나거나 기존 팔다리가 흔적 없이 사라질 수 있다. 다만 다른 비슷한 모델도 이 문제를 공유하며 DALL-E 2 역시 분명 그렇다.

2022년 8월 말 DALL-E 2와 Stable Diffusion(1.4)의 수정하지 않은 결과. 둘 다 팔다리 문제가 나타난다. 프롬프트는 ‘A woman embracing a man’이다.
더 집중적으로 학습하고 매개변수도 개선한 다음 1.5 체크포인트가 팔다리 혼동을 해결하리라 기대하는 Stable Diffusion 팬은 실망할 가능성이 크다. 새 모델은 약 2주 뒤공개될 예정이며, 현재 stability.ai의 상용 포털 DreamStudio에서 먼저 선보이고 있다. 이 서비스는 기본으로 1.5를 사용하며, 사용자는 새 결과를 자신의 로컬 또는 다른 1.4 시스템의 렌더링과 비교할 수 있다.

출처: 로컬 1.4 사전 구성 패키지 및 https://beta.dreamstudio.ai/

출처: 로컬 1.4 사전 구성 패키지 및 https://beta.dreamstudio.ai/

출처: 로컬 1.4 사전 구성 패키지 및 https://beta.dreamstudio.ai/
흔히 그렇듯 데이터 품질이 주된 원인일 수 있다.
Stable Diffusion과 DALL-E 2 같은 이미지 합성 시스템에 데이터를 제공하는 공개 데이터베이스는 개별 사람과 사람 사이의 행동 모두에 많은 레이블을 제공할 수 있다. 레이블은 관련 이미지나 이미지 일부와 상호 연결되어 학습된다.

Stable Diffusion 사용자는 LAION-aesthetics 데이터셋에 질의해 모델이 학습한 개념을 살펴볼 수 있다. 이는 시스템에 데이터를 제공하는 더 큰 LAION 5B 데이터셋의 하위 집합이다. 이미지는 레이블의 알파벳순이 아니라 ‘미적 점수’순으로 정렬된다. 출처: https://rom1504.github.io/clip-retrieval/
사람 팔을 묘사하는 개별 레이블과 범주의 좋은 계층 구조 는 대략 다음과 같을 것이다. body>arm>hand>fingers>[sub digits + thumb]> [digit segments]>Fingernails.

손의 여러 부분에 대한 세밀한 의미 분할. 이렇게 유난히 자세히 분해해도 각 ‘손가락’을 단일 개체로 남겨 두므로 일반 손가락의 세 마디와 엄지의 두 마디를 고려하지 않는다. 출처: https://athitsos.utasites.cloud/publications/rezaei_petra2021.pdf
실제로 전체 데이터셋의 원본 이미지가 이처럼 일관되게 주석 처리될 가능성은 낮다. 비지도 레이블링 알고리즘은 아마 상위 수준, 예를 들어 ‘손’에서 멈추고 내부 픽셀을 레이블 없는 덩어리로 남겨 둘 것이다. 그 안에는 기술적으로 ‘손가락’ 정보가 있지만, 특징이 임의로 추출되어 이후 렌더링에서 어색한 요소로 나타날 수 있다.

마땅히 그래야 하는 모습(오른쪽 위, 어퍼컷이 아니라면)과 흔히 생기는 모습(오른쪽 아래). 이는 레이블링 자원이 부족하거나 데이터에 레이블이 있더라도 구조적으로 활용하는 방식이 제한되기 때문이다.
따라서 잠재 확산 모델이 팔을 렌더링할 수 있다면 거의 확실히 그 끝에 손을 만들려고 할 것이다. 왜냐하면 arm>hand 은 필요한 최소 계층 구조이며, 모델 구조가 아는 ‘인체 해부학’에서 상당히 높은 수준이기 때문이다.
그 다음에는 ‘손가락’이 가장 작은 묶음일 수도 있다. 하지만 사람 손을 묘사하려면 손가락과 엄지의 하위 부분 14개를 더 고려해야 한다.
이 이론이 맞으면 실질적인 해결책은 없다. 업계 전반에 수동 주석 예산이 부족하고, 낮은 오류율로 레이블링을 자동화할 충분히 효과적인 알고리즘도 없기 때문이다. 사실 모델은 현재 인체 구조의 일관성에 의존해 학습 데이터의 결점을 덮고 있을 수도 있다.
모델이 이것을 믿을 수 없는 한 가지 가능한 이유가 최근 Stable Diffusion Discord에서 제안되었다 . 모델을 뒷받침하는 LAION 데이터베이스에는 손가락이 적은 만화 캐릭터가 있어, 실제 사람 손의 올바른 손가락 수를 혼동할 수 있다는 것이다(그 자체가 작업량을 줄이는 지름길이다).

Stable Diffusion과 비슷한 모델의 ‘손가락 실종’ 문제에 기여했을 가능성이 있는 두 캐릭터. 아래는 Stable Diffusion에 쓰이는 LAION-aesthetics 데이터셋의 만화 손 예시다. 출처: https://www.youtube.com/watch?v=0QZFQ3gbd6I
이것이 사실이라면 명백한 해결책은 비현실적인 인간형 콘텐츠를 제외하고 모델을 재학습하되, 실제 결손, 예를 들어 절단 장애인의 경우는 예외로 올바르게 표시하는 것이다. 데이터 정리 측면만 보더라도 매우 어렵고, 자원이 부족한 커뮤니티 프로젝트에는 특히 큰 도전이다.
두 번째 접근은 렌더링할 때 ‘손가락이 세 개/다섯 개인 손’ 같은 콘텐츠가 나타나지 않게 필터를 적용하는 것이다. 이는 OpenAI가 어느 정도 필터링한 GPT-3와 DALL-E 2의 경우와 비슷하며, 원본 모델을 다시 학습하지 않고도 출력을 조절할 수 있다.

Stable Diffusion에서는 손가락뿐 아니라 팔다리의 의미 구분도 끔찍하게 흐려져, David Cronenberg 같은 감독의 1980년대 공포 영화에 등장하는 ‘보디 호러’ 계열을 떠올리게 한다. 출처: https://old.reddit.com/r/StableDiffusion/comments/x6htf6/a_study_of_stable_diffusions_strange_relationship/
그러나 이 또한 관련 이미지 전부에 존재하지 않을 수 있는 레이블이 필요하므로 같은 관리와 예산 문제가 남는다.
남은 길은 두 가지라고 볼 수 있다. 더 많은 데이터를 투입하거나, 여기 묘사한 신체적 오류가 최종 사용자에게 제시될 때 개입하는 외부 해석 시스템을 적용하는 것이다. 적어도 후자는 OpenAI가 원한다면 ‘보디 호러’ 결과에 환불을 제공할 방법을 줄 것이다.
3: 맞춤화
Stable Diffusion 미래의 가장 흥미로운 가능성 중 하나는 사용자나 조직이 수정된 시스템을 개발하는 것이다. 이는 미리 학습된 LAION 범위 밖의 콘텐츠를 시스템에 통합한다. 이상적으로는 전체 모델을 다시 학습하는 통제 불가능한 비용이나 이미 성숙하고 유능한 모델에 새 이미지를 대량 학습하는 위험이 없어야 한다.
비유하자면, 30명의 심화반에 능력이 상대적으로 부족한 학생 둘이 들어오면 적응해 따라잡거나 예외적으로 실패할 것이다. 어느 경우든 반의 평균 성과는 아마 영향을 받지 않는다. 하지만 그런 학생 15명이 들어오면 반 전체 성적 분포가 나빠질 가능성이 크다.
이와 마찬가지로 지속적이고 비싼 모델 학습으로 형성된 상호 협력적이며 섬세한 관계망은 새 데이터가 지나치게 많으면 손상되고, 일부 경우 사실상 파괴되어 모델 전반의 결과 품질이 떨어질 수 있다.
이렇게 할 주요 이유는 관계와 사물에 대한 모델의 개념적 이해를 완전히 가져다가, 추가한 자료와 비슷한 콘텐츠만 생산하는 데 전용하려는 경우다.
따라서 기존 Stable Diffusion 체크포인트에 500,000개의 Simpsons 프레임을 학습하면 결국 원래 버전보다 더 나은 Simpsons 시뮬레이터를 얻을 가능성이 크다. 단, 광범위한 의미 관계가 충분히 살아남아야 한다. 예를 들어 Homer Simpson eating a hotdog에는 추가 자료에 없지만 원래 체크포인트에는 있었던 핫도그 관련 정보가 필요할 수 있다. 또 갑자기 Simpsons 콘텐츠에서 fabulous landscape by Greg Rutkowski 같은 창작으로 바꾸고 싶지 않다고 가정해야 한다. 추가 학습된 모델의 주의가 크게 다른 곳으로 돌려져 예전만큼 그런 작업을 잘하지 못하기 때문이다.
대표적 사례로 waifu-diffusion이 있다. 이는 성공적으로 56,000장의 애니메이션 이미지로 추가 학습 을 완전히 학습된 Stable Diffusion 체크포인트에 수행했다. 다만 취미 사용자가 하기에는 어렵다. 모델이 최소 30GB VRAM을 요구해 NVIDIA의 곧 출시될 40XX 시리즈 소비자 제품에서 기대할 수 있는 용량을 훨씬 넘기 때문이다.

waifu-diffusion으로 Stable Diffusion에 맞춤 콘텐츠를 학습한 사례. 이 수준의 일러스트를 만들기까지 2주간 추가 학습했다. 왼쪽 여섯 장은 새로운 학습 데이터를 기반으로 주제가 일관된 결과를 만드는 과정에서 모델이 어떻게 나아졌는지 보여 준다. 출처: https://gigazine.net/gsc_news/en/20220121-how-waifu-labs-create/
Stable Diffusion 체크포인트의 이런 분기에 많은 노력을 쏟아도 기술 부채에 막힐 수 있다. 공식 Discord 개발자들은 후속 체크포인트가 반드시 이전 버전과 호환되지는 않는다고 이미 밝혔다. 과거에 통했던 프롬프트 논리조차 마찬가지다. 주된 관심사는 오래된 응용 프로그램과 절차의 지원이 아니라 가능한 최고의 모델을 얻는 데 있기 때문이다.
따라서 체크포인트를 분기해 상용 제품으로 만드는 회사나 개인에게는 사실상 돌아갈 길이 없다. 그 시점의 모델은 ‘하드 포크’이며, stability.ai 후속 버전의 원래 개발 계통에서 얻은 개선을 받아들일 수 없다. 상당한 결단이다.
현재 Stable Diffusion 맞춤화의 더 큰 희망은 Textual Inversion이다. 사용자가 소수의 CLIP정렬 이미지를 학습시키는 방식이다.

텔아비브 대학교와 NVIDIA가 공동 개발한 Textual Inversion은 원본 모델의 능력을 파괴하지 않고 별개의 새로운 개체를 학습하게 한다. 출처: https://textual-inversion.github.io/
Textual Inversion의 가장 뚜렷한 한계는 매우 적은 이미지, 다섯 장 정도까지 적은 수가 권장된다는 것이다. 이는 제한된 개체를 만들어 사진처럼 사실적인 물체를 넣기보다는 스타일 전이에 더 유용할 수 있다.
그렇지만 현재 여러 Stable Diffusion Discord에서 훨씬 더 많은 학습 이미지로 실험하고 있으며, 이 방식이 얼마나 유용할지는 지켜봐야 한다. 역시 많은 VRAM과 시간, 인내가 필요하다.
이런 한계 때문에 Stable Diffusion 애호가들의 좀 더 정교한 Textual Inversion 실험을 보기까지 기다려야 할 수도 있다. 이 방식이 공식 체크포인트의 놀라운 기능을 유지하면서 Photoshop으로 잘라 붙이는 것보다 더 나은 모습으로 ‘사진 속에 나를 넣을’ 수 있을지도 알아봐야 한다.
최초 게시: 2022년 9월 6일.


