
Anderson의 관점
머신러닝으로 비디오 속 객체를 더 효율적으로 제거하기

 Unite.AI를 Google의 선호 소스에 추가
핵심 포인트E2FGVI는 세 가지 비디오 인페인팅 단계를 하나의 엔드투엔드 시스템으로 통합하여 큰 효율성 향상을 이룹니다.
더 보기
- E2FGVI는 세 가지 비디오 인페인팅 단계를 하나의 엔드투엔드 시스템으로 통합하여 큰 효율성 향상을 이룹니다.
- 이 시스템은 기존 광학 흐름 방식보다 15배 빠르게 실행되면서도 최첨단 결과를 달성합니다.
- 새로운 시간적 초점 트랜스포머는 어텐션을 2D에서 3D로 확장하여 프레임 전반에 걸쳐 일관된 콘텐츠 환각을 가능하게 합니다.
중국에서 발표된 새로운 연구는 비디오 인페인팅 시스템에 대한 최첨단 결과와 효율성의인상적인 향상을 보고하고 있습니다. 이 시스템은 영리하게 객체를 제거할 수 있습니다.
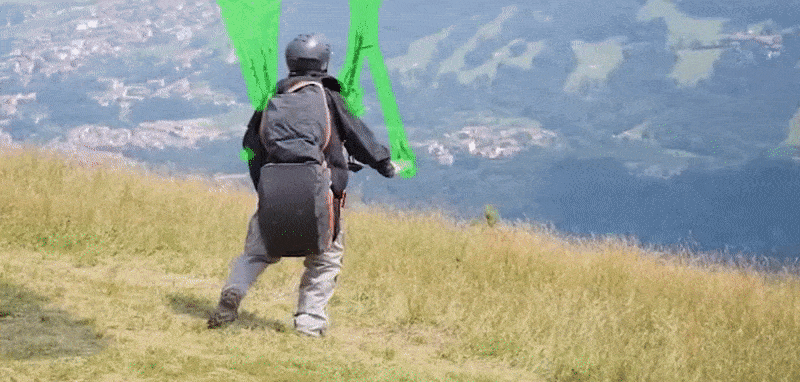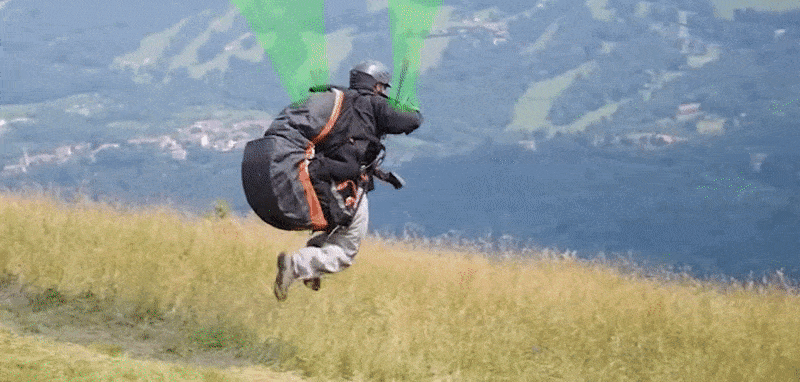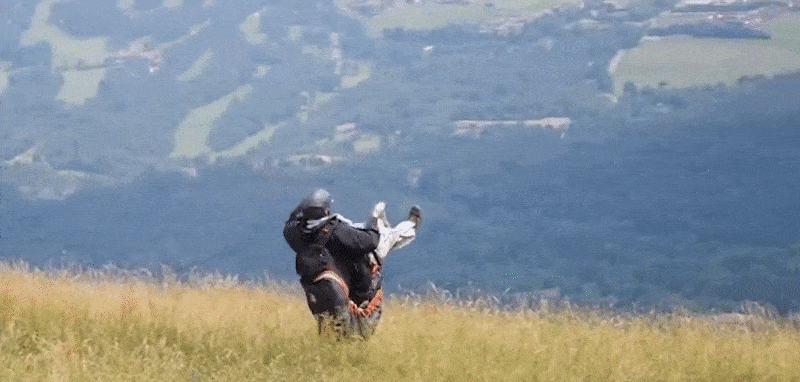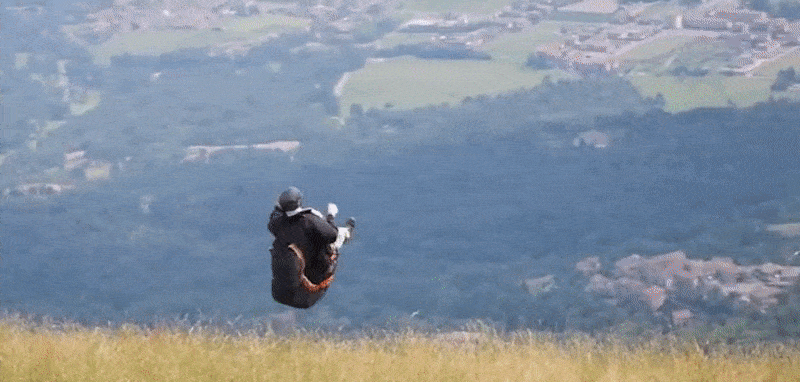
행글라이더 조종사의 하네스가 새로운 절차를 통해 영상에서 지워집니다. 더 나은 해상도와 더 많은 예제를 보려면 소스 비디오를 참조하십시오. 출처: https://www.youtube.com/watch?v=N–qC3T2wc4
이 기술은 End-to-End 프레임워크를 위한 Flow-Guided 비디오 인페인팅 (E2FGVI)이라고 불리며, 또한 워터마크와 다양한 종류의 오쿠루션을 비디오 콘텐츠에서 제거할 수 있습니다.
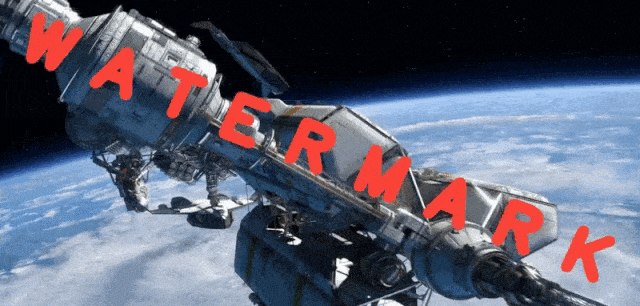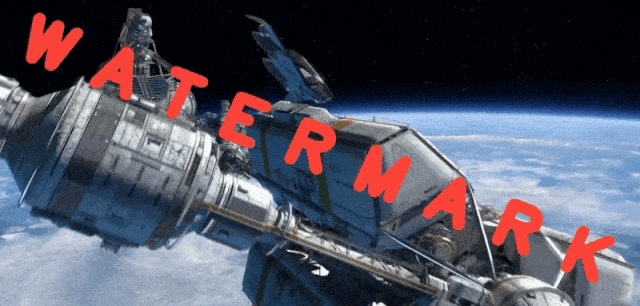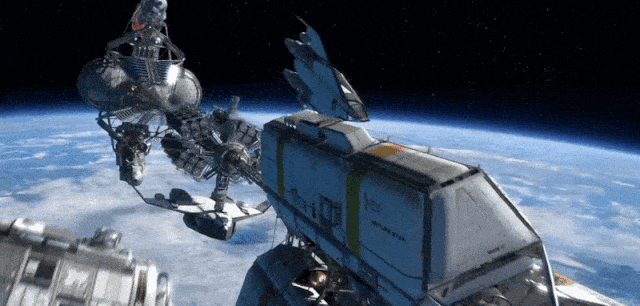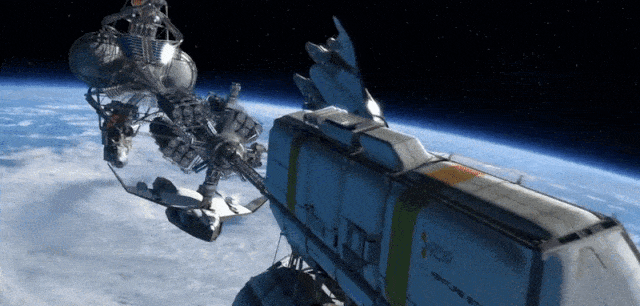
E2FGVI는 오쿠루션 뒤에 있는 콘텐츠에 대한 예측을 계산하여 심지어 눈에 잘 띄고 제거하기 어려운 워터마크까지도 제거할 수 있습니다. 출처: https://github.com/MCG-NKU/E2FGVI
(더 많은 예제를 더 나은 해상도로 보려면 비디오를 참조하십시오)
발표된 논문에 포함된 모델은 432px x 240px 비디오(공통적으로 낮은 입력 크기, 사용 가능한 GPU 메모리와 최적의 배치 크기 사이의 균형 및 기타 요인에 의해 제한됨)에 대해 훈련되었지만, 저자들은 이후에 임의의 해상도를 처리할 수 있는 E2FGVI-HQ를 출시했습니다.
현재 버전의 코드는 GitHub에서 사용할 수 있으며, HQ 버전은 지난 일요일에 출시되어 Google Drive 와 Baidu Disk에서 다운로드할 수 있습니다.

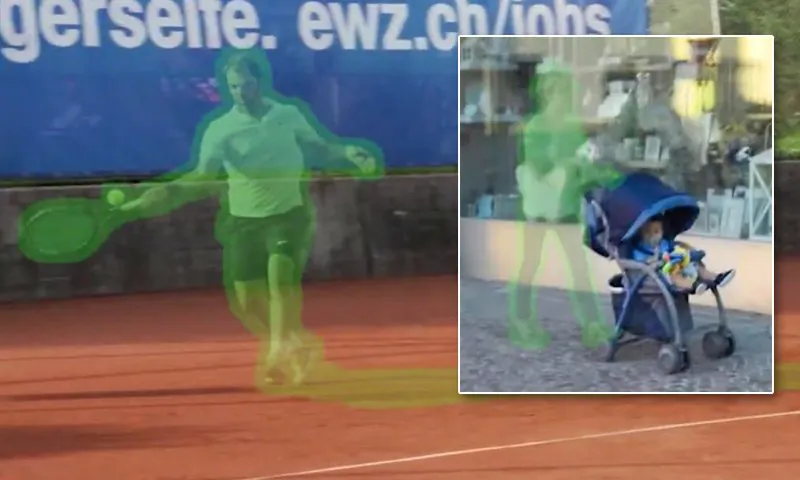
아이만 사진에 남습니다.
E2FGVI는 432×240 비디오를 프레임당 0.12초의 속도로 Titan XP GPU(12GB VRAM)에서 처리할 수 있으며, 저자들은 이 시스템이 광학 흐름 기반의 이전 최첨단 방법보다 15배 빠르다고 보고합니다.
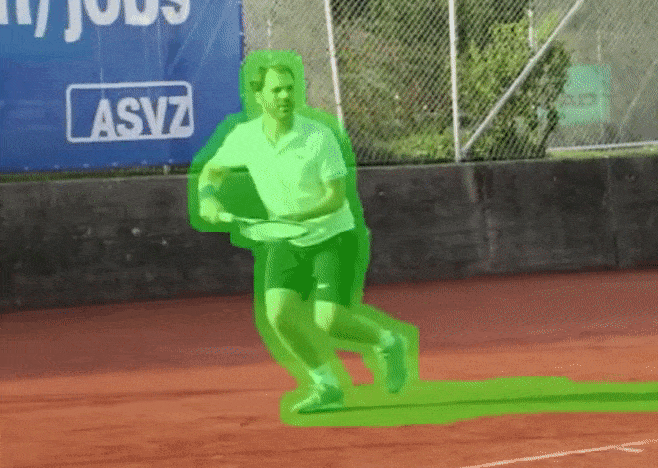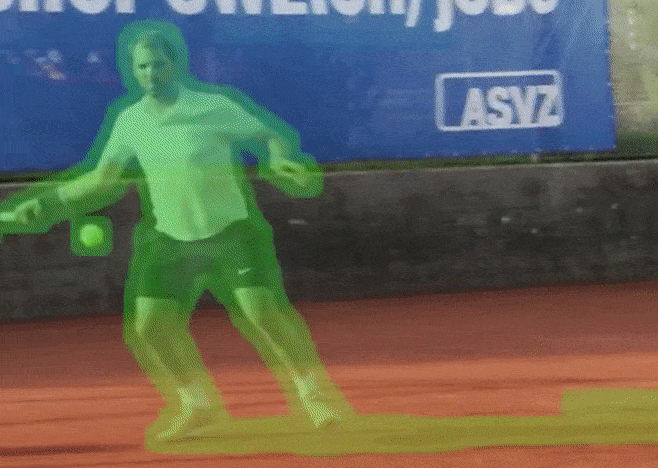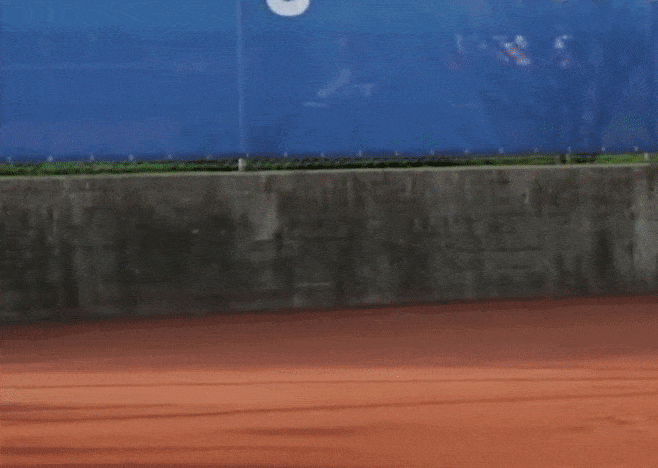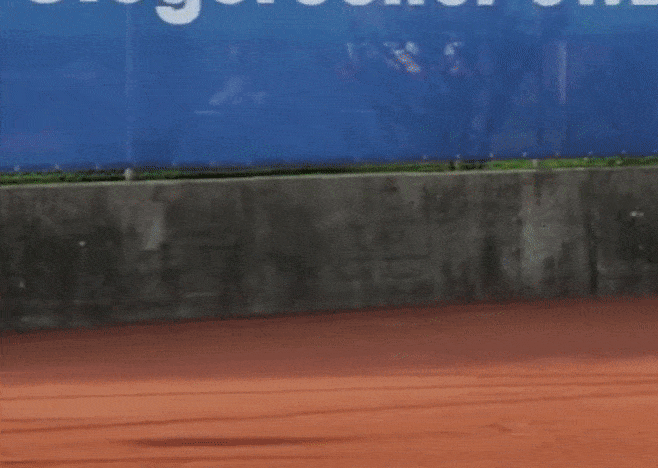
테니스 선수가 예상치 못하게 화면에서 사라집니다.
이 새로운 방법은 표준적인 데이터셋에서 테스트되었으며, 질적 및 양적 평가에서 라이벌들을 능가했습니다.

이전 접근 방식에 대한 테스트. 출처: https://arxiv.org/pdf/2204.02663.pdf
이 논문은 End-to-End 프레임워크를 위한 Flow-Guided 비디오 인페인팅이라고 제목이 붙여져 있으며, 난카이대학교의 4명의 연구자와 함께 Hisilicon Technologies의 연구자와의 공동 연구입니다.
이 그림에서 무엇이 빠져 있나요
고품질의 비디오 인페인팅은 시각적 효과에 대한 명백한 응용 외에도 새로운 AI 기반 이미지 합성 및 이미지 변경 기술의 핵심적인 특징이 될 것입니다.
이것은 특히 바디-변경 패션 애플리케이션과 다른 프레임워크에서 이미지와 비디오의 몸매를 날씬하게 만들거나 변경하려고 하는 경우에 해당합니다. 이러한 경우, 합성에 의해 노출되는 추가 배경을 설득력 있게 ‘채워 넣는’ 것이 필요합니다.

최근의 논문에서 바디 ‘재구성’ 알고리즘이 주제를 다시 크기 조정할 때 새로 노출된 배경을 인페인팅하는 작업을 맡았습니다. 여기서 부족한 부분은 이전에 더 풍만한 몸매를 가진 사람(실제, 왼쪽 이미지 참조)이 차지했던 빨간 윤곽으로 표시됩니다. 출처 자료: https://arxiv.org/pdf/2203.10496.pdf
일관된 광학 흐름
광학 흐름(OF)은 비디오 객체 제거의 개발에서 핵심 기술이 되었습니다. 지도책처럼 OF는 시간 순서로 이어지는 영상의 지도를 한 번에 제공합니다. 컴퓨터 비전에서 속도를 측정하는 데 자주 쓰이는 OF는 시간적으로 일관된 인페인팅도 가능하게 합니다. 작업 전체를 한 번의 처리로 고려하므로, 필연적으로 시간적 불연속을 일으키는 디즈니식 프레임별 처리와 차이가 있습니다.
현재까지의 비디오 인페인팅 방법은 3단계 프로세스에 중점을 두었습니다. 흐름 완성은 비디오를 이산적이고 탐색 가능한 엔티티로 매핑하는 과정입니다. 픽셀 전파은 비디오의 구멍을 양방향으로 전파하여 픽셀을 채우는 과정입니다. 콘텐츠 환각은 추정된 ‘누락된’ 콘텐츠를 만들어 비디오에 삽입하는 과정입니다. 이는 딥페이크나 DALL-E 시리즈 같은 텍스트-이미지 프레임워크에서 익숙한 픽셀의 ‘발명’에 해당합니다.
E2FGVI의 중심적인 혁신은 이러한 3단계를 엔드투엔드 시스템으로 결합하여 수동 작업의 필요성을 제거하는 것입니다.

이 논문은 이전 프로세스에서 수동 개입의 필요성이 GPU를 사용하지 않도록 만들었으며, 시간이 많이 걸린다고 지적합니다. 논문에서*:
‘DFVI를 예로 들어, DAVIS에서 가져온 약 70프레임의 432 × 240 크기 비디오를 완성하는 데 약 4분이 걸리며, 이는 대부분의 실제 응용 프로그램에서 받아들여질 수 없습니다. 또한, 위에서 언급한 단점 외에도, 콘텐츠 환각 단계에서 사전 훈련된 이미지 인페인팅 네트워크만을 사용하는 것은 시간적 이웃 간의 콘텐츠 관계를 무시하여 비디오에서 일관되지 않은 생성 콘텐츠를 생성하게 됩니다.’
E2FGVI는 3단계를 결합하여 2단계인 픽셀 전파를 특징 전파로 대체할 수 있습니다. 이전 작업의 더 세분화된 프로세스에서 특징은 그렇게 광범위하게 사용할 수 없습니다. 이유는 각 단계가 상대적으로 폐쇄적이며, 작업 흐름는 반자동입니다.
또한, 연구자들은 콘텐츠 환각 단계를 위한 시간적 초점 변환기를 고안했습니다. 이는 현재 프레임 픽셀의 직접적인 시간적 이웃, 즉 이전 또는 다음 영상에서 같은 부분에 일어나는 변화뿐만 아니라 여러 프레임 떨어진 이웃까지도 고려하며, 비디오 전체의 일관된 효과에 영향을 미칩니다.

E2FGVI의 아키텍처.
새로운 특징 기반의 중앙 섹션은 더 많은 특징 수준의 프로세스와 학습 가능한 샘플링 오프셋을 활용할 수 있으며, 프로젝트의 새로운 초점 변환기는 저자에 따르면 초점 창의 크기를 2D에서 3D로 확장합니다.
테스트 및 데이터
E2FGVI를 테스트하기 위해, 연구자들은 두 개의 인기 있는 비디오 객체 분할 데이터셋에 대해 시스템을 평가했습니다. YouTube-VOS와 DAVIS입니다. YouTube-VOS는 3741개의 훈련 비디오 클립, 474개의 검증 클립, 508개의 테스트 클립을 특징으로 합니다. DAVIS는 60개의 훈련 비디오 클립과 90개의 테스트 클립을 특징으로 합니다.
E2FGVI는 YouTube-VOS에서 훈련되었으며 두 데이터셋 모두에서 평가되었습니다. 훈련 중에 객체 마스크(위의 이미지에서 녹색 영역 및 동반되는 YouTube 비디오)가 비디오 완성을 시뮬레이션하기 위해 생성되었습니다.
메트릭으로, 연구자들은 피크 신호 대 노이즈 비율(PSNR), 구조적 유사성(SSIM), 비디오 기반 Fréchet 인셉션 거리(VFID), 및 플로우 와핑 오류를 채택했습니다. 후자는 영향을 받은 비디오의 시간적 안정성을 측정하기 위해 사용됩니다.
시스템이 테스트된 이전 아키텍처는 VINet, DFVI, LGTSM, CAP, FGVC, STTN, 및 FuseFormer입니다.

논문의 양적 결과 섹션에서. 위쪽과 아래쪽 화살표는 더 높은 또는 더 낮은 숫자가 더 좋음을 나타냅니다. E2FGVI는 전반적으로 최고의 점수를 달성했습니다. 방법은 FuseFormer에 따라 평가되며, DFVI, VINet 및 FGVC는 엔드투엔드 시스템이 아니므로 FLOPs를 추정할 수 없습니다.
모든 경쟁 시스템에서 최고의 점수를 달성한 것 외에도, 연구자들은 5개의 대표적인 방법으로 변환된 비디오를 개별적으로 20명의 자원자에게 보여주고 시각적 품질에 따라 평가하도록 요청하는 질적 사용자 연구를 수행했습니다.

수직 축은 시각적 품질에 따라 E2FGVI 출력을 선호하는 참가자의 백분율을 나타냅니다.
저자들은 모든 참가자가 그들의 방법을 선호했지만, 하나의 결과인 FGVC는 양적 결과와 일치하지 않으며, 이는 E2FGVI가 오해를 유발하는 방식으로 ‘시각적으로 더 만족스러운 결과’를 생성할 수 있음을 나타낼 수 있다고 제안합니다.
효율성 측면에서, 저자들은 그들의 시스템이 초당 부동소수점 연산(FLOPs)을 크게 줄이고, 단일 Titan GPU에서 DAVIS 데이터셋의 추론 시간을 줄였다고 주장합니다. 또한, 결과는 E2FGVI가 플로우 기반 방법보다 15배 빠르다고 나타냅니다.
그들은 다음과 같이 말합니다:
‘[E2FGVI]는 모든 방법 중에서 가장 낮은 FLOPs를 가지고 있습니다. 이는 제안된 방법이 비디오 인페인팅에 대해 매우 효율적임을 나타냅니다.’
*저자의 인라인 인용을 하이퍼링크로 변환했습니다.
처음으로 2022년 5월 19일에 게시되었습니다.
2025년 10월 28일 화요일에 수정되었습니다. 결함이 있는 비디오 임베드를 제거하고 기사 본문에 대한 임베디드 비디오에 대한 참조를 수정하기 위해.


