
AI 모델 및 플랫폼
애플린의 새로운 오프-더-셸프(OTS) 데이터셋, AI 배포 가속화

 Unite.AI를 Google의 선호 소스에 추가
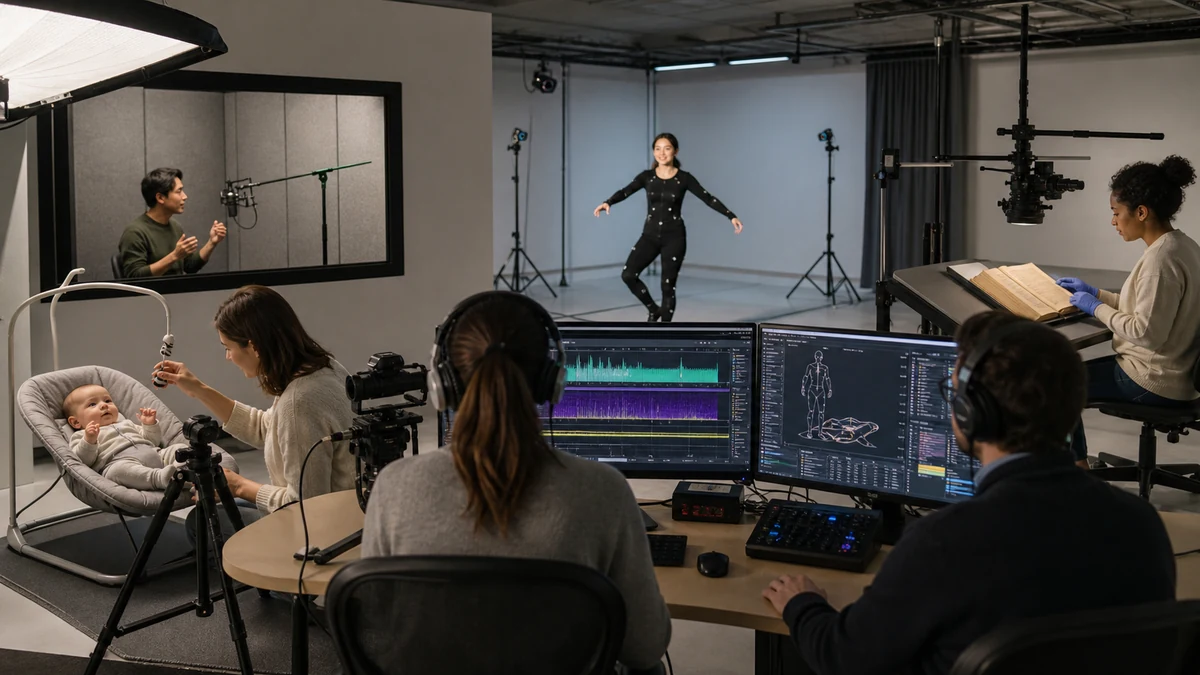
애플린 리미티드(ASX: APX)는 규모 있는 AI 시스템을 구축하는 조직을 위한 고품질 훈련 데이터를 제공하는 선도적인 회사로, 오늘 새로운 오프-더-셸프(OTS) 데이터셋을 발표했습니다. 이러한 데이터셋은 비즈니스들이 자신의 인공 지능(AI) 및 기계 학습(ML) 프로젝트를 가속화하는 데 필요한 고품질 훈련 데이터를 더 쉽게 그리고 빠르게 획득할 수 있도록 설계되었습니다. 새로운 OTS 데이터셋에는 인간 몸의 움직임과 혁신적인 아기 울음 소리, 그리고 아랍어, 크로아티아어, 그리스어, 헝가리어, 태국어 등과 같은 높은 수요지만 khó 구할 수 있는 언어에 적합한 텍스트가 포함된 스크립트된 음성 및 이미지 등이 포함됩니다. 확장된 데이터셋으로 인해 애플린의 총 OTS 제공은 250개 이상의 데이터셋으로 구성되며, 이는 11,000시간 이상의 오디오, 25,000개 이상의 이미지, 80개 언어 및 여러 방언에 걸친 8,700만 단어로 구성됩니다.
애플린의 OTS 데이터셋은 일관된 고품질 훈련 데이터로 AI 또는 ML 프로젝트를 빠르게 시작하는 비용 효율적인 도구입니다. AI 기능을 확장하는 팀은 또한 OTS 데이터셋을 사용하여 효과적으로 정확도를 개선하고 새로운 모델 스킬을 개발하며 기타 개선 사항을 자신의 AI 모델에 통합할 수 있습니다. OTS 데이터셋은 일반적으로 1주일 안에 제공되며, 이는 새로운 데이터셋 수집 및 주석 프로젝트에 필요한 8~12주 또는 더 긴 시간과 비교할 수 있습니다. 모든 애플린 데이터셋은 완전히 투명한 옵트인 방법론을 사용하여 개발되므로 AI 전문가들은 자신의 데이터가 깨끗하고 규정 준수되어 있음을 확신할 수 있으며, 이는 잠재적인 반발 및 명성 손상 위험을 제거합니다.
애플린의 CTO인 윌슨 팡(Wilson Pang)은 “세계 곳곳에서 긴급한 마감일과 유연한 데이터 요구 사항을 가진 프로젝트를 진행하는 AI 팀은 오프-더-셸프 데이터셋을 사용하는 데ประโยชน를 얻을 수 있습니다”라고 말했습니다. “OTS 데이터셋은 가치 실현 시간을 단축하고 전통적인 방법보다 더 낮은 총 비용으로 고품질 데이터에 접근할 수 있도록 합니다. 우리는 애플린에서 모든 데이터셋이 윤리적으로 출처되고 인구 통계적으로 균형된 방법으로 제공되는지 확인하는 데 필요한 단계를 취하고 있습니다. 이는 회사들이 책임 있는 AI 관행을 유지하고 모델의 편향을 최소화하며 데이터 주석자의 공정한 대우를 보장할 수 있도록 합니다. 항상 OTS 데이터셋의 정확한 품질을 알 수 있으며, 이는 실제 세계에서 작동하는 더 나은 AI를 구축하는 데 도움이 됩니다.”
미디어인터페이스(MediaInterface)는 20년 이상 독일과 유럽의 다른 지역에 있는 의료 관련 기관에 언어 기술 솔루션을 제공해 왔습니다. 프랑스로 확장할 때, 회사는 완전히 현지화된 소프트웨어를 가지고 있었지만, 특히 프랑스어 이름과 장소와 같은 프랑스어 렉슨 데이터가 부족했습니다. 이러한 이름과 장소는 종종 환자 건강 정보에 참조됩니다. 애플린의 OTS 데이터셋을 사용하여 미디어인터페이스는 약 21,000개의 프랑스어 이름과 14,000개의 장소 이름을 획득했습니다. 미디어인터페이스의 제품 매니저 인ες 웬들러(Ines Wendler)는 “애플린의 임계 데이터를 우리의 백그라운드 렉슨에 통합하여 새로운 시장에서 성공적으로 출시할 수 있었으며, 이는 우리가 고객을 위해 새로운 어휘를 구축하고 향후 시장 출시를 강화하는 데 도움이 됩니다”라고 말했습니다.
가장 경험 많은 AI 전문가들은 자신의 복잡한 AI 모델 훈련 데이터 요구를 충족하기 위해 OTS 데이터셋과 주문형 데이터 수집 및 주석 프로젝트를 결합합니다. 애플린은 지속적인 지원을 제공하는 선도적인 회사로, 데이터 수집 서비스와 같은 특정 서비스를 제공하며, 이는 효율성을 최대화하기 위해 AI 파워드 도구와 자동화된 워크플로우를 통해 제공됩니다.
애플린의 AI 전문가 선임 디렉터인 주디스 비숍(Judith Bishop)은 “우리는 아침에 일어날 때부터 밤에 잠들 때까지 가상 어시스턴트, 챗봇, 검색 엔진, 소셜 네트워크, 의료 기기, 스마트 카 및 기타 애플리케이션을 통해 AI와 상호 작용합니다”라고 말했습니다. “언어는 이러한 많은 매력적인 AI 사용 사례에서 종종 주요 인터페이스이므로, 모델이 모든 사람에게 작동하도록 훈련되어야 합니다. 애플린의 고품질 데이터와 책임 있는, 윤리적인 AI 개발에 대한 약속은 회사들이 우리의 오프-더-셸프 데이터셋을 구매하여 자신의 AI 프로젝트를 완전한 확신으로 가속화할 수 있도록 합니다.”
애플린의 기존 수백 개의 데이터셋에 추가된 새로운 OTS 데이터셋 목록은 다음과 같습니다:
- 아랍어(이집트), 아랍어(사우디 아라비아), 아랍어(아랍 에미리트), 중부 크메르어(캄보디아), 크로아티아어, 그리스어, 헝가리어, 폴란드어, 스페인어(스페인), 터키어를 위한 스크립트된 음성
- 중국어 간체 문자 인쇄 텍스트, 태국어 인쇄 텍스트, 핀란드어 인쇄 텍스트를 위한 이미지 OCR – 전자 간판, 외장 패키징, 표지, 잡지, 메뉴 등을 포함한 컴퓨터 비전 OCR 모델을 훈련하고 업데이트하는 데 사용
- 중국에서的人 몸의 움직임 – 픽셀 단위로 추적된 사람의 움직임을 포함한 주석된 비디오, 게임 개발, 피트니스 앱 등에 적합
- 중국에서 아기 울음 소리 – 부모에게 다른 울음 소리를 인식하고 알리기 위해 AI 모델을 훈련하는 데 사용할 수 있는 주석된 아기 소리 포함
애플린 OTS 데이터셋 샘플에 대한 자세한 정보와 요청을 위해서는 こちら를 클릭하세요.


