Anderson의 관점
이미지 합성 시스템이 정말 독창적인 결과를 만드는지 판단하는 방법

 Unite.AI를 Google의 선호 소스에 추가

핵심 포인트KAIST와 NAVER의 희소성 점수(Rarity Score)는 최근접 이웃 거리를 통해 이미지의 독창성을 측정합니다.
더 보기
- KAIST와 NAVER의 희소성 점수(Rarity Score)는 최근접 이웃 거리를 통해 이미지의 독창성을 측정합니다.
- 기존의 절단 기법(Truncation Trick)과 같은 지표는 생성된 이미지에서 참신성보다는 진정성을 선호합니다.
- 희소성 점수는 DALL-E 2와 같은 시스템에서 진정으로 독창적인 결과물을 식별할 수 있습니다.
한국의 새 연구는 이미지 합성 시스템이 정말 새로운 이미지를 만드는지, 아니면 학습 데이터의 사소한 변형만 만드는지 판단하는 방법을 제안했다. 후자라면 새롭고 독창적인 이미지 생성이라는 구조의 목적이 무색해질 수 있다.
논문에 따르면 후자가 매우 흔하다. 학습 중 생성 능력을 개선하는 기존 지표들이 데이터셋의 실제 원본 이미지와 비교적 가까운 결과를 선호할 수밖에 없기 때문이다.
생성 이미지가 원본 데이터와 시각적으로 가깝다면 독창성보다는 사실성에서 높은 점수를 받을 가능성이 크다. 참신하지는 않아도 원본에 충실하기 때문이다.
법적 파장이 아직 알려지지 않은 초기 분야에서 이는 중요한 법적 문제가 될 수 있다. 상업화된 합성 이미지가 대개 저작권으로 보호되는 원본과 충분히 다르지 않을 경우다. 이런 원본은 현재 널리 유입이 허용되어 웹에서 수집한 인기 데이터셋 형태로 연구에 쓰인다. 이런 유형의 향후 침해 청구 가능성은 최근 주목받았다. Microsoft의 GitHub Co-Pilot AI와 관련해서다.
OpenAI의 DALL-E 2, Google의 Imagen, 중국의 CogView 및 성능이 더 낮은 DALL-E mini 같은 시스템의 결과가 점점 일관되고 의미적으로 탄탄해지고 있지만, 생성 이미지의 독창성을 신뢰성 있게 검증할 사후 방법은 거의 없다.
인기 있는 새 DALL-E 2 이미지를 검색하면 검색엔진에 따라 같은 이미지의 다른 사본만 더 나오는 경우가 많다.

DALL-E 2 이미지 아홉 장을 한꺼번에 올리면 격자가 가장 강한 특징이어서 다른 DALL-E 2 이미지 묶음만 나온다. 첫 이미지를 분리해 올리면, 이는 Weird Dall-E Generations 계정의 2022년 6월 8일 이 Twitter 게시물에서 가져온 것인데, Google은 농구공에 집착해 이미지 검색을 의미적 막다른 길로 이끈다. 같은 이미지에 대해 Yandex는 적어도 실제 픽셀 분석과 특징 비교를 하는 듯하다.
Yandex는 Google Search보다 실제 특징, 즉 이미지에서 도출되거나 계산되는 속성을 사용할 가능성이 높다. 이는 꼭 사람의 얼굴 특징을 뜻하지 않는다. 또한 의미적 특성보다 시각적 특성으로 비슷한 이미지를 찾는다. 그러나 모든 이미지 검색엔진에는 어떤 목적이나 관행이 있어 웹검색으로 원본>생성 이미지 표절을 찾아내기 어렵게 할 수 있다.
생성 모델의 학습 데이터가 전부 공개되지 않을 수도 있어 독창성에 관한 포렌식 조사도 더욱 어려워진다.
흥미롭게도 Google이 Imagen 전용 사이트에 올린 합성 이미지 하나로 이미지 검색을 하면, 실제 이미지를 살펴 공정하게 비슷한 그림을 찾는 관점에서는 해당 주제와 견줄 만한 것이 전혀 나오지 않는다. Google Images는 여전히 의미에 매달려 imagen google이라는 추가적이고 제한적인 검색어 없이는 순수한 이미지 기반 검색을 허용하지 않는다.

반대로 Yandex는 아마추어 예술 공동체에서 비슷하거나 적어도 시각적으로 관련된 실제 이미지들을 많이 찾는다.

모델 학습 시점에 인터넷에서 볼 수 있는 모든 이미지나 저작권 자료를 쓸 수 있는 비공개 데이터셋에서 특징을 뽑지 않고도 합성 결과의 새로움과 독창성을 측정할 수 있다면 더 좋을 것이다.
이 문제와 관련해 한국과학기술원 김재철AI대학원(KAIST AI) 연구진은 글로벌 ICT·검색 기업 NAVER Corp와 함께 희귀성 점수(Rarity Score)를 개발했다. 이는 이미지 합성 시스템의 더 독창적인 창작물을 찾는 데 도움이 될 수 있다.

StyleGAN-FFHQ로 만든 이미지다. 왼쪽에서 오른쪽으로 나쁜 결과부터 좋은 결과까지 배열되어 있다. Truncation trick과 Realism은 각자의 목표가 있지만, 맨 위 행의 새 희귀성 점수는 단지 일관된 이미지가 아니라 일관되면서 독창적인 이미지를 찾는다. 기사 이미지 크기에 제한이 있으므로 자세한 내용과 고해상도 결과는 원논문을 참조하라. 출처: https://arxiv.org/pdf/2206.08549.pdf
새 논문의 제목은 Rarity Score: A New Metric to Evaluate the Uncommonness of Synthesized Images(희귀성 점수: 합성 이미지의 드문 정도를 평가하는 새 지표)이며 KAIST 연구자 세 명과 NAVER Corp 연구자 세 명이 작성했다.
손쉬운 기법을 넘어서
새 논문이 개선하려는 이전 지표에는 영국 Heriot-Watt University와 Google DeepMind가 협력해 2019년에 제안한 Truncation trick이 있다.
이 기법은 표본 추출에 생성 모델 학습 때와 다른 잠재 분포를 사용한다.
개발자들은 기법이 작동한다는 데 놀랐지만 원논문에서 출력 다양성이 줄어든다고 인정했다. 그래도 실제처럼 보이는 결과를 얻는 효과적이고 인기 있는 손쉬운 기법이 되었다. 결과는 데이터의 모든 가능성을 흡수하지 못하고 원본과 원치 않게 너무 비슷할 수 있다.
새 논문 저자들은 다음과 같이 설명한다.
‘이는 학습 데이터셋에서 희귀한 표본을 생성하려는 것이 아니라 전형적인 이미지를 더 안정적으로 합성하려는 것이다. 생성기가 희귀 표본을 효과적으로 만들도록 유도하면 기존 생성 모델은 실제 데이터 분포 면에서 더 풍부한 표본을 만들 수 있을 것으로 가정한다.’
생성 모델 학습의 진행 지표로 기존 측정법을 쓰는 일반적 경향에 관해 저자들은 덧붙인다*. Frechet Inception Distance(FID)는 2021년 12월 강한 비판을 받았고, 그 밖에 Inception Score(IS), Kernel Inception Distance(KID) 등이 사용된다.
‘이 학습 방식은 고유하고 강한 특징을 지녔지만 실제 이미지 분포에서 비중이 작은 희귀 표본을 생성기가 많이 합성하지 않도록 만든다. 공개 데이터셋의 예에는 FFHQ의 여러 액세서리를 착용한 사람들, AFHQ의 흰 동물들, Metfaces의 드문 조각상들이 있다.
‘희귀 표본 생성 능력은 생성 모델의 한계 능력과 관련되기 때문에 중요할 뿐 아니라, 가상 인간 같은 창의적 활용에서 고유성이 중요하기 때문에도 필요하다.
‘그러나 최근 여러 연구의 정성적 결과에는 이런 예가 거의 없다. 우리는 적대적 학습의 성격이 생성 이미지 분포를 학습 데이터셋과 비슷하게 만든다고 추측한다. 따라서 뚜렷한 개성이나 희귀성이 있는 이미지는 합성 결과의 일부에 불과하다.’
기법
새 희귀성 점수는 앞선 연구들의 생각을 응용한다. K 최근접 이웃(KNN)을 사용해 이미지 합성 시스템의 실제 학습 데이터와 합성 결과 데이터 배열을 나타내는 것이다.
저자들은 이 분석 방법을 다음과 같이 설명한다.
‘보통 표본은 서로 가깝고, 고유하고 희귀한 표본은 특징 공간에 드문드문 위치할 것으로 가정한다.’
위 결과 그림은 FFHQ로 학습한 StyleGAN 구조에서 최근접 이웃 거리(NND)를 작은 것부터 큰 것까지 보여준다.
‘모든 데이터셋에서 NND가 가장 작은 표본은 대표적이고 전형적인 이미지다. 반대로 NND가 가장 큰 표본은 개성이 강하고 NND가 작은 전형적 이미지와 상당히 다르다.’
이론적으로 새 지표를 판별기로 쓰거나 더 복잡한 판별기 구조에 포함하면, 시스템을 순수한 모방에서 더 창의적인 알고리즘으로 유도할 수 있다. 동시에 사실적 이미지 생성에 중요한 개념의 일관성은 유지할 수 있다. 예를 들어 남성, 여성, 자동차, 교회 등이다.
비교와 실험
실험에서 연구진은 희귀성 점수를 Truncation trick 및 NVIDIA의 2019년 Realism Score와 비교했고, 여러 구조와 데이터셋에서 고유한 결과를 구분할 수 있음을 확인했다.
논문에 담긴 결과는 여기 모두 싣기에는 너무 많지만, 연구진은 실제 원본과 생성 이미지 모두에서 희귀성을 찾는 능력을 보여준 듯하다.
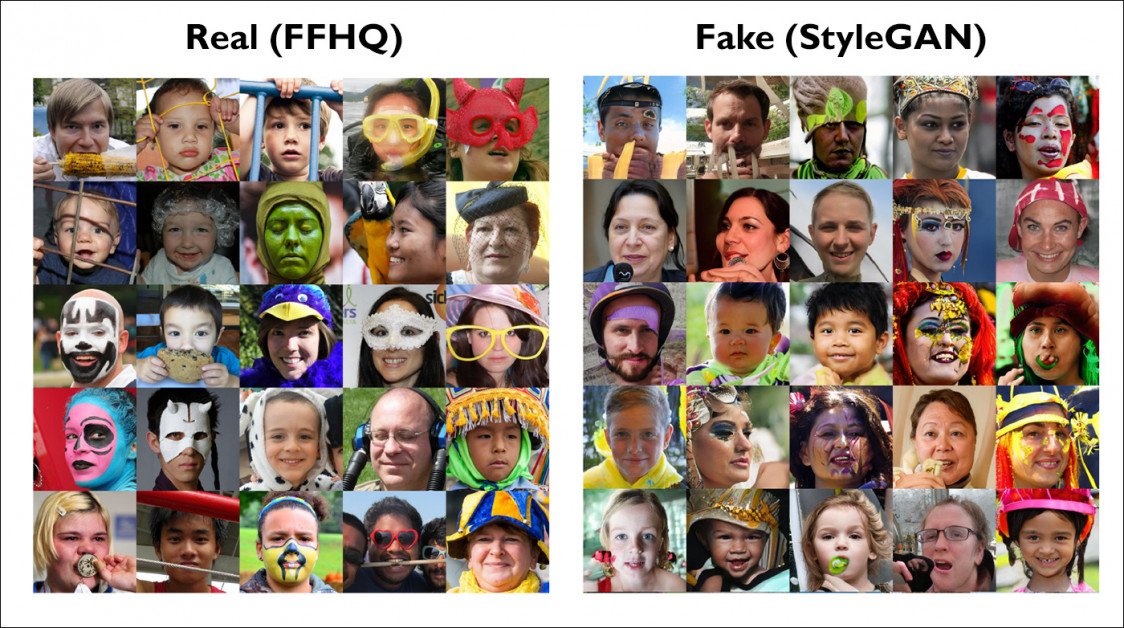
논문의 방대한 시각적 결과에서 고른 예들이다. 자세한 내용은 위 출처를 참조하라. 왼쪽은 원데이터셋에 가까운 이웃이 거의 없는 새롭고 드문 실제 FFHQ 표본이고, 오른쪽은 새 지표가 정말 새롭다고 판정한 StyleGAN 이미지다. 기사 이미지 크기에 제한이 있으므로 상세 내용과 고해상도 결과는 원논문을 참조하라.
연구진은 새 희귀성 점수가 단일 구조에서 새로운 출력을 찾을 뿐 아니라 오토인코더, VAE, GAN 등 서로 다른 구조의 생성 모델도 비교할 수 있다고 주장한다.
논문은 이 지표가 고유하고 희귀한 이미지를 만드는 능력에 집중한다는 점에서 기존 지표와 다르다고 설명한다. 전통적 지표들은 학습 중 생성 결과 사이의 다양성을 더 좁게 살핀다.
제한된 과제를 넘어서
실험은 사람이나 고양이 이미지에 특화된 생성기·데이터셋 조합처럼 제한된 영역에서 이루어졌다. 그러나 희귀성 점수는 학습 데이터에서 배운 분포를 쓰는 결과를 찾고자 하는 어떤 이미지 합성에도 적용될 수 있다. 이는 외부 잠재 분포를 끼워 넣어 사실성을 높이고 다양성을 줄이거나, 사실성을 위해 새로움을 희생하는 다른 편법의 대안이다.
이 지표는 겉보기에 이상치인 결과와 학습 데이터, 그리고 비슷한 프롬프트나 입력으로 얻은 결과 사이의 거리를 이용해 DALL-E 같은 시스템의 정말 새로운 출력을 구별할 수 있다. 이미지 기반 프롬프트도 포함된다.
실제로 시스템이 시각적·의미적 개념을 얼마나 흡수했는지 명확하지 않으며 학습 데이터에 대한 제한된 지식이 판단을 어렵게 한다. 그래도 이 방법은 충분한 입력 개념과 데이터가 과도한 모방이나 원본에 가까운 결과 대신 정말 창의적인 결과를 낳는 진정한 영감의 순간을 찾는 실용적 방법이 될 수 있다.
* 필자가 저자들의 본문 인용을 하이퍼링크로 바꾸었다.
2022년 6월 20일 최초 게시.