
Anderson의 관점
디즈니, CGI와 신경망 렌더링을 결합해 ‘언캐니 밸리’ 문제에 도전

 Unite.AI를 Google의 선호 소스에 추가
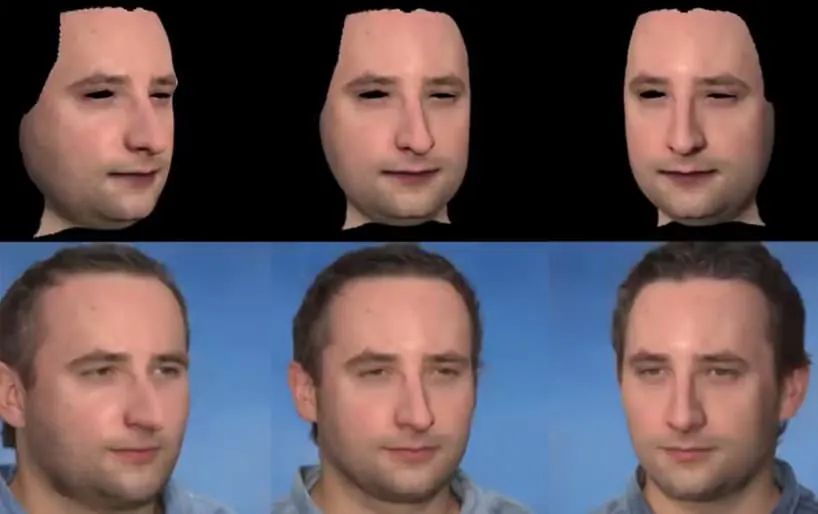
디즈니 AI 연구 부서는 영화 수준의 얼굴 시뮬레이션을 위한 하이브리드 방식을 개발했으며, 얼굴 신경망 렌더링의 장점과 CGI 기반 접근 방식의 일관성을 결합했습니다.
예정된 논문의 제목은 스타일을 활용한 렌더링: 전통적 접근법과 신경망 접근법을 결합한 고품질 얼굴 렌더링이며, 디즈니 리서치 YouTube 채널에 업로드된 새 10분 영상에서 미리 볼 수 있습니다 (이 글 말미에 삽입됨*).
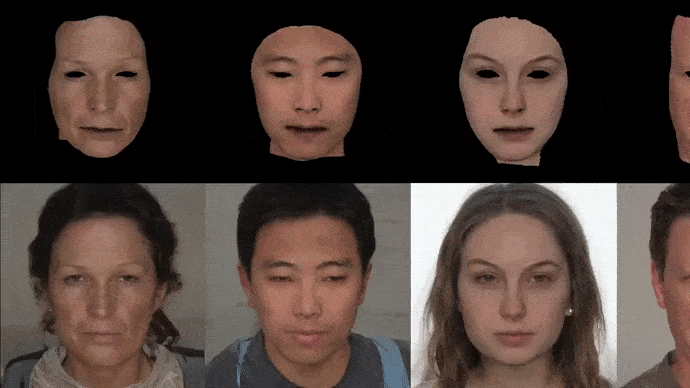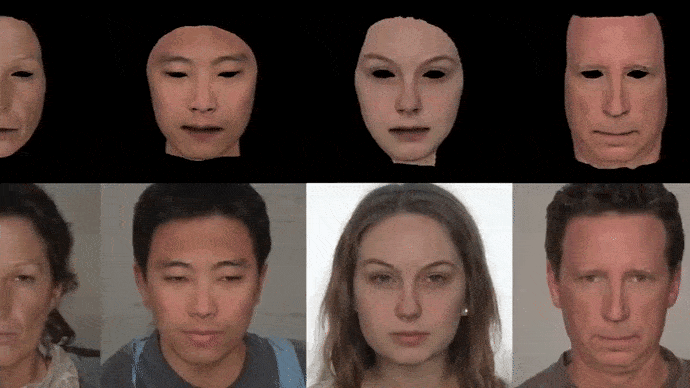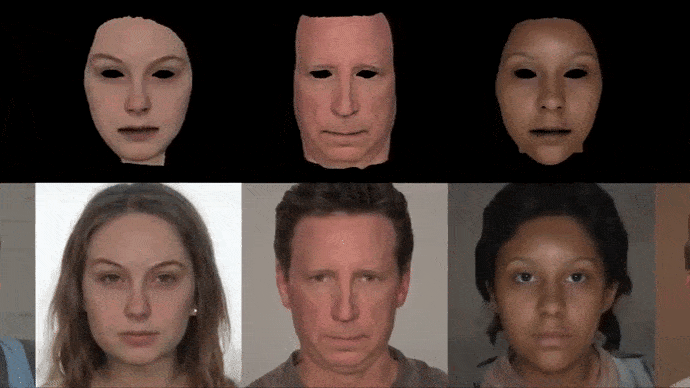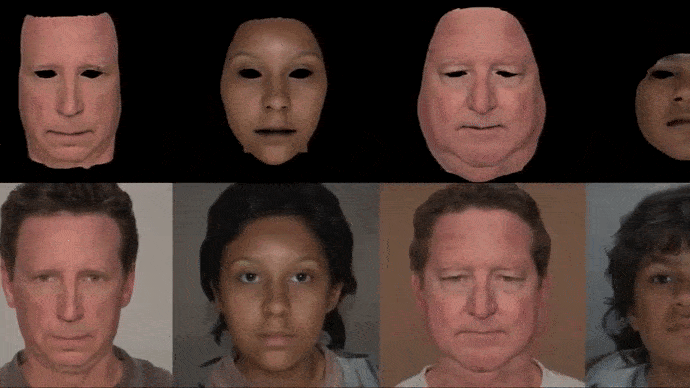
Meshes combined with neural facial renders. See video embed at end of article for better detail and quality. Source: https://www.youtube.com/watch?v=TwpLqTmvqVk
영상에서 언급했듯이, 얼굴의 신경망 렌더링(딥페이크 포함)은 CGI가 구현할 수 있는 수준보다 훨씬 더 사실적인 눈과 입 안쪽을 만들 수 있으며, 반면 CGI 기반 얼굴 텍스처는 일관성이 높아 영화 수준 VFX 출력에 더 적합합니다.
따라서 디즈니는 NVIDIA의 StyleGan2 신경망 생성기가 얼굴의 주변 특징과 눈과 같은 ‘생명에 중요한’ 요소를 담당하도록 실험하고 있으며, 일관된 CGI 얼굴 피부와 관련 요소를 결과물에 겹쳐 넣고 있습니다.

From the video (see end of article), the architectural concept behind Disney’s hybrid approach, where an old-school CGI mesh, of the type used to recreate ‘young’ Carrie Fisher and the late Peter Cushing for Rogue One (2016), is integrated into neurally-rendered face environments.
영상은 고(故) 영국 배우 피터 커싱이 Rogue One(2016)에서 CGI로 재현된 것에 대한 진위성 부족과 ‘언캐니 밸리’ 효과에 대한 빈번한 비판을 암시하며, 다음과 같이 인정합니다:
‘[사람들이 쉽게 캡처하고 렌더링할 수 있는 것]과 머리카락, 눈, 입 안쪽까지 완전한 포토리얼리스틱 디지털 복제본 사이에는 여전히 큰 차이가 있습니다. 이 격차를 메우려면 보통 숙련된 아티스트들의 많은 수작업이 필요합니다.’
실제로 가장 최신의 얼굴 캡처 시스템조차도 눈, 입 안쪽, 머리카락을 재현하려 하지 않으며, 이러한 기술에서는 눈은 진위성 문제가, 머리카락은 시간적 일관성 문제가 존재합니다.

The video illustrates what VFX artists will get after a typical modern facial capture session. Eyes, hair, facial hair, and mouth interiors will all have to be handled by separate teams in the production pipeline, in addition to texturing and lighting.
조명 제어
하이브리드 접근 방식은 재조명에서도 장점을 제공합니다. 얼굴 신경망 렌더링에서 눈에 띄는 과제인 재조명을 CGI 피부 겹침이 더 쉽게 수행할 수 있기 때문입니다.
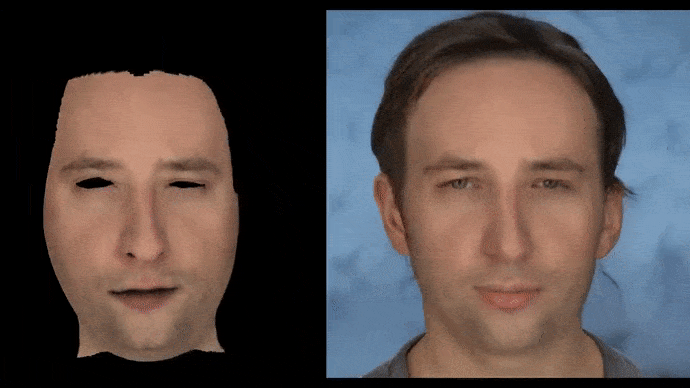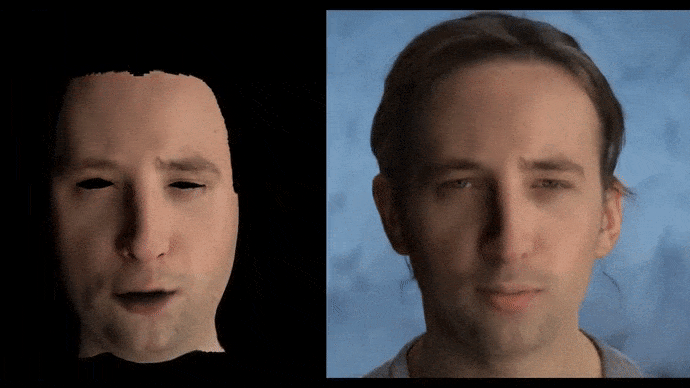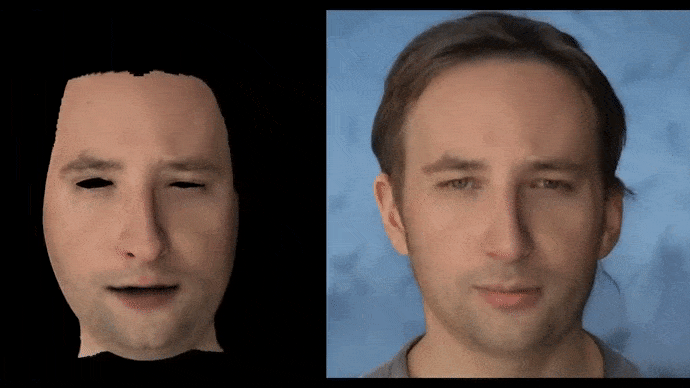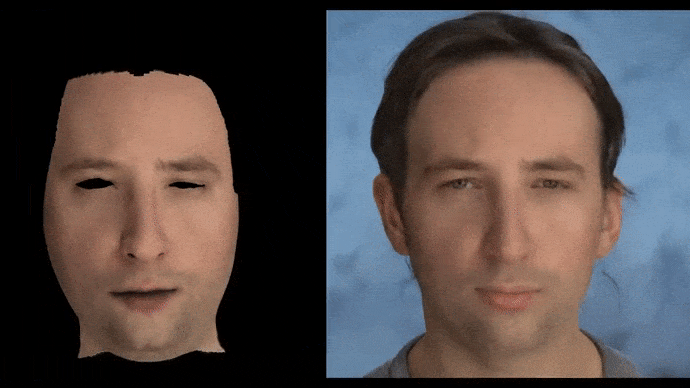
An animated version of the CGI/Neural approach.
외부 촬영과 같은 더 까다로운 환경에서는, 연구진이 ‘생성된’ 인물 주변에 일종의 비무장 지대(DMZ)를 둘러싸는 인페인팅 방법을 개발했습니다.

A black margin is generated to allow a ‘canvas’ for inpainting the outer parts of the identity and integrating the CGI skin into the combined CGI/neural output.
영상은 다음과 같이 언급합니다:
‘[신경망 렌더]는 배경 제약과 완벽히 일치하지 않습니다. – 이는 머리카락, 눈, 치아와 같은 현실적인 인간 요소를 최적화하는 것이 주요 목표이기 때문에 가이드 역할만 합니다. 환경 조명을 바꾸면서 일관된 정체성을 유지하려는 것이 더 큰 도전입니다.’
신경망 렌더에서 CGI 메시 생성
연구팀은 또한 (구체적으로 밝히지 않은) 대규모 3D 얼굴 이미지 데이터베이스로 학습된 변분 오토인코더를 개발했으며, 이를 통해 실제 데이터에서 ‘무작위이지만 그럴듯한’ 3D 얼굴 메쉬를 생성할 수 있다고 주장합니다.
이 연구가 극복해야 할 제한 사항이 존재하는데, 그 중 하나는 신경망 렌더링에서 머리카락의 시간적 일관성을 유지하기 어려운 점이며, 아래 영상에서는 CGI/신경망 얼굴을 둘러싼 일관된 팬에서도 머리카락이 급격히 변하는 여러 사례를 보여줍니다.
신경망 비디오 렌더링에서 시간적 일관성 문제는 디즈니에만 국한된 것이 아니라 훨씬 더 광범위한 문제이며, 향후 시스템의 반복에서는 머리카락을 ‘포스트 프로세스’로 추가하거나, 새로운 신경망 접근법에만 의존하기보다 다양한 머리카락 생성 방식을 시도할 가능성이 높습니다.
데이터셋 생성 활용
이 방법은 합성 데이터를 생성하고, 최근 몇 년간 위험할 정도로 단조로워진 얼굴 이미지 세트를 풍부하게 만드는 잠재적 방법으로도 제안되었습니다.

Disney envisages the new technique populating facial image datasets.
‘[우리]가 생성하는 모든 포토리얼리스틱 결과물은 기본적인 기하학과 외관 맵을 가지고 있으며, 알려진 조명 하에 알 수 없는 카메라 시점에서 렌더링됩니다. 이러한 ‘그라운드 트루스’ 정보는 단일 이미지, 3D 얼굴 복원, 얼굴 인식, 장면 이해와 같은 하위 응용 프로그램을 훈련하는 데 매우 중요할 수 있습니다. 따라서 각 결과 렌더는 데이터 샘플로 간주될 수 있으며, 우리는 다양한 인물들의 많은 변형을 생성할 수 있습니다.’
‘게다가, 단일 인물을 단일 표정, 단일 시점 및 조명으로 렌더링하더라도, 최적화 과정에서 무작위 시드를 변경함으로써 포토리얼 렌더의 무작위 변형을 생성할 수 있습니다.’
연구진은 이러한 다양한 설정 가능한 출력이 얼굴 인식 애플리케이션 훈련에 유용할 수 있다고 언급하며, 다음과 같이 결론짓습니다: ‘[우리]의 방법은 현재 얼굴 피부 캡처, 모델링 및 렌더링 기술을 활용하여 원하는 정체성, 표정 및 장면 구성을 일치시키는 완전한 포토리얼리스틱 얼굴 렌더를 자동으로 생성할 수 있습니다. 이 접근법은 영화 및 엔터테인먼트 분야의 얼굴 렌더링에 적용될 수 있어 수작업 아티스트의 노동을 절감하고, 딥러닝의 다양한 분야에서 데이터 생성에도 활용될 수 있습니다.’
새로운 접근법을 자세히 살펴보려면 오늘 공개된 10분 영상을 확인하세요:
* 이 글이 게시된 후 8시간 만에 원본 영상 링크가 겉보기에 동일한 다른 영상으로 교체되었습니다. 원본 영상의 흔적이 없어서 모든 관련 링크를 변경했습니다.
8:24 GMT+2 – 디즈니 리서치 YouTube 채널에서 어떤 이유로 영상을 교체했기 때문에 영상이 교체되었습니다.


