
AIの基礎
モデルルーティングとは何か?AIシステムが各リクエストに最適なモデルを選択する方法
モデルルーティングは、各リクエストに対して、能力、リスク、レイテンシ、可用性、コストに基づき、モデル、ツール、または構成の中から選択します。このガイドでは、実務で重要となるメカニズム、トレードオフ、評価方法、制御手段を解説します。

 Unite.AI を Google の優先ソースに追加
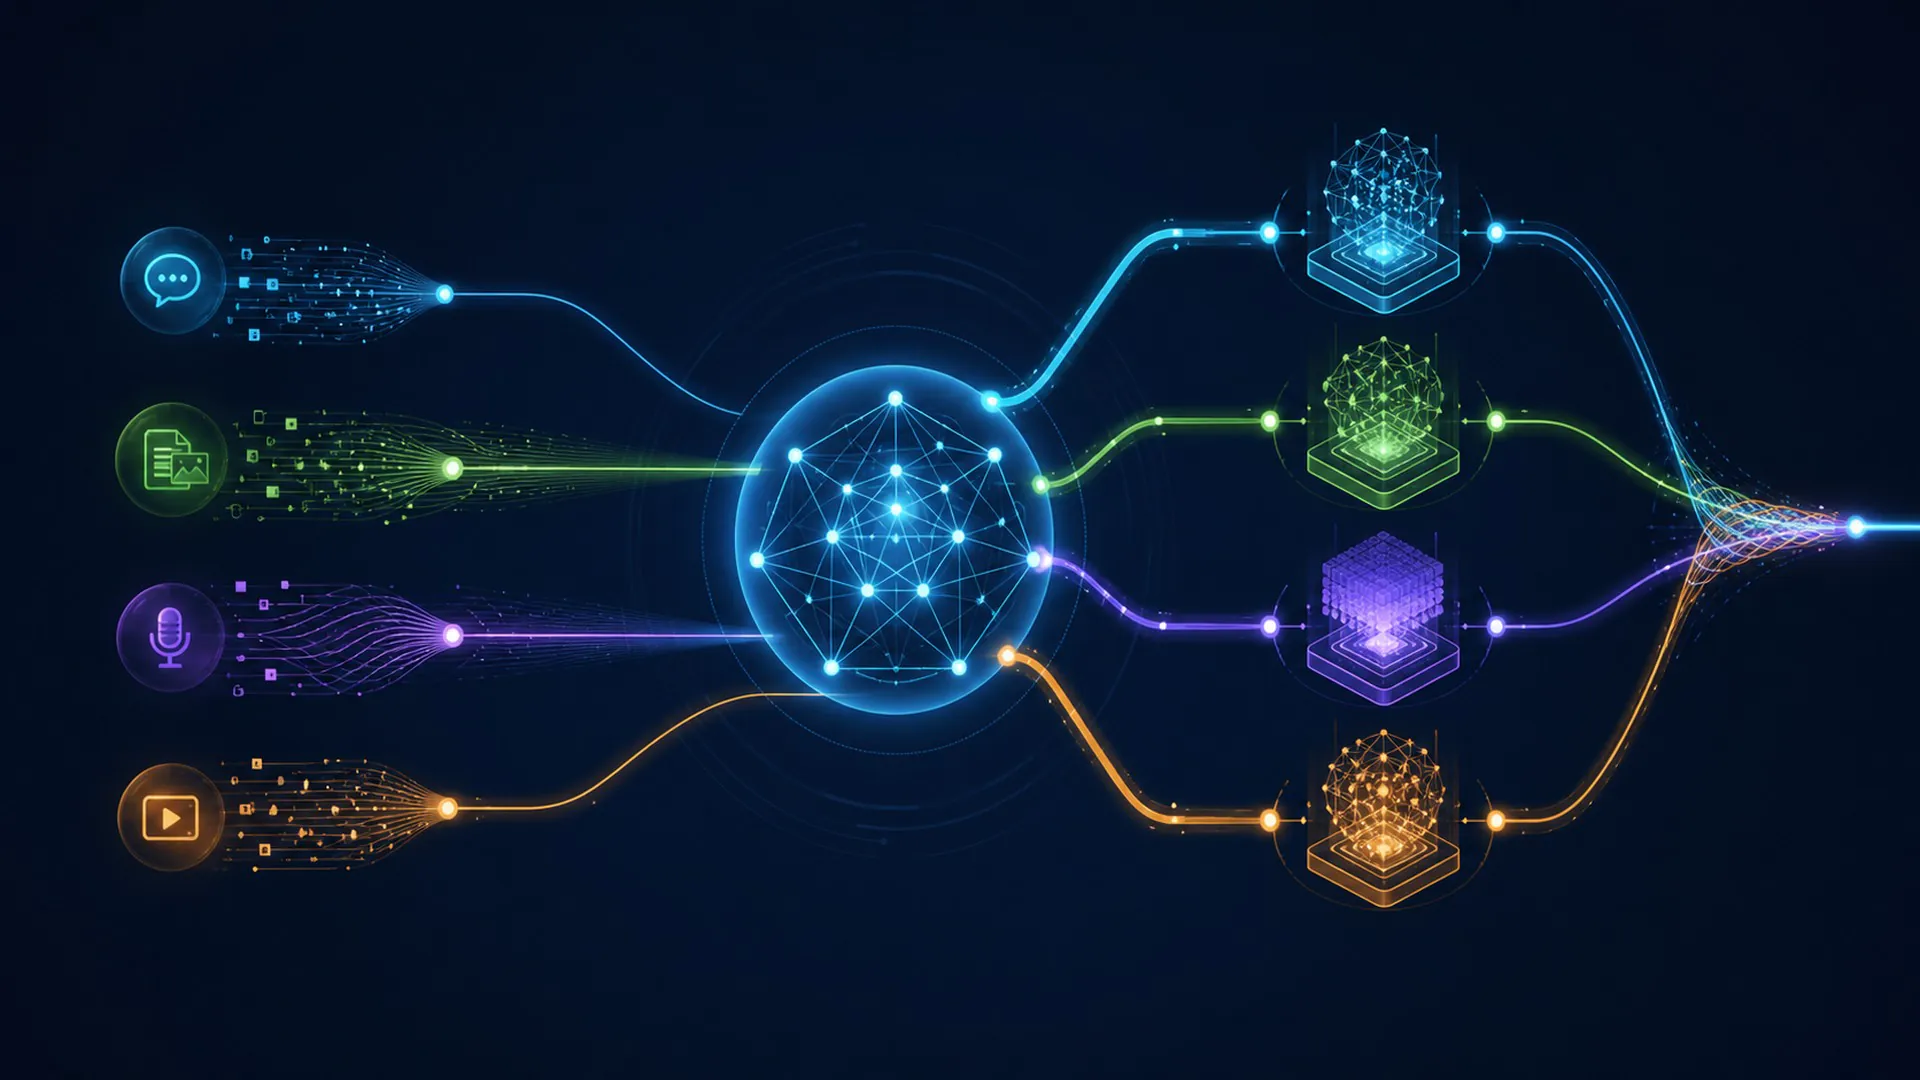
モデルルーティングは、各リクエストに対して、能力、リスク、レイテンシ、可用性、コストに基づき、モデル、ツール、または構成の中から選択します。
モデルルーティングは、その名称が特定の情報フロー、学習選択、実行時メカニズム、またはガバナンス境界を指し示すため、正確な説明が必要です。「高度な AI」の同義語として扱うと、主張の検証が不可能になります。本ガイドは、概念を入力と前提条件から観測可能な結果まで追跡し、最も混同されやすいショートカットを検証します。
Model Routing: Definition, Boundary, and Purpose
モデルルーティングは、各リクエストに対して、能力、リスク、レイテンシ、可用性、コストに基づき、モデル、ツール、または構成の中から選択します。定義には 3 つの実務的なコミットメントが含まれます:識別可能な入力、モデルルーティング特有の変換または決定、そして明示された目的に対して評価可能な結果です。これらの要素のいずれかが欠けている場合、ラベルは実装されたメカニズムというよりも願望を示すものとなります。
推論性能は、モデルアーキテクチャ、数値精度、メモリ移動、スケジューリング、ネットワーク、ハードウェア、ワークロード形状を跨ぐシステム属性です。モデルルーティングにおいては、基盤モデルが変わらなくても、周囲のデータ、インターフェース、ハードウェア、権限、関係者によって性能が左右されるため、このシステム視点が重要です。したがって、モデルが学習した振る舞いと、いつ・どこで・どの権限でその振る舞いを使用するかを決定するプロダクトを分離して説明する必要があります。
最も誤解を招くショートカットは、すべてのリクエストを最大規模のモデルに送ることです。これはモデルルーティングと表面的な特徴を共有しますが、因果関係を変えてしまいます:成功を示す証拠が異なり、コストを支配するリソースが変わり、リスク防止の制御が変わります。したがって境界は用語上ではなく、運用上のものです。
A Five-Stage Operating Map of Model Routing
この図はモデルルーティングのコンパクトな因果マップであり、すべての実装が必ずしも 5 つのソフトウェアコンポーネントを持つという主張ではありません。システムによってはステージを統合したり、ループで繰り返したりします。情報や権限の変化ごとに所有者、入力、出力、テストを設定する必要があることを示すため、マップは有用です。
1. リクエストと制約を分類する:モデルルーティングにおける入力と前提
この段階では、システムはリクエストと制約を分類しなければなりません。重要なのはその操作が実行されるかどうかだけでなく、どの情報を消費し、どの状態を変化させ、変化が正当であることを示す証拠は何かです。レビュー担当者は、すべてのリクエストを最大モデルに送る操作と区別し、同じ条件下で結果を再現できる必要があります。
このモデルルーティング段階へのハンドオフは、明示された目的から始まり、難易度推定や必要モダリティを支援できる結果で終わるべきです。不確実性、除外された代替案、リソース使用、境界で適用された人的またはソフトウェア制御を記録します。このトレースにより、弱いルータが難しいまたは高リスクタスクを誤分類して失敗を隠すかどうかを検出できます。
2. 難易度または必要なモダリティを推定する:モデルルーティングにおける表現または判断
この段階では、システムは難易度または必要モダリティを推定しなければなりません。重要なのはその操作が実行されるかどうかだけでなく、どの情報を消費し、どの状態を変化させ、変化が正当であることを示す証拠は何かです。レビュー担当者は、すべてのリクエストを最大モデルに送る操作と区別し、同じ条件下で結果を再現できる必要があります。
このモデルルーティング段階へのハンドオフは、リクエストと制約の分類から始まり、ポリシーとデータレジデンシー規則の適用を支援できる結果で終わるべきです。不確実性、除外された代替案、リソース使用、境界で適用された人的またはソフトウェア制御を記録します。このトレースにより、弱いルータが難しいまたは高リスクタスクを誤分類して失敗を隠すかどうかを検出できます。
3. ポリシーとデータ所在地の規則を適用する:モデルルーティングに固有の変換
この段階では、システムはポリシーとデータレジデンシー規則を適用しなければなりません。重要なのはその操作が実行されるかどうかだけでなく、どの情報を消費し、どの状態を変化させ、変化が正当であることを示す証拠は何かです。レビュー担当者は、すべてのリクエストを最大モデルに送る操作と区別し、同じ条件下で結果を再現できる必要があります。
このモデルルーティング段階へのハンドオフは、難易度または必要モダリティの推定から始まり、モデルとフォールバックパスの選択を支援できる結果で終わるべきです。不確実性、除外された代替案、リソース使用、境界で適用された人的またはソフトウェア制御を記録します。このトレースにより、弱いルータが難しいまたは高リスクタスクを誤分類して失敗を隠すかどうかを検出できます。
4. モデルとフォールバック経路を選ぶ:モデルルーティングにおける制約と検証の境界
この段階では、システムはモデルとフォールバックパスを選択しなければなりません。重要なのはその操作が実行されるかどうかだけでなく、どの情報を消費し、どの状態を変化させ、変化が正当であることを示す証拠は何かです。レビュー担当者は、すべてのリクエストを最大モデルに送る操作と区別し、同じ条件下で結果を再現できる必要があります。
このモデルルーティング段階へのハンドオフは、ポリシーとデータレジデンシー規則の適用から始まり、結果を測定してルータを改善できることを支援できる結果で終わるべきです。不確実性、除外された代替案、リソース使用、境界で適用された人的またはソフトウェア制御を記録します。このトレースにより、弱いルータが難しいまたは高リスクタスクを誤分類して失敗を隠すかどうかを検出できます。
5. 結果を測定してルーターを改善する:モデルルーティングにおける出力、フィードバック、停止規則
この段階では、システムは結果を測定してルータを改善しなければなりません。重要なのはその操作が実行されるかどうかだけでなく、どの情報を消費し、どの状態を変化させ、変化が正当であることを示す証拠は何かです。レビュー担当者は、すべてのリクエストを最大モデルに送る操作と区別し、同じ条件下で結果を再現できる必要があります。
このモデルルーティング段階へのハンドオフは、モデルとフォールバックパスの選択から始まり、モニタリングまたは最終決定を支援できる結果で終わるべきです。不確実性、除外された代替案、リソース使用、境界で適用された人的またはソフトウェア制御を記録します。このトレースにより、弱いルータが難しいまたは高リスクタスクを誤分類して失敗を隠すかどうかを検出できます。
モデルルーティングマップを前方に読んでプロダクションを理解し、逆方向にたどって失敗を診断します。前方分析はあるステージが次のステージに何を供給するかを問います。逆方向分析は、誤った、遅い、高コスト、または安全でない結果から始め、どの前提がそれを許したかを遡ります。多くの場合、決定的なエラーはモデルが何も生成する前に起きていることが判明します。
A Worked Model Routing Example
単純な抽出は小規模モデルに、曖昧な法的分析はより強力なモデルと人間のレビューにルーティングされます。
この例が有益なのは、モデルルーティングが観測可能な入力、途中状態、結果に結びつくため、洗練されたデモだけで評価できないからです。厳密なテストでは、通常ケース、難易度が高いケース、意図的に誤解を招くケースをシナリオ周辺に構築し、手法なしのベースラインを保持し、平均性能と個別失敗の深刻度の両方を記録します。
モデルルーティング例の前提を一つ変更し、分析を繰り返します。必須入力を除去したり、矛盾するシグナルを導入したり、計算リソースを制限したり、ユーザ層を変えたり、システムに中止させたりします。1 つの慎重に構成されたデモだけで成功するメカニズムは、運用環境に一般化することを証明していません。
Model Routing vs. Its Most Common Shortcut
モデルルーティングはしばしば「すべてのリクエストを最大モデルに送る」ことに簡略化されます。この簡略化は概念を定義する境界を取り除きます。その結果、バイヤーは異質な製品を比較し、研究者は実験が示すことを過大評価し、運用者はデプロイ後に誤ったシグナルを監視することになります。
| Lens | Practical answer |
|---|---|
| Definition | モデルルーティングは、能力、リスク、遅延、可用性、コストに基づいて、リクエストごとにモデル、ツール、構成を選択します。 |
| Confusion | sending every request to the largest model. |
| Risk | 性能の低いルーターは、難しいタスクや高リスクのタスクを誤分類することで失敗を隠す可能性があります。 |
比較では分析単位も明示すべきです。モデルルーティングに関する論文はモデルやアルゴリズム単体を対象にすることがありますが、実装されたサービスは検索、ルーティング、キャッシュ、ポリシー、アイデンティティ、ユーザインタフェース、モニタリングを加えます。同じ見出し語を使っても、スタックの異なる部分を実装する製品は複数存在します。どのコンポーネントが定義的変換を行い、どのコンポーネントが報告された結果に必要かを確認してください。
Why Model Routing Matters in Current AI Systems
モデルルーティングが重要になるのは、AI システムがより大きなコンテキスト、複数モダリティ、より多くの実行時計算、広範なツールアクセス、組織的意思決定との深い結びつきを持つようになったからです。こうした条件下では、かつては研究上の詳細に過ぎなかったものが、レイテンシ、セキュリティ、アクセシビリティ、環境コスト、製品品質、法的責任を左右します。
評価すべき指標は、モデルルーティングが単一の印象的な結果を出すかどうかではなく、代表的な条件下で重要な成果を改善し、シンプルなベースラインよりも効果的に実現できるかです。平均値だけでなく、分布、失敗カテゴリ、テールレイテンシ、リソース使用、影響を受けるサブグループを報告してください。
実際のリクエスト分布を現実的な同時実行性でベンチマークします。ファーストレスポンス時間、定常速度、テールレイテンシ、スループット、品質、利用率、失敗、ユースフルな結果あたりのコストを報告してください。モデルルーティングに特化して適用すれば、証拠がポータブルになります。別のモデル、言語、ハードウェア、データセット、ユーザ層、リスク許容度でも主張された利得が維持できるか、他チームが判断できるようになります。
Benefits Model Routing Can Deliver
モデルルーティングを採用する最大の理由は、意図したボトルネックに直接対処できる点です。実装により、より良い根拠付け、忠実な表現、汎化性能向上、レイテンシ低減、メモリ移動削減、説明責任の明確化、モデル提案と実際の行動間の安全な境界確保などの形で効果が現れます。
ベネフィットは意思決定と測定可能な形で示すべきです。「より賢い」だけではモデルルーティングの受容基準になりません。有用な目標例としては、難易度の高いケースでのエラー率、矛盾する証拠への回復率、トラフィックの特定パーセンタイルでのコスト、人間レビュー時間、キャリブレーション、権限上限内に留まるアクションの割合などが挙げられます。
The Failure Mode That Defines Model Routing
中心的な制限は、弱いルータが難しいまたは高リスクタスクを誤分類して失敗を隠すことです。この失敗は開発完了後に一度だけリストすればよいという付随事項ではなく、データ収集、アーキテクチャ、権限、評価、リリースゲート、モニタリングを最初から形作るべきです。
モデルルーティングに対する制御は、費用がかかるまたは不可逆的な結果が生じる前に機能する場合にのみ有用です。失敗の最も早い観測可能な前兆を特定し、閾値またはルールを設定し、責任者を割り当て、回復をテストします。ユースケースに応じて、回復は中止、簡易システムへのフォールバック、追加証拠要求、担当者へのエスカレーション、モデルのロールバック、あるいはアクション全体の停止を意味します。
An Evaluation Plan for Model Routing
モデルルーティングの評価は、証拠が支えるべき決定を書き出すことから始めます。対象となる運用母集団、誤結果の影響、意思決定時に実際に利用可能な情報、最もシンプルで信頼できる代替案を定義してください。これにより、ベンチマークが単に実行しやすいからという理由で目標になることを防げます。
コントロールされた比較のために未加工のテストセットを使用し、段階的な運用環境でモデルルーティングを検証します。オフライン評価でバリアントを比較可能にし、シャドウモード、カナリアリリース、レートリミット、承認ゲートで実トラフィック、フィードバックループ、人的介入が行動に与える影響を明らかにします。デプロイ段階では、すべての改善が全面ロールアウトに値するという前提ではなく、明示的な停止条件を設けます。
モデルルーティングを再現するために必要な入力をバージョン管理してください:ソースデータ、前処理、トークナイザまたはエンコーダ、モデル重み、設定、プロンプトまたはポリシー、検索インデックス、評価セット、ハードウェア前提、サービングコードなど。系統的な系譜がなければ、結果の変化が手法、環境、または見落としのパイプライン変更によるものか判断できません。
最後に、モデルルーティングが有効であるという主張を反証できる発見は何かを問います。結果が採用決定を覆すことができなければ、評価はマーケティングに過ぎません。事前に受容閾値を設定し、確認用データセットを保存すれば、演習は証拠に変わります。
Questions to Ask Before Adopting Model Routing
- Objective: Which measurable bottleneck is Model routing intended to solve?
- Mechanism: Which of the five stages contains the distinctive transformation?
- Baseline: すべてのリクエストを最大のモデルに送る方法や、ほかの単純な代替策と比べてどうでしょうか。
- Evidence: Which ordinary, difficult, adversarial, and subgroup cases were tested?
- Operations: 規模が拡大すると、遅延、メモリ、計算、エネルギー、保守、レビューのコストはどのように現れますか。
- Risk: 性能の低いルーターが難しいタスクや高リスクのタスクを誤分類して失敗を隠していることを、チームはどう検知しますか。
- Recovery: システムは被害が起きる前に、応答を控えたり、フォールバックしたり、ロールバックしたり、上位にエスカレーションしたりできますか。
Primary Sources for Studying Model Routing
モデルルーティングを取り巻く AI スタックの主要な出発点としては、FlashAttention 論文、vLLM と PagedAttention、予測デコーディング研究があります。対象となるモデル、データセット、ハードウェア、法域のドキュメントと併せて読んでください。一般的な情報はメカニズムを定義できますが、導入に適した実装かどうかはデプロイ固有の証拠が必要です。
What to Remember About Model Routing
モデルルーティングは、より大きな社会技術システム内の定義されたメカニズムです。その価値は、明示された条件下で特定の成果を改善することにあり、ラベル自体ではありません。5 段階マップは情報フローを可視化し、比較は何でないかを示し、制御パスは責任あるオペレーターが介入できる箇所を示します。
実務上のルールは、目的を定義し、信頼できるベースラインと比較し、最も重要な失敗をテストし、変化を監視するための証拠を保持することです。これらが整っていれば、概念はエンジニアリングとガバナンスの選択肢として評価可能になります。整っていなければ、未知の運用リスクに結びついた有望な名称に過ぎません。



