
AIの基礎
データファブリックとは何か?

 Unite.AI を Google の優先ソースに追加
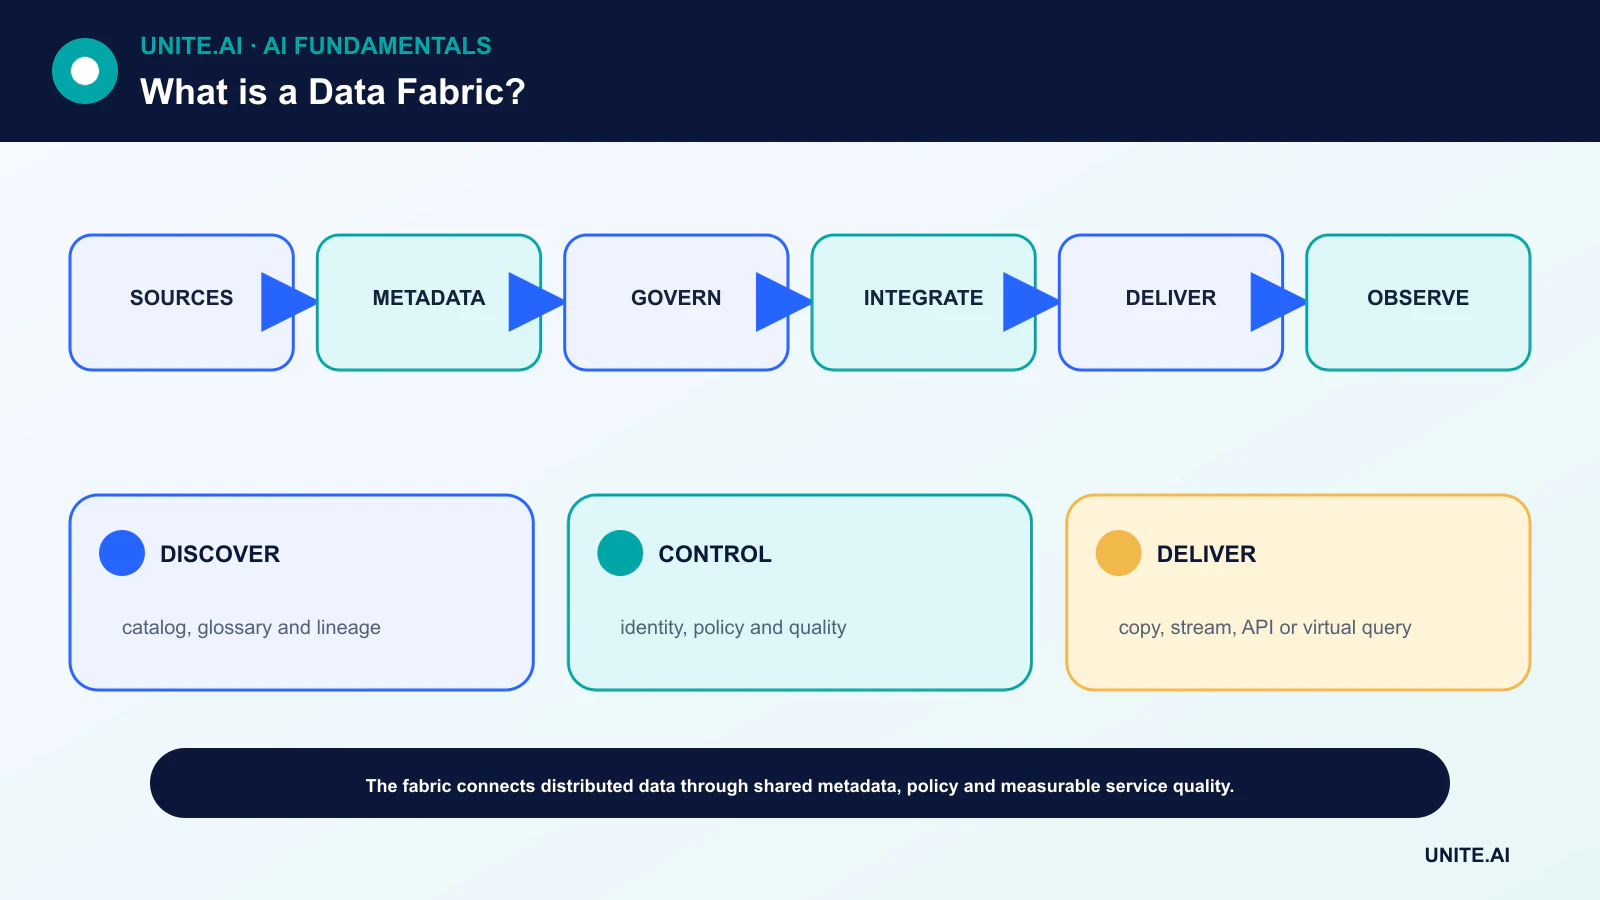
データファブリックは、分散システム全体でデータを発見・接続・ガバナンス・配信するためのアーキテクチャパターンです。共有メタデータと制御レイヤーを提供することで、ユーザーやアプリケーションはすべてのデータセットを単一の物理ストアに強制的に入れることなく、信頼できるデータを見つけることができます。
データファブリックは単一の製品ではなく、ソースシステム間の違いを消すものでもありません。その価値は正確なメタデータ、明確な所有権、実行可能なポリシー、信頼できる統合、そして利用者が目的に適したデータを受け取っていることの証拠に依存します。
主なポイント
- メタデータが豊富な制御プレーンは、カタログ、系統、品質、ポリシー、アクセスを接続します。
- データは分散したままで、ワークロードに応じてコピー、ストリーミング、変換、または仮想化されることがあります。
- データファブリックは技術志向であり、データメッシュはドメイン所有権とデータを製品として扱うことを強調します。
- 自動化はガバナンスのスケールに役立ちますが、責任ある所有者は依然として意味、品質、許容される使用を定義します。
制御プレーンとデータプレーン
データプレーンは、データベース、ファイル、ストリーム、API、およびそれらを移動またはクエリするパイプラインを含みます。制御プレーンは、技術的およびビジネス的なメタデータ(スキーマ、所有者、分類、品質指標、系統、ポリシー、使用状況)を記録します。
カタログやナレッジグラフはこれらの情報を結びつけ、利用者がデータセットを発見し、そのコンテキストを理解できるようにします。ファブリックはメタデータを活用して、異種プラットフォーム間でのアクセス、変換、可観測性、ポリシー適用を導きます。
必須の単一ストアなしでの統合
一部のワークロードはETLでデータをコピーし、他は変更データキャプチャ、イベントストリーム、API、またはクエリ仮想化を使用します。適切なパターンは、新鮮さ、パフォーマンス、一貫性、主権、コスト、ソースシステムの制約に依存します。
仮想アクセスは重複を削減できますが、利用者がソースの遅延や可用性に影響を受ける可能性があります。物理的なマテリアライズはパフォーマンスと再現性を向上させますが、同期やライフサイクルの責任が生じます。
ガバナンス、セマンティクス、品質
ビジネス用語集は、顧客、注文、アクティブアカウントなどの用語に共有された意味付けを提供します。系統はフィールドの出所と変遷を示します。分類とポリシーは、誰が機密レコードにアクセスできるか、どのような目的でアクセスできるかを決定します。
品質ルールは特定のユースケースに結び付けるべきです。ダッシュボードに十分な完全性でも、自動化された意思決定には安全でない場合があります。ファブリックは、資産を単に「認定済み」とラベル付けするのではなく、新鮮さ、検証履歴、既知の制限を可視化すべきです。
データファブリック、メッシュ、レイクハウス
データメッシュは、ドメインチームに相互運用可能なデータ製品の責任を割り当てる社会技術的アプローチです。データファブリックは、共有技術サービスとメタデータ自動化を強調します。組織はそれらを組み合わせることができ、ドメイン所有権は共通のファブリックを通じて機能します。
レイクハウスは、データレイクの柔軟性とデータウェアハウスのような管理・クエリ機能を組み合わせたものです。これは参加プラットフォームの一つである可能性がありますが、システム横断的なファブリック全体を指すわけではありません。同様に、ウェアハウスやカタログだけではすべての統合やポリシー機能を提供できません。
実装と評価
まず、価値のあるシステム横断ユースケースから始め、最低限必要なソース、所有者、ポリシー、サービスレベルの期待を一覧化します。自動化された推奨を追加する前に、アイデンティティ、メタデータ標準、契約、テスト、可観測性を確立します。
発見までの時間、アクセス承認までの時間、インシデント率、データの新鮮さ、再利用、利用者の信頼を測定します。ファブリックを構造化データと非構造化データのガバナンス、そしてサイバーセキュリティに結び付けます。制御のない接続はリスクを高める可能性があります。
データファブリックアーキテクチャとメタデータプレーン
データファブリックは、共有メタデータ、ガバナンス、統合、アクセスサービスを通じて分散データを接続するアーキテクチャ手法です。単一のデータベースや製品ではありません。ソースはウェアハウス、レイク、業務システム、ストリーム、SaaSプラットフォームに残り続けることがあり、カタログはデータセットを記述し、系統は変換の痕跡を追跡し、ポリシーはアクセスを制御し、セマンティック定義は概念の再利用を可能にします。仮想化、レプリケーション、API、パイプラインは、レイテンシ、規模、ソースの能力、整合性要件に応じて選択される補完的な配信手段です。
アクティブメタデータはスキーマ、所有権、使用状況、品質、分類、系統、クエリパターン、運用イベントを取得し、自動化を促進できます。ナレッジグラフはビジネス概念と物理フィールドやポリシーを結び付けます。自動化は結合の推奨、ドリフト検出、分類の伝搬、インシデントのルーティングを行うことがありますが、推測されたメタデータには信頼性と管理が必要です。配信や制御と結び付いていないカタログは文書負債となります。セマンティック所有権なしの自動統合は不整合を加速させます。
統合、ガバナンス、データ製品
バッチETL、変更データキャプチャ、ストリーム、フェデレーション、リバースETLは、それぞれ新鮮度と障害の意味合いが異なります。権威あるソース、識別子、契約、イベント時刻、遅延データ、削除、調整を定義します。仮想クエリはコピーを回避しますが、ソースのパフォーマンスと可用性に依存します。マテリアライズは速度を向上させますが、新鮮度と保持義務が生じます。機密ポリシーは派生データ、キャッシュ、埋め込み、エクスポートに対して適用または再評価されなければなりません。
高価値データセットは所有者、利用者、ドキュメント、サービス期待、テスト、サポートを備えた製品として扱います。フェデレーテッド所有権により、ドメインは意味を管理し、共有標準が相互運用性を保ちます。中央チームはプラットフォーム機能とガバナンスを提供しますが、すべてのフィールドの所有権は持ちません。発見時間、再利用、データ品質、アクセスリードタイム、インシデント解決、信頼できる指標の採用、コストを測定します。カタログエントリやコネクタの数は、信頼できるデータを見つけて利用できることの証拠ではありません。
実装戦略
遅延やリスクが把握できている単一のクロスドメインジャーニーから開始します。ソースと契約を一覧化し、アイデンティティと分類を確立し、系統と品質を結び付け、繰り返しの制御を自動化します。価値を提供する前に全社をモデル化しようとする数年規模の試みは避けます。ソースの停止、スキーマ変更、アクセス取り消し、遅延イベント、災害復旧をテストします。データファブリックは、分散データのガバナンスと利用が容易になり、起源システムの運用実態や責任を消さないときに成功します。
実例:顧客データファブリック
ある企業は、商取引、サポート、マーケティング、製品データを接続しつつ、業務システムを権威あるものとして残します。共有カタログは顧客、アカウント、注文、同意、インタラクションの定義を物理フィールドに結び付けます。変更データキャプチャはガバナンスされた製品に供給し、仮想化は低ボリュームのリアルタイム検索に、マテリアライズテーブルは分析を支援します。アイデンティティ、系統、品質、ポリシーは、AIパーソナライズ層がデータを使用できるようになる前に実装されます。
同意の撤回はウェアハウステーブル、検索インデックス、埋め込み、アクティベーションシステムを通じて伝播し、完了の証拠が残ります。スキーマ契約と調整テストはソースの変更を検出します。所有者は新鮮さと品質の期待値を公表し、使用メタデータは未使用コピーの廃止に役立ちます。パイロットはアクセスリードタイム、信頼指標の再利用、インシデント解決、プライバシーコンプライアンスを測定します。ファブリックは、ベンダーが最も多くのソースを接続したからではなく、単一のクロスドメインジャーニーが信頼でき、ガバナンス可能になったことで成功と見なされます。
実装の証拠と運用準備
本番導入の判断は、成功したデモだけでは不十分です。想定ユーザー、運用環境、入力、出力、依存関係、所有者、重要な障害ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、形式不正や欠損入力、分布シフト、依存障害、誤用、そしてサービスが行き届きにくいグループや環境をテストします。タスク品質をキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビュアーが結果を再現し、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に注入した障害でモニタリングを検証します。運用テレメトリは、不要な機密データを収集せずに、入力品質、出力挙動、モデルまたはルールのバージョン、依存性の健全性、人間の介入、確認済み結果を明らかにすべきです。アラート閾値と対応責任者を定義し、デプロイ後に実世界の証拠をレビューし、オフラインでの性能が持続すると仮定しないでください。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目標が変わるたびに再評価します。維持されたシステムは、文書化された復旧、インシデント学習、削除・保持手順、そして無効化または置換すべき明確な時点も必要です。
よくある質問
データファブリックはすべてのデータを一箇所に移動しますか?
いいえ。データが分散したままでも調整でき、ワークロードに応じて物理的な移動または仮想化を選択できます。
データファブリックはデータメッシュと同じですか?
いいえ。ファブリックは主に有効化アーキテクチャと自動化を指し、メッシュは主に分散型ドメイン所有権とデータ製品の責任を指します。両者は共存可能です。
主な参考文献











