

AIモデルとプラットフォーム
AniPortrait: オーディオ駆動の写実的なポートレートアニメーション合成

 Unite.AI を Google の優先ソースに追加
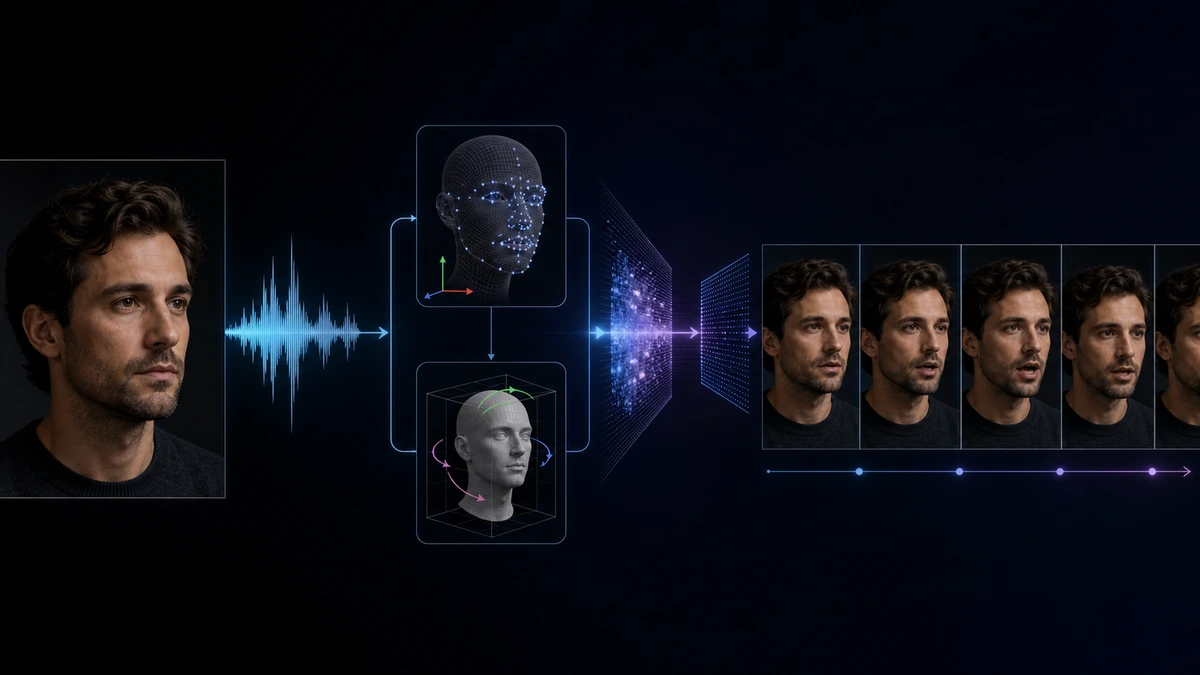
これまで、静的な画像とオーディオからリアルなポートレートアニメーションを作成することは、ゲーム、デジタルメディア、バーチャルリアリティなど、さまざまな分野で応用されてきました。しかし、開発者が、高品質のアニメーションを生成するフレームワークを作成することは、依然として難しい課題です。その主な理由は、口の動き、頭の位置、顔の表情を調整して、視覚的に魅力的な効果を生み出す必要があるためです。
この記事では、AniPortraitという、参考画像とオーディオサンプルから高品質のアニメーションを生成するための新しいフレームワークについて説明します。AniPortraitの動作は、2つのステージに分かれています。まず、AniPortraitはオーディオサンプルから中間の3D表現を抽出し、それを2Dの顔のランドマークのシーケンスに投影します。次に、AniPortraitは拡散モデルとモーションモジュールを使用して、ランドマークのシーケンスを時間的に一貫性のある写実的なアニメーションに変換します。実験結果は、AniPortraitが、高品質のアニメーションを生成する能力と、優れた視覚的な質、ポーズの多様性、顔の自然さを示しています。さらに、AniPortraitは、顔の再演、顔のモーション編集など、さまざまな分野で有効に適用できる、制御性と柔軟性の高い潜在能力を持っています。この記事では、AniPortraitのメカニズム、方法論、フレームワークのアーキテクチャについて詳細に説明し、最先端のフレームワークと比較します。
AniPortrait: 写実的なポートレートアニメーション
リアルなポートレートアニメーションを作成することは、研究者にとって重要な課題です。デジタルメディア、バーチャルリアリティ、ゲームなど、さまざまな分野で応用されるためです。しかし、時間的に一貫性のある、高品質のアニメーションを生成することは、依然として難しい課題です。開発者が直面する主な課題は、頭の位置、視覚的な表情、口の動きを調整して、視覚的に魅力的な効果を生み出す必要があるためです。既存の方法は、これらの課題に対処することができません。主な理由は、多くの場合、NeRF、モーションベースのデコーダー、GANなどの限られた能力を持つジェネレーターに依存しているためです。これらのネットワークは、限られた汎化能力を持っており、高品質のコンテンツを生成することが不安定です。しかし、最近の拡散モデルの出現により、高品質の画像を生成することが可能になりました。さらに、拡散モデルと時間モジュールを組み合わせたフレームワークにより、魅力的なビデオを生成することが可能になりました。
拡散モデルの進歩を基盤に、AniPortraitは、参考画像とオーディオサンプルから高品質のアニメーションを生成することを目的としています。AniPortraitの動作は、2つのステージに分かれています。最初のステージでは、AniPortraitは、トランスフォーマーベースのモデルを使用して、オーディオ入力から3Dの顔のメッシュと頭のポーズを抽出し、それを2Dの顔のランドマークのシーケンスに投影します。最初のステージにより、AniPortraitは、オーディオから口の動きと繊細な表情を抽出し、頭の動きをオーディオのリズムに同期させることができます。2番目のステージでは、AniPortraitは、拡散モデルとモーションモジュールを使用して、ランドマークのシーケンスを写実的なアニメーションに変換します。具体的には、AniPortraitは、AnimateAnyoneモデルのネットワークアーキテクチャを使用して、参考画像と身体のモーションシーケンスからリアルなアニメーションを生成します。AniPortraitは、ポーズガイダーモジュールを再設計して、軽量な設計と高い精度を実現しています。
実験結果は、AniPortraitが、高品質のアニメーションを生成する能力と、優れた視覚的な質、ポーズの多様性、顔の自然さを示しています。3Dの顔の表現を中間的な特徴として使用することで、AniPortraitは、これらの表現を必要に応じて変更することができます。この柔軟性により、AniPortraitは、顔の再演、顔のモーション編集など、さまざまな分野で有効に適用できるようになります。
AniPortrait: 動作と方法論
提案されたAniPortraitフレームワークは、2つのモジュール、Lmk2VideoとAudio2Lmkで構成されています。Audio2Lmkモジュールは、オーディオ入力から口の動きと顔の表情を抽出し、Lmk2Videoモジュールは、ランドマークのシーケンスから時間的に一貫性のあるポートレートビデオを生成します。以下の図は、AniPortraitの動作の概要を示しています。AniPortraitは、最初にオーディオから3Dの顔のメッシュと頭のポーズを抽出し、それを2Dの顔のランドマークに投影します。2番目のステージでは、AniPortraitは、拡散モデルを使用して、ランドマークのシーケンスをポートレートビデオに変換します。

Audio2Lmk
AniPortraitの主な目的は、与えられたオーディオ入力から3Dの顔のメッシュと頭のポーズを予測することです。AniPortraitは、wav2vecメソッドを使用してオーディオ特徴を抽出し、モデルの汎化能力が高く、オーディオからイントネーションと発音を正確に認識することができます。得られたロバストなオーディオ特徴を使用して、AniPortraitは、2つのfc層で構成されるシンプルなアーキテクチャを使用して、オーディオ特徴を3Dの顔のメッシュに変換します。AniPortraitは、この設計が、推論プロセスの効率を高めると同時に、精度も確保することを発見しました。オーディオからポーズを変換するとき、AniPortraitは、wav2vecネットワークを使用しますが、オーディオからメッシュのモジュールと重みを共有しません。主な理由は、ポーズは、オーディオのトーンとリズムに密接に関係しているため、オーディオからメッシュのタスクとは異なる強調点を持っているためです。前の状態の影響を考慮するために、AniPortraitは、トランスフォーマーデコーダーを使用してポーズのシーケンスをデコードします。このプロセスで、AniPortraitは、クロスアテンションメカニズムを使用してオーディオ特徴をデコーダーに統合します。両方のモジュールは、L1損失を使用してトレーニングされます。ポーズとメッシュのシーケンスが得られたら、AniPortraitは、視点投影を使用してこれらのシーケンスを2Dの顔のランドマークのシーケンスに変換します。
Lmk2Video
与えられた参考画像とランドマークのシーケンスの場合、Lmk2Videoモジュールは、時間的に一貫性のあるポートレートアニメーションを生成します。このアニメーションは、ランドマークのシーケンスのモーションと一致し、参考画像の外観と一致しています。最終的に、AniPortraitは、ポートレートアニメーションを、ポートレートフレームのシーケンスとして表現します。Lmk2Videoのネットワーク構造は、既存のAnimateAnyoneフレームワークからインスピレーションを得ています。AniPortraitは、Stable Diffusion 1.5という強力な拡散モデルを使用して、時間モーションモジュールを統合します。このモジュールは、複数のフレームのノイズ入力をビデオフレームのシーケンスに変換します。同時に、ReferenceNetネットワークコンポーネントは、Stable Diffusion 1.5の構造をミラーして、参考画像から外観情報を抽出し、バックボーンに統合します。この戦略的な設計により、顔のIDが一貫して維持されます。AnimateAnyoneフレームワークとは異なり、AniPortraitは、ポーズガイダーの設計の複雑さを高めます。オリジナルのAnimateAnyoneフレームワークには、コンボリューションレイヤーが数層あり、ランドマークの特徴がバックボーンの入力層に統合されます。AniPortraitは、この設計が、口の繊細な動きを捉えることが不足していることを発見しました。この問題を解決するために、AniPortraitは、ConvNetアーキテクチャのマルチスケール戦略を採用し、対応するスケールのランドマークの特徴をバックボーンのさまざまなブロックに統合します。さらに、AniPortraitは、参考画像のランドマークを追加の入力として導入します。ポーズガイダーのクロスアテンションモジュールは、各フレームのターゲットランドマークと参考ランドマークの間の相互作用を促進します。このプロセスにより、ネットワークは、外観と顔のランドマークの相関関係をよりよく理解し、より正確なモーションを持つポートレートアニメーションを生成することができます。
AniPortrait: 実装と結果
Audio2Lmkステージの場合、AniPortraitは、wav2vec2.0コンポーネントをバックボーンとして使用し、MediaPipeアーキテクチャを使用して3Dメッシュと6Dポーズを抽出します。Audio2Meshコンポーネントのトレーニングデータは、内部データセットから得られ、1人のスピーカーから約60分の高品質のスピーチデータで構成されています。MediaPipeコンポーネントによって抽出された3Dメッシュが安定するように、声優は、録音プロセス全体を通じて、カメラに向かって顔を見せ、頭の位置を固定するように指示されます。Lmk2Videoモジュールの場合、AniPortraitは、2ステージのトレーニングアプローチを実装します。最初のステージでは、ReferenceNetとポーズガイダー、バックボーンの2Dコンポーネントをトレーニングし、モーションモジュールを除外します。2番目のステージでは、AniPortraitは、他のすべてのコンポーネントをフリーズし、モーションモジュールのトレーニングに集中します。このステージでは、AniPortraitは、2つの大規模な高品質の顔ビデオデータセットを使用してモデルをトレーニングし、MediaPipeコンポーネントを使用して2Dの顔のランドマークを抽出します。さらに、ネットワークが口の動きに敏感性を高めるために、AniPortraitは、2Dのランドマークからポーズ画像をレンダリングするときに、上唇と下唇を異なる色で区別します。
以下の画像は、AniPortraitが生成するアニメーションの例を示しています。

AniPortraitは、中間的な3D表現を使用して、出力を必要に応じて編集することができます。たとえば、ユーザーは、特定のソースからランドマークを抽出し、IDを変更することができます。したがって、AniPortraitは、顔の再演効果を生成することができます。
最終的な考え
この記事では、AniPortraitという、参考画像とオーディオサンプルから高品質のアニメーションを生成するための新しいフレームワークについて説明しました。AniPortraitは、オーディオサンプルと参考画像を入力するだけで、自然な頭の動きと滑らかな口の動きを持つポートレートビデオを生成することができます。拡散モデルの強力な汎化能力を利用して、AniPortraitは、リアルな画像の質とライクなモーションを持つアニメーションを生成します。AniPortraitの動作は、2つのステージに分かれています。最初のステージでは、AniPortraitは、オーディオサンプルから中間的な3D表現を抽出し、それを2Dの顔のランドマークのシーケンスに投影します。2番目のステージでは、AniPortraitは、拡散モデルとモーションモジュールを使用して、ランドマークのシーケンスを時間的に一貫性のある写実的なアニメーションに変換します。実験結果は、AniPortraitが、高品質のアニメーションを生成する能力と、優れた視覚的な質、ポーズの多様性、顔の自然さを示しています。さらに、AniPortraitは、顔の再演、顔のモーション編集など、さまざまな分野で有効に適用できる、制御性と柔軟性の高い潜在能力を持っています。


