

Modelli e piattaforme di IA
AniPortrait: Sintesi Audio-Driven di Animazioni di Ritratto Fotorealistico

 Aggiungi Unite.AI alle tue fonti preferite su Google
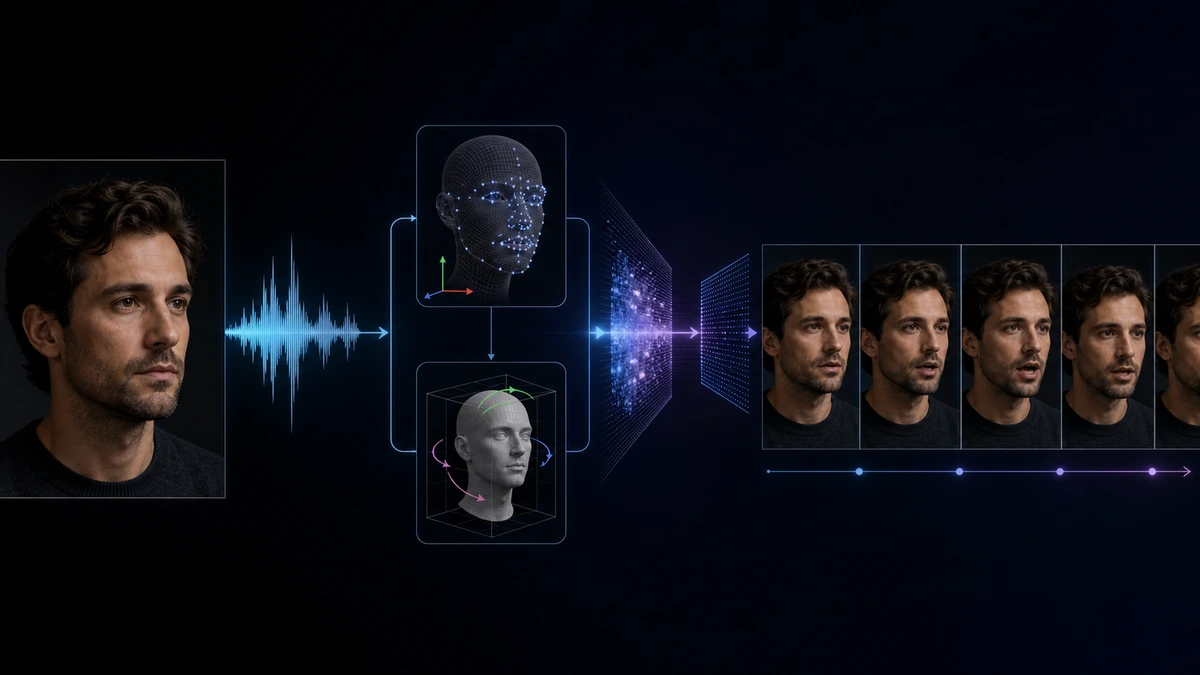
Negli anni, la creazione di ritratti animati realistici ed espressivi da immagini statiche e audio ha trovato una vasta gamma di applicazioni, tra cui giochi, media digitali, realtà virtuale e molto altro. Nonostante le sue potenziali applicazioni, è ancora difficile per gli sviluppatori creare framework in grado di generare animazioni di alta qualità che mantengano la coerenza temporale e siano visualmente accattivanti. Una delle principali cause di questa complessità è la necessità di una coordinazione intricata dei movimenti labiali, delle posizioni della testa e delle espressioni facciali per creare un effetto visualmente coinvolgente.
In questo articolo, parleremo di AniPortrait, un framework innovativo progettato per generare animazioni di alta qualità guidate da un’immagine di riferimento e da un campione audio. Il funzionamento del framework AniPortrait è diviso in due fasi. In primo luogo, il framework AniPortrait estrae le rappresentazioni intermedie 3D dai campioni audio e le proietta in una sequenza di landmark facciali 2D. Successivamente, il framework impiega un modello di diffusione robusto abbinato a un modulo di movimento per convertire la sequenza di landmark in animazioni temporali coerenti e fotorealistiche. I risultati sperimentali dimostrano la superiorità e la capacità del framework AniPortrait di generare animazioni di alta qualità con eccezionale qualità visiva, varietà di pose e naturalità facciale, offrendo così un’esperienza percettiva arricchita e migliorata. Inoltre, il framework AniPortrait ha un potenziale notevole in termini di controllabilità e flessibilità e può essere applicato efficacemente in aree che includono la reenactment facciale, la modifica del movimento facciale e molto altro. Questo articolo si propone di coprire il framework AniPortrait in profondità e di esplorare il meccanismo, la metodologia, l’architettura del framework e il suo confronto con i framework di stato dell’arte. Quindi, iniziamo.
AniPortrait: Animazione di Ritratto Fotorealistico
La creazione di ritratti animati realistici ed espressivi è stata l’obiettivo dei ricercatori per un po’ di tempo, grazie al suo enorme potenziale e alle sue applicazioni che spaziano dai media digitali e dalla realtà virtuale ai giochi e molto altro. Nonostante anni di ricerca e sviluppo, la produzione di animazioni di alta qualità che mantengano la coerenza temporale e siano visualmente accattivanti rappresenta ancora una sfida significativa. Un ostacolo importante per gli sviluppatori è la necessità di una coordinazione intricata tra le posizioni della testa, le espressioni visive e i movimenti labiali per creare un effetto visualmente coinvolgente. I metodi esistenti non sono riusciti a superare queste sfide, principalmente perché la maggior parte di essi si basa su generatori a capacità limitata come NeRF, decoder basati sul movimento e GAN per la creazione di contenuti visivi. Queste reti esibiscono capacità di generalizzazione limitate e sono instabili nella generazione di contenuti di alta qualità. Tuttavia, l’emergere recente dei modelli di diffusione ha facilitato la generazione di immagini di alta qualità, e alcuni framework costruiti su modelli di diffusione e moduli temporali hanno facilitato la creazione di video coinvolgenti, consentendo ai modelli di diffusione di eccellere.
Basandosi sui progressi dei modelli di diffusione, il framework AniPortrait si propone di generare ritratti animati di alta qualità utilizzando un’immagine di riferimento e un campione audio. Il funzionamento del framework AniPortrait è diviso in due fasi. Nella prima fase, il framework AniPortrait impiega modelli basati su trasformatori per estrarre una sequenza di mesh facciali 3D e pose della testa dall’input audio e le proietta successivamente in una sequenza di landmark facciali 2D. La prima fase consente al framework AniPortrait di catturare i movimenti labiali e le espressioni sottili dall’audio, oltre ai movimenti della testa che si sincronizzano con il ritmo del campione audio. La seconda fase, il framework AniPortrait impiega un modello di diffusione robusto e lo integra con un modulo di movimento per trasformare la sequenza di landmark in un ritratto animato fotorealistico e temporalmente coerente. Per essere più specifici, il framework AniPortrait si basa sull’architettura di rete del modello AnimateAnyone, che impiega Stable Diffusion 1.5, un potente modello di diffusione per generare immagini realistiche e fluide in base a un’immagine di riferimento e a una sequenza di movimento del corpo. Ciò che è degno di nota è che il framework AniPortrait non utilizza il modulo di guida della posa all’interno di questa rete, come implementato nel framework AnimateAnyone, ma lo ridisegna, consentendo al framework AniPortrait non solo di mantenere un design leggero, ma anche di esibire una precisione migliorata nella generazione dei movimenti labiali.
I risultati sperimentali dimostrano la superiorità del framework AniPortrait nella creazione di animazioni con una naturalità facciale impressionante, una qualità visiva eccellente e una varietà di pose. Impiegando rappresentazioni facciali 3D come caratteristiche intermedie, il framework AniPortrait guadagna la flessibilità di modificare queste rappresentazioni in base alle proprie esigenze. La flessibilità migliora notevolmente l’applicabilità del framework AniPortrait in diversi domini, tra cui la reenactment facciale e la modifica del movimento facciale.
AniPortrait: Funzionamento e Metodologia
Il framework AniPortrait proposto comprende due moduli, ovvero Lmk2Video e Audio2Lmk. Il modulo Audio2Lmk si propone di estrarre una sequenza di landmark che cattura i movimenti labiali intricati e le espressioni facciali dall’input audio, mentre il modulo Lmk2Video utilizza questa sequenza di landmark per generare video di ritratto di alta qualità con stabilità temporale. La figura seguente presenta una panoramica del funzionamento del framework AniPortrait. Come si può osservare, il framework AniPortrait estrae in primo luogo la mesh facciale 3D e la posa della testa dall’audio e le proietta successivamente in punti chiave 2D. Nella seconda fase, il framework impiega un modello di diffusione per trasformare i punti chiave 2D in un video di ritratto con due fasi addestrate contemporaneamente all’interno della rete.

Audio2Lmk
Per una sequenza di frammenti di discorso dati, l’obiettivo principale del framework AniPortrait è prevedere la sequenza corrispondente di mesh facciali 3D con rappresentazioni vettoriali di traslazione e rotazione. Il framework AniPortrait impiega il metodo wav2vec pre-addestrato per estrarre le caratteristiche audio e il modello esibisce un alto grado di generalizzazione, ed è in grado di riconoscere l’intonazione e la pronuncia dall’audio con precisione, il che gioca un ruolo cruciale nella generazione di animazioni facciali realistiche. Sfruttando le caratteristiche audio robuste acquisite, il framework AniPortrait è in grado di impiegare efficacemente un’architettura semplice costituita da due strati fc per convertire queste caratteristiche in mesh facciali 3D. Il framework AniPortrait osserva che questo design semplice implementato dal modello non solo migliora l’efficienza del processo di inferenza, ma garantisce anche la precisione. Quando si converte l’audio in posa, il framework AniPortrait impiega la stessa rete wav2vec come backbone, sebbene il modello non condivida i pesi con il modulo audio-mesh. Ciò è dovuto principalmente al fatto che la posa è associata più al tono e al ritmo presenti nell’audio, che hanno un’enfasi diversa rispetto ai compiti audio-mesh. Per tenere conto dell’impatto degli stati precedenti, il framework AniPortrait impiega un decodificatore trasformatore per decodificare la sequenza di pose. Durante questo processo, il framework integra le caratteristiche audio nel decodificatore utilizzando meccanismi di cross-attention, e per entrambi i moduli, il framework li addestra utilizzando la perdita L1. Una volta che il modello ottiene la posa e la sequenza di mesh, impiega la proiezione prospettica per trasformare queste sequenze in una sequenza 2D di landmark facciali, che vengono utilizzati come segnali di input per la fase successiva.
Lmk2Video
Per un’immagine di ritratto di riferimento data e una sequenza di landmark facciali, il modulo Lmk2Video proposto crea un’animazione di ritratto temporalmente coerente, e questa animazione allinea il movimento con la sequenza di landmark e mantiene un aspetto che è coerente con l’immagine di riferimento, e infine, il framework rappresenta l’animazione di ritratto come una sequenza di frame di ritratto. La progettazione della struttura di rete di Lmk2Video trae ispirazione dal framework AnimateAnyone esistente. Il framework AniPortrait impiega Stable Diffusion 1.5, un modello di diffusione estremamente potente come suo backbone, e incorpora un modulo di movimento temporale che converte efficacemente gli input di rumore multi-frame in una sequenza di frame di video. Allo stesso tempo, un componente di rete ReferencenNet rispecchia la struttura di Stable Diffusion 1.5 e lo impiega per estrarre le informazioni di aspetto dall’immagine di riferimento e le integra nel backbone. La progettazione strategica garantisce che l’identità facciale rimanga coerente in tutto il video di output. A differenza del framework AnimateAnyone, il framework AniPortrait migliora la complessità della progettazione di PoseGuider. La versione originale del framework AnimateAnyone comprende solo alcuni strati di convoluzione dopo i quali le caratteristiche dei landmark si fondono con i latenti nel layer di input del backbone. Il framework AniPortrait scopre che questo design è carente nel catturare i movimenti intricati delle labbra, e per affrontare questo problema, il framework adotta la strategia multi-scala dell’architettura ConvNet e incorpora le caratteristiche dei landmark di scale corrispondenti in diversi blocchi del backbone. Inoltre, il framework AniPortrait introduce un miglioramento aggiuntivo includendo i landmark dell’immagine di riferimento come input aggiuntivo. Il modulo di cross-attention del componente PoseGuider consente l’interazione tra i landmark di destinazione di ogni frame e i landmark di riferimento. Questo processo fornisce alla rete ulteriori indizi per comprendere la correlazione tra aspetto e landmark facciali, aiutando così nella generazione di animazioni di ritratto con movimenti più precisi.
AniPortrait: Implementazione e Risultato
Per la fase Audio2Lmk, il framework AniPortrait adotta il componente wav2vec2.0 come suo backbone e sfrutta l’architettura MediaPipe per estrarre mesh 3D e pose 6D per le annotazioni. Il modello ottiene i dati di addestramento per il componente Audio2Mesh dal suo dataset interno, che comprende circa 60 minuti di dati di discorso di alta qualità provenienti da un solo speaker. Per garantire che la mesh 3D estratta dal componente MediaPipe sia stabile, l’attore vocale è istruito a guardare la telecamera e mantenere una posizione della testa costante durante l’intero processo di registrazione. Per il modulo Lmk2Video, il framework AniPortrait implementa un approccio di addestramento a due fasi. Nella prima fase, il framework si concentra sull’addestramento di ReferenceNet e PoseGuider, il componente 2D del backbone, e lascia fuori il modulo di movimento. Nel secondo passo, il framework AniPortrait congela tutti gli altri componenti e si concentra sull’addestramento del modulo di movimento. Per questa fase, il framework utilizza due grandi dataset di video facciali di alta qualità per addestrare il modello e processa tutti i dati utilizzando il componente MediaPipe per estrarre landmark facciali 2D. Inoltre, per migliorare la sensibilità della rete nei confronti dei movimenti labiali, il modello AniPortrait differenzia le labbra superiori e inferiori con colori diversi quando rende l’immagine della posa dai landmark 2D.
Come dimostrato nell’immagine seguente, il framework AniPortrait genera una serie di animazioni che dimostrano una qualità e una realismo superiori.

Il framework utilizza quindi una rappresentazione intermedia 3D che può essere modificata per manipolare l’output in base alle esigenze. Ad esempio, gli utenti possono estrarre i landmark da una certa fonte e alterarne l’ID, consentendo così al framework AniPortrait di creare un effetto di reenactment facciale.
Pensieri Finali
In questo articolo, abbiamo parlato di AniPortrait, un framework innovativo progettato per generare animazioni di alta qualità guidate da un’immagine di ritratto di riferimento e da un campione audio. Inserendo semplicemente un’immagine di riferimento e un clip audio, il framework AniPortrait è in grado di generare un video di ritratto che presenta movimenti naturali della testa e movimenti labiali fluidi. Sfruttando le robuste capacità di generalizzazione del modello di diffusione, il framework AniPortrait genera animazioni che mostrano una qualità di immagine realistica impressionante e un movimento realistico. Il funzionamento del framework AniPortrait è diviso in due fasi. In primo luogo, il framework AniPortrait estrae le rappresentazioni intermedie 3D dai campioni audio e le proietta in una sequenza di landmark facciali 2D. Successivamente, il framework impiega un modello di diffusione robusto abbinato a un modulo di movimento per convertire la sequenza di landmark in animazioni temporali coerenti e fotorealistiche. I risultati sperimentali dimostrano la superiorità e la capacità del framework AniPortrait di generare animazioni di alta qualità con eccezionale qualità visiva, varietà di pose e naturalità facciale, offrendo così un’esperienza percettiva arricchita e migliorata. Inoltre, il framework AniPortrait ha un potenziale notevole in termini di controllabilità e flessibilità e può essere applicato efficacemente in aree che includono la reenactment facciale, la modifica del movimento facciale e molto altro.


