
Dasar-dasar AI
Apa itu Computer Vision?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Computer vision adalah bidang pembuatan sistem yang mengekstrak informasi berguna dari gambar dan video. Model visi dapat mengklasifikasikan seluruh gambar, menemukan objek, memberi label setiap piksel, membaca teks, memperkirakan pose, melacak gerakan, atau menghubungkan konten visual dengan bahasa.
Sistem visi modern tidak sekadar meniru proses deteksi tepi awal pada persepsi manusia. Mereka mempelajari representasi khusus tugas dari data, seringkali menggunakan convolutional neural networks, vision transformers, atau model foundation multimodal.
Poin-poin utama
- Klasifikasi, deteksi, segmentasi, OCR, pelacakan, dan generasi adalah tugas visi yang berbeda.
- CNN membangun lokalitas dan berbagi bobot; vision transformer menggunakan attention di seluruh patch gambar.
- Label dapat berasal dari manusia, supervisi lemah, data sintetis, atau tujuan pembelajaran mandiri.
- Akurasi saja tidak cukup: ketahanan, latensi, privasi, bias, dan biaya kegagalan juga penting.
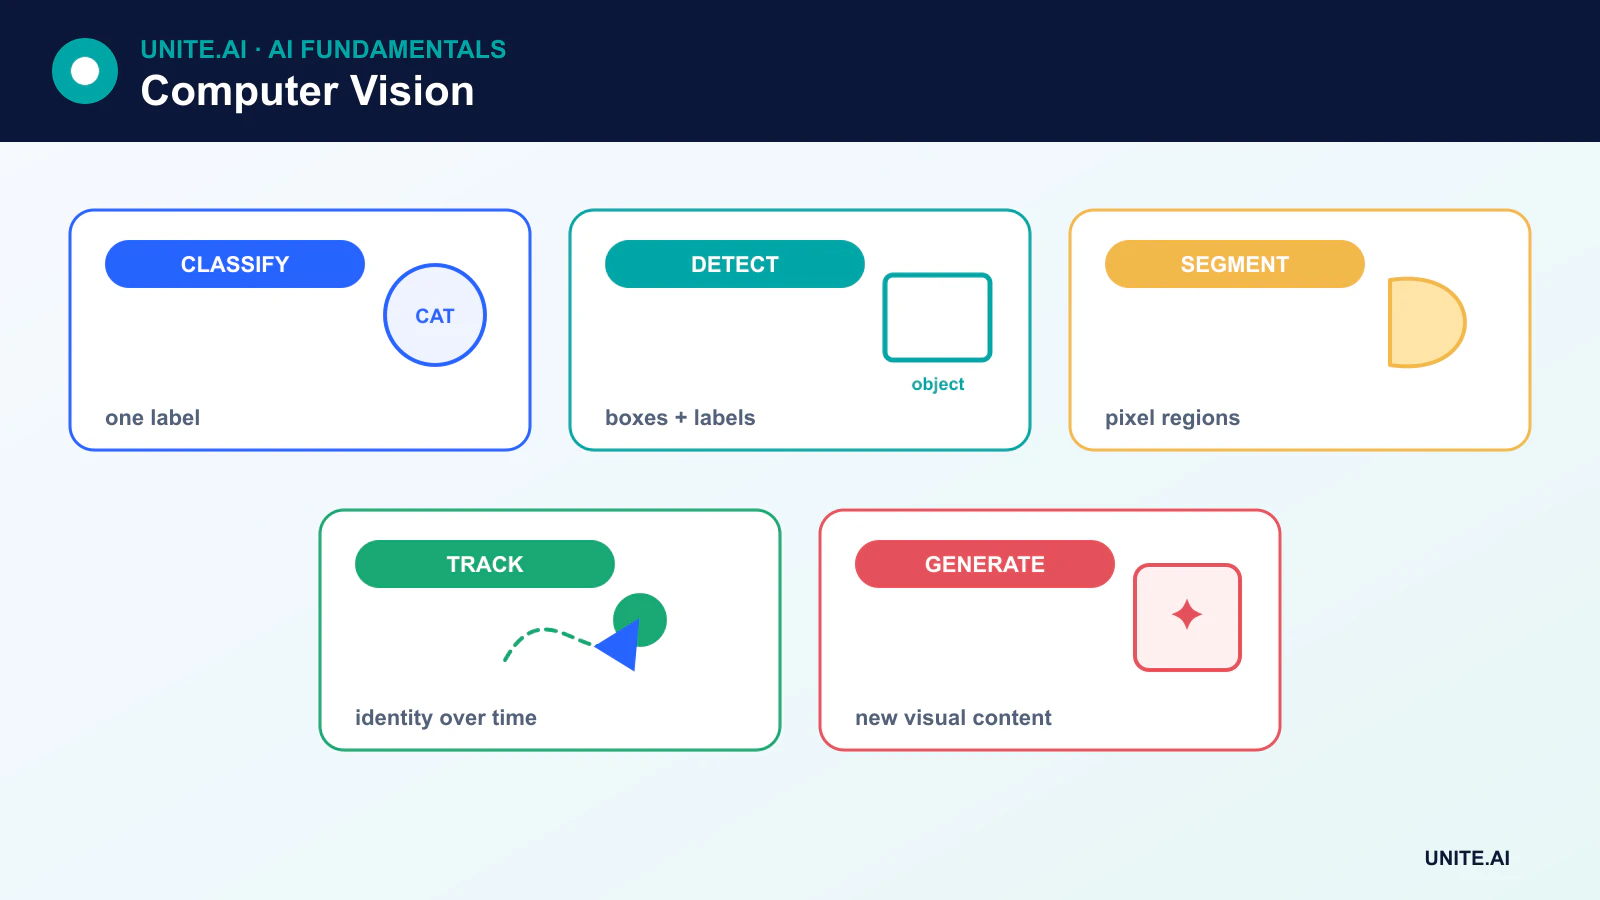
Tugas utama computer-vision
- Image classification memberikan satu atau lebih label pada sebuah gambar. Lihat cara kerja image classification.
- Object detection memprediksi kategori dan kotak pembatas untuk beberapa objek.
- Semantic segmentation memberi label setiap piksel berdasarkan kelas, sementara instance segmentation memisahkan objek-objek individu.
- Optical character recognition (OCR) mendeteksi dan menyalin teks.
- Pose estimation memprediksi titik landmark tubuh atau objek.
- Tracking mengasosiasikan deteksi di seluruh frame video.
- Image generation and editing menghasilkan atau mengubah konten visual, seringkali menggunakan diffusion models.
Bagaimana gambar menjadi masukan model
Gambar digital sudah berupa data numerik: sebuah tensor yang berisi nilai piksel pada dimensi spasial dan saluran. Pra‑pemrosesan dapat mengubah ukuran, menormalkan, memotong, atau memperbanyak gambar. Video menambahkan dimensi waktu, sementara pencitraan medis dan ilmiah dapat menambahkan kedalaman, panjang gelombang, atau modalitas lain.
Computer vision klasik menggunakan fitur tepi, sudut, dan tekstur yang dirancang secara manual. Model deep modern biasanya mempelajari fitur secara bersamaan dengan tugas, meskipun metode klasik tetap berguna ketika data terbatas, aturan dipahami dengan baik, atau komputasi harus minimal.
CNN dan fitur lokal yang dipelajari
CNN menerapkan kernel yang dipelajari pada lingkungan lokal. Lapisan awal dapat merespons pola lokal, sementara blok selanjutnya menggabungkannya menjadi representasi yang relevan dengan tugas. Operasi pooling atau stride mengurangi resolusi spasial, dan residual connection memudahkan optimasi jaringan yang dalam.
Klasifier CNN modern sering menggunakan global pooling alih‑alih tumpukan besar lapisan fully connected. Detektor dan jaringan segmentasi menambahkan kepala khusus atau jalur decoder yang mempertahankan informasi spasial.
Vision transformer dan model foundation
Vision transformer membagi gambar menjadi patch, meng-embed‑nya, dan menggunakan attention untuk memodelkan hubungan antar patch. Transformer dapat diskalakan secara efektif dengan dataset besar dan pretraining, sementara CNN sering memberikan asumsi bawaan yang lebih kuat dan efisiensi pada skala kecil.
Model multimodal menyelaraskan gambar dengan teks sehingga pengguna dapat mencari, memberi keterangan, menjawab pertanyaan, atau mengarahkan segmentasi menggunakan bahasa. Model ini memperluas kemampuan namun juga mewarisi kelemahan dari data berskala web yang luas, termasuk stereotip, materi berhak cipta, dan cakupan yang tidak merata terhadap populasi dan lingkungan.
Label, pembelajaran mandiri, dan data sintetis
Kotak pembatas, mask, landmark, dan keterangan dapat mahal untuk dibuat. Pembelajaran mandiri (self‑supervised) menghasilkan tujuan dari gambar itu sendiri, sementara supervisi lemah menggunakan label yang berisik atau tidak langsung. Data sintetis dapat menambahkan skenario langka, namun kesenjangan simulasi dapat menghalangi kinerja sintetis untuk ditransfer ke dunia nyata.
Kualitas anotasi harus diukur. Label yang ambigu, batas yang tidak konsisten, dan objek yang hilang menempatkan batas atas pada kinerja dan dapat menyembunyikan kegagalan pada subkelompok.
Bagaimana sistem visi dievaluasi
Klasifikasi menggunakan metrik seperti akurasi, presisi, recall, F1, dan kalibrasi. Deteksi umumnya menggunakan intersection over union dan mean average precision. Segmentasi menggunakan intersection over union atau ukuran bergaya Dice. Pelacakan menambahkan metrik identitas dan lintasan.
Metrik harus sesuai dengan penerapan. Sebuah model dapat memperoleh skor tinggi pada benchmark terkurasi namun tetap gagal dalam hujan, cahaya rendah, sudut kamera yang tidak biasa, perangkat baru, atau populasi yang tidak dikenal. Evaluasi harus mencakup pergeseran distribusi, kondisi adversarial, dan latensi operasional.
Privasi, bias, dan penerapan
Wajah, plat nomor, rumah, pemindaian medis, dan video tempat kerja dapat mengungkap informasi sensitif. Pengumpulan dan penyimpanan harus mengikuti dasar hukum dan etika yang jelas, dengan kontrol akses dan minimisasi data. Analisis wajah dan identifikasi biometrik memerlukan perhatian khusus karena kesalahan dan pengawasan dapat menimbulkan kerugian yang tidak merata.
Penerapan di edge dapat mengurangi latensi dan transfer data. Edge AI, kuantisasi, pruning, dan akselerator khusus dapat membuat sistem visi praktis pada kamera, kendaraan, robot, dan perangkat seluler, namun kompresi harus dievaluasi kembali untuk akurasi dan bias.
Dari piksel ke tugas visual
Computer vision mengubah gambar atau video menjadi keluaran tugas seperti klasifikasi, deteksi, segmentasi, pelacakan, pose, kedalaman, optical flow, atau pengenalan teks. Definisi tugas menentukan anotasi: label gambar tidak dapat melatih lokalisasi yang tepat, dan kotak pembatas tidak dapat sepenuhnya menggambarkan mask segmentasi. Geometri kamera, lensa, eksposur, pencahayaan, gerakan, kompresi, dan sudut pandang membentuk distribusi data. Tentukan lingkungan operasi dan konsekuensi kesalahan sebelum memilih model, karena kumpulan gambar benchmark mungkin tidak mewakili sensor atau adegan yang diterapkan.
Suatu pipeline mendekode dan mengorientasikan media, mengubah ukuran atau menatanya, menormalkan nilai, menerapkan augmentasi yang mempertahankan label, menjalankan model, dan memproses pasca logits, kotak, mask, atau trek. Detektor objek menggunakan ambang kepercayaan dan supresi; pelacak mengasosiasikan deteksi seiring waktu; segmentasi mungkin memerlukan pembersihan morfologis. Pertahankan transformasi koordinat agar keluaran selaras dengan gambar asli. Bagi data berdasarkan orang, kamera, lokasi, atau sesi pengambilan untuk menghindari frame yang hampir identik muncul di set pelatihan dan pengujian.
Evaluasi, bias, privasi, dan operasi
Metrik harus sesuai dengan tugas dan penggunaan. Klasifikasi membutuhkan presisi dan recall spesifik kelas; deteksi menggunakan intersection‑over‑union dan average precision di berbagai ambang; segmentasi menggunakan IoU atau Dice; pelacakan menambahkan pergantian identitas; latensi dan durasi peristiwa yang terlewat penting untuk video. Laporkan hasil berdasarkan pencahayaan, jarak, perangkat, occlusion, warna kulit, usia, dan kondisi relevan lainnya. Periksa kalibrasi dan kesalahan dengan kepercayaan tinggi. Data sintetis atau yang ditambah dapat mengisi celah namun memerlukan perbandingan dengan data penerapan nyata dan tidak boleh membocorkan adegan uji.
Vision dapat mengumpulkan orang di sekitar, lokasi, biometrik, dan perilaku sensitif. Minimalkan pengambilan dan penyimpanan, amankan aliran, batasi penggunaan sekunder, dan berikan pemberitahuan atau persetujuan bila diperlukan. Uji patch adversarial, replay, occlusion, kegagalan kamera, dan pergeseran domain. Pantau kesehatan sensor, statistik input, laju keluaran, dan hasil yang dikonfirmasi; pertahankan peninjauan manusia untuk keputusan penting. Blur atau pemotongan dapat mengurangi paparan namun juga dapat menghilangkan bukti. Skor laboratorium tinggi tidak membenarkan klaim identitas, emosi, atau niat di luar tugas yang divalidasi.
Contoh kerja: deteksi pejalan kaki di persimpangan gudang
Kamera memantau persimpangan kendaraan terbatas, dan model mendeteksi orang tanpa mengidentifikasi mereka. Data mencakup siang dan malam, cuaca, pakaian, occlusion, pengguna kursi roda, posisi kamera, dan adegan kosong, dipisahkan berdasarkan sesi rekaman. Detektor dievaluasi untuk recall peristiwa, alarm palsu, lokalisasi, waktu peringatan, dan kinerja pada jarak. Rekayasa keselamatan menentukan latensi maksimum yang dapat ditoleransi dan kontrol fisik independen.
Peringatan visi dapat memperlambat kendaraan, namun pemberhentian darurat dan penghalang tidak bergantung pada model yang dipelajari. Obstruksi kamera, frame beku, kehilangan jaringan, dan timeout model menghasilkan kesalahan eksplisit. Penyimpanan video mentah diminimalkan dan akses dicatat. Pemantauan melacak kesehatan sensor, tingkat peringatan, insiden yang ditinjau, dan hampir‑celaka berdasarkan kondisi. Setiap relokasi kamera atau perubahan tata letak memicu validasi ulang karena kemiripan gambar yang tampak tidak menjamin geometri atau risiko yang sama.
Bukti implementasi dan kesiapan operasional
Keputusan produksi memerlukan lebih dari sekadar demonstrasi yang berhasil. Tentukan pengguna yang ditargetkan, lingkungan operasi, masukan, keluaran, ketergantungan, pemilik, dan konsekuensi dari setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, masukan yang rusak atau hilang, pergeseran distribusi, kegagalan ketergantungan, penyalahgunaan, serta kelompok atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang sengaja disuntikkan. Telemetri operasional harus mengungkap kualitas masukan, perilaku keluaran, versi model atau aturan, kesehatan ketergantungan, intervensi manusia, dan hasil yang dikonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Tentukan ambang peringatan dan pemilik respons, kemudian tinjau bukti dunia nyata setelah penerapan alih‑alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan dokumentasi pemulihan, pembelajaran insiden, prosedur penghapusan dan penyimpanan, serta titik jelas kapan harus dinonaktifkan atau diganti.
Pertanyaan yang sering diajukan
Apakah computer vision sama dengan pengenalan gambar?
Tidak. Pengenalan gambar biasanya merujuk pada klasifikasi atau identifikasi. Computer vision juga mencakup lokalisasi, segmentasi, pengukuran, pelacakan, rekonstruksi, generasi, dan penalaran atas informasi visual.
Apakah sistem visi melihat seperti manusia?
Tidak. Sebuah model memproses masukan numerik sesuai dengan arsitektur dan tujuan pelatihannya. Model dapat mengungguli manusia pada benchmark sempit namun gagal pada perubahan kecil yang mudah ditangani orang.
Referensi utama












