
Sudut Anderson
Di Luar Pandangan, Di Luar Pikiran: Mengatasi Masalah Terbesar dalam AI Video

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
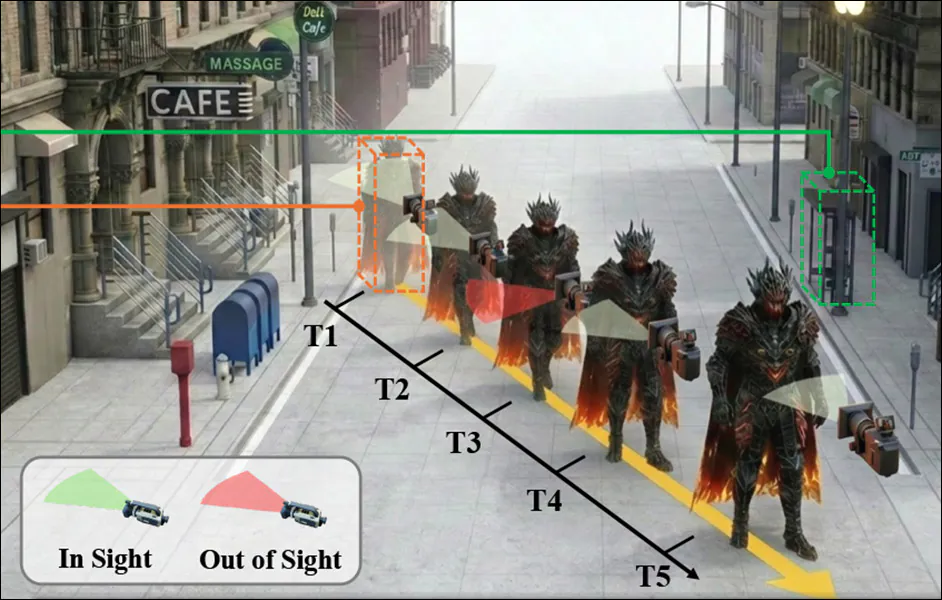
Masalah terbesar dengan bahkan generator video AI terbaik adalah bahwa mereka memiliki amnesia kronis – tantangan yang sekarang ditangani oleh penelitian baru dari Cina.
Masalah terbesar dengan bahkan sistem generasi video AI terbaik dan paling canggih adalah bahwa mereka semua memiliki amnesia kronis: jika kamera melakukan pan menjauh dari objek yang dibidik lalu melakukan pan kembali, itu tidak akan pernah menemukan apa yang ada di awal – karakter akan menghilang, berubah penampilan dan/atau jenis gerakan, dan latar belakang kemungkinan juga akan berubah.
Ini karena sistem generasi berbasis difusi memiliki jendela perhatian bergeser yang terbatas, dan karena itu selalu berhadapan dengan apa yang dapat dilihat pada saat itu; dalam sebuah enkarnasi yang sebenarnya dari solipsisme, apa yang di luar dari bingkai adalah tidak ada bagi AI generatif – itu menjadi secara harfiah dibuang dari memori.
Ini tidak pernah menjadi masalah dalam CGI tradisional, yang dapat selalu merujuk dan menciptakan kembali subjek dengan akurat, termasuk penampilan dan gerakan, pada titik mana pun dalam video yang mungkin diperlukan lagi:

Mesh dan tekstur bitmapped CGI tradisional dapat selalu digambar kembali ke dalam render, memberikan penampilan yang konsisten – trik yang jauh lebih sulit untuk dicapai dalam pendekatan AI, karena tidak ada berkas atau kumpulan berkas terkait sebagai ‘referensi datar’ yang setara.
Ini karena elemen-elemen CGI, seperti mesh dan tekstur (lihat gambar di atas), serta file gerakan dan perilaku dinamis lainnya, dapat hidup secara terpisah di disk, dan dapat digambar ke dalam komposisi kapan saja.
Tidak ada ‘gudang datar’ seperti itu dalam AI video generatif; yang paling dekat dengan fungsionalitas ini adalah LoRAs – file pelengkap khusus yang dapat dilatih pada peralatan konsumen, memungkinkan karakter dan pakaian baru untuk ‘dipaksa’ ke dalam video:
Klik untuk memutar. Masalah solipsisme AI video dapat diminimalkan sampai batas tertentu dengan menggunakan LoRAs – tetapi hasilnya dapat terlalu mendominasi.
Ini bukanlah solusi ideal, bagaimanapun. Untuk satu hal, LoRAs terikat pada versi tertentu dari model dasar (seperti Wan2+, atau Hunyuan Video), dan perlu dibuat ulang setiap kali model dasar berubah. Untuk yang lain, LoRAs cenderung mengubah bobot dari model dasar, sehingga identitas LoRA yang dilatih diterapkan pada semua karakter dalam adegan. Selain itu, metode fine-tuning dari jenis ini sangat peka terhadap dataset yang tidak dikurasi dengan baik.
Pengulangan Akurat
Sekarang, sebuah kolaborasi akademis/industri baru dari Cina menawarkan solusi pertama yang signifikan yang telah saya temukan dalam lebih dari tiga tahun melaporkan masalah ini. Metode ini menggunakan apa yang disebut peneliti sebagai memori hibrida untuk menjaga karakter di luar layar dan lingkungan terdekatnya tetap aktif dan akurat dalam ruang laten model, sehingga ketika pandangan kita kembali ke mereka, efeknya konsisten:
Klik untuk memutar. Dari situs proyek untuk makalah baru, dua contoh karakter AI yang dihasilkan (WAN) keluar bingkai dan kembali masuk dengan akurat. Sumber
Perlu ditekankan bahwa ini bukanlah hal yang sama dengan mencapai konsistensi karakter di berbagai pengambilan gambar – sesuatu yang diklaim telah dicapai setahun yang lalu dalam rilis Gen 4 Runway, dan yang tetap upaya berkelanjutan dalam literatur penelitian.
Sebaliknya, apa yang diselesaikan di sini adalah sesuatu yang tidak pernah dapat dicapai oleh kerangka komersial atau eksperimental yang pernah saya lihat – penampilan kembali yang konsisten dari penampilan, gerakan, dan lingkungan karakter yang keluar dari bingkai:
Klik untuk memutar. Dua contoh utama lainnya yang diberikan di situs proyek inisiatif baru.
Tentu saja, prinsip-prinsip yang bekerja di sini dapat diterapkan pada domain lain, seperti eksplorasi kota, mengemudi POV, atau jenis rendering non-karakter lainnya.
Perlu ditekankan juga bahwa pendekatan baru ini tidak menyelesaikan atau mengatasi masalah yang diklaim telah diatasi oleh Runway Gen4 dan platform tertutup lainnya, dengan menciptakan kembali karakter di berbagai pengambilan gambar; sebaliknya, itu melakukan apa yang belum pernah mereka capai – mempertahankan karakter dan lingkungan dalam memori, tanpa perlu mereka tetap terlihat oleh pemirsa setiap saat.
Pekerjaan baru ini terdiri dari dataset khusus yang dihasilkan melalui Unreal Engine, serta metrik khusus untuk masalah solipsisme*, dan kerangka generatif khusus yang dibangun di atas WAN. Dalam tes melawan beberapa sistem yang setara, penulis mengklaim hasil state-of-the-art, dan mereka mengomentari:
‘[Memori] mekanisme telah muncul sebagai frontier kritis dalam memajukan model dunia, karena kapasitas memori menentukan konsistensi spasial dan temporal dari konten yang dihasilkan.
‘Secara khusus, itu adalah jangkar kognitif yang memungkinkan model untuk mempertahankan konteks historis selama pergeseran pandangan atau ekstrapolasi jangka panjang.
‘Tanpa memori yang kuat, dunia yang disimulasikan dengan cepat menjadi tidak terkait, bingkai yang kacau.’
Makalah baru ini berjudul Diluar Pandangan, Tapi Tidak Diluar Pikiran: Memori Hibrida untuk Model Dunia Video Dinamis, dan berasal dari tujuh peneliti di Huazhong University of Science and Technology, dan Tim Kling di Kuaishou Technology.
Metode
Inti dari penelitian baru ini adalah memori hibrida, yang memfasilitasi ‘ekstrapolasi keluar dari pandangan’ – pemeliharaan karakter dan konteksnya sementara pemirsa ‘menatap menjauh’ (atau sementara karakter itu sendiri keluar dari pandangan). Dalam skenario ini, kerangka ini memerlukan untuk melakukan pemisahan spasial dan temporal, di mana ia secara bersamaan fokus pada generasi yang terlihat oleh pemirsa, dan keberadaan karakter yang keluar dari pandangan.

Contoh gerakan kamera masuk/keluar. Dalam contoh ini, gerakan kamera menyebabkan karakter keluar dari bingkai, tetapi dalam sampel yang beragam kita juga dapat mengamati karakter itu sendiri sementara mendorong diri mereka sendiri ke luar layar. Sumber
Penulis mencatat bahwa dalam embeddings laten difusi, fitur yang perlu diekstrak dan digunakan sangat terjalin dengan fitur dan properti lain; dan bahwa mencoba mengekstraknya sering menyebabkan subjek ‘membeku’ ke latar belakang. Oleh karena itu mereka merancang dan mengkurasi dataset HM-World**, khusus untuk melatih memori hibrida:

Dari makalah, sampel dari empat kategori yang terkandung dalam dataset HM-World.
Koleksi ini dibangun sepanjang empat dimensi: lintasan subjek, lintasan kamera, adegan, dan subjek.
Data sintetis dalam HM-World memiliki 17 adegan dan 49 subjek, termasuk orang dengan penampilan yang beragam, serta hewan dari beberapa spesies. Kombinasi dari ini ditempatkan secara prosedural dalam sebuah adegan melalui Unreal Engine, masing-masing dengan animasi gerakan yang unik, dan kemudian ditempatkan pada lintasan yang dipilih secara acak.
Penulis menyatakan bahwa sebuah set beragam peristiwa keluar-masuk digambarkan dalam dataset, dengan 28 lintasan kamera yang berbeda, masing-masing dengan beberapa titik awal.
Koleksi akhir mencapai 59.225 klip video, masing-masing dianotasi oleh MiniCPM-V Multimodal Large Language Model (MLLM).
Peneliti menunjukkan keuntungan statistik dari koleksi mereka dibandingkan dengan dataset sebelumnya WorldScore; Context-As-Memory; Multi-Cam Video; dan 360° Motion:

Perbandingan antara dataset yang ada dan dataset HM-World, di mana ‘Subjek Dinamis’ menunjukkan kehadiran entitas yang bergerak, ‘Keluar-Masuk Subjek’ menunjukkan klip yang berisi subjek yang meninggalkan dan kembali ke bingkai, dan ‘Pose Subjek’ merujuk pada inklusi pose 3D yang dianotasi.
Jalan yang Kurang Dilalui
Diberikan beberapa frame sebelumnya dan jalur kamera yang diketahui, tugasnya adalah memprediksi tampilan masa depan saat perspektif pemirsa bergeser, sambil mempertimbangkan subjek yang bergerak secara independen dan mungkin meninggalkan bingkai sebelum kembali. Ini memerlukan lebih dari mempertahankan latar belakang yang stabil, karena model harus juga mempertahankan catatan internal yang kohesif tentang bagaimana setiap subjek yang bergerak terlihat dan berperilaku, bahkan selama periode ketika tidak terlihat.
Metode Hybrid Dynamic Retrieval Attention (HyDRA) penulis mengatasi ini dengan memperkenalkan jalur memori khusus yang memisahkan subjek dinamis dari representasi adegan statis, memungkinkan mereka untuk bertahan seiring waktu, dan muncul kembali dengan penampilan dan gerakan yang konsisten:

Skema konseptual untuk model HyDRA.
HyDRA dibangun di atas Wan2.1-T2V-1.3B, dengan alur difusi inti yang sebagian besar tetap utuh, sementara memperkenalkan blok transformer yang dimodifikasi yang mengintegrasikan perhatian pengambilan dinamis. Ini memungkinkan model untuk secara selektif mengingat petunjuk gerakan dan penampilan dari frame sebelumnya, bukan bergantung pada konteks yang tetap atau lokal.
Proses ini menggunakan tujuan pelatihan Flow Matching yang disesuaikan sebagai pengganti fungsi loss difusi standar.
Untuk menjaga adegan yang sejalan dengan gerakan kamera, lintasan kamera disuntikkan sebagai sinyal kondisi yang eksplisit, dengan setiap pose bingkai didefinisikan oleh rotasi dan translasi, dan kemudian diubah menjadi representasi yang ringkas yang menangkap bagaimana pandangan berkembang seiring waktu.
Sejalan dengan inisiatif ReCamMaster dari Kling sebelumnya, hasilnya kemudian diproses oleh pengode kamera yang diimplementasikan sebagai Perceptron Multi-Layer, lalu disebarkan dan ditambahkan ke fitur Diffusion Transformer. Dengan demikian, model dapat mempertahankan penempatan objek yang konsisten saat kamera bergerak.
Tokenisasi
Latens difusi mentah mencampurkan gerakan subjek, penampilan, dan latar belakang menjadi representasi yang terjalin tunggal, dan mencoba mengambil langsung dari ruang ini berisiko memperkenalkan konteks yang tidak relevan, atau menyebabkan subjek bergerak menyatu dengan latar belakang.
HyDRA mengatasi ini dengan Tokenizer Memori 3D-berbasis konvolusi yang memproses ruang dan waktu bersama – bukan meneruskan sejarah laten penuh, itu mengompresi mereka menjadi token memori yang ringkas dan sadar gerakan yang mempertahankan bagaimana subjek terlihat dan bergerak:

Ikhtisar HyDRA. Kiri, Tokenizer Memori mengubah frame sebelumnya menjadi token memori yang ringkas dan sadar gerakan; kanan, Perhatian Pengambilan Dinamis mengevaluasi kueri saat ini melawan token ini, mengambil yang paling relevan, dan menggunakannya untuk memulihkan penampilan dan gerakan yang konsisten dalam frame yang dihasilkan.
Token-token ini membentuk memori hibrida yang terstruktur yang menyaring kebisingan sambil mempertahankan dinamika jangka panjang. Diteruskan ke Modul Perhatian Pengambilan Dinamis, token-token ini memungkinkan model untuk secara selektif mengingat subjek yang keluar dari pandangan, sehingga mereka muncul kembali dengan penampilan, gerakan, dan konteks yang konsisten.
Perhatian Pengambilan Dinamis
Mekanisme memori ganda HyDRA juga menggunakan perhatian pengambilan dinamis dalam peran yang berbeda tetapi komplementer dalam kerangka ini.
Tokenisasi memori mengompresi representasi laten sebelumnya menjadi token yang terstruktur dan sadar gerakan yang memisahkan subjek dinamis dari konten adegan statis, mengurangi kejalinan yang sering menyebabkan subjek menyatu dengan latar belakang. Token-token ini membentuk bank memori yang persisten bukan sejarah frame penuh.
Perhatian Pengambilan Dinamis kemudian beroperasi di atas bank ini selama generasi, mengevaluasi kueri saat ini melawan token yang disimpan dan secara selektif mengingat yang paling relevan. Ini memungkinkan subjek yang keluar dari pandangan untuk terus berevolusi secara laten (yaitu, untuk terus berjalan, berlari, ketika Anda tidak dapat melihatnya), dan muncul kembali dengan penampilan dan gerakan yang konsisten ketika mereka kembali ke pandangan, bukan mereset atau memburuk.
Data dan Tes
Dalam tes, sistem HyDRA berbasis Wan mengkodekan dan menurunkan 77 frame konteks sebelum memparsinya dengan 3D Variational Autoencoder (VAE), sementara Tokenizer Memori yang disebutkan sebelumnya menggunakan konvolusi 3D dengan ukuran kernel 2x4x4.
Model ini dilatih pada HW-World selama 10.000 iterasi pada 32 (tidak ditentukan) GPU, dengan ukuran batch 32.
Jumlah metrik yang luar biasa banyak digunakan dalam tes: selain rasio sinyal-ke-bisingan puncak (PSNR), Indeks Kesamaan Struktural (SSIM), dan Metrik Kesamaan Perseptual yang Dipelajari (LPIPS), penulis juga menggunakan konsistensi subjek dan konsistensi latar belakang dari suite VBench, untuk mengevaluasi kohesi frame-level.
Selain itu, mereka mengembangkan metrik khusus yang disebut Konsistensi Subjek Dinamis (DSC), yang menggunakan kotak pembatas dari YOLO V11, untuk membuat wilayah yang dipotong yang menampilkan subjek yang bergerak, dari mana fitur semantik diekstrak dan kesamaannya kemudian dihitung.
HyDRA dipasang melawan Diffusion Forcing Transformer (DFoT), dan Context-As-Memory, melawan model dasar Wan2.1-T2V-1.3B yang dilengkapi dengan pengkode kamera (untuk merepresentasikan pandangan subjektif yang umum untuk semua klip). Semua model dilatih pada HW-World, dan WorldPlay juga digunakan sebagai koleksi pengujian sekunder zero-shot:
Dalam perbandingan kuantitatif awal, HyDRA mengungguli semua baseline, meningkatkan PSNR dari 18,696 menjadi 20,357, dan SSIM dari 0,517 menjadi 0,606. Ini juga mencapai skor Dice kontekstual dan ground truth tertinggi, 0,827 dan 0,849, dengan Konsistensi Subjek dan Latar Belakang mencapai 0,926 dan 0,932:

Hasil perbandingan kuantitatif awal melawan pendekatan sebelumnya.
DFoT mencapai 17,693 PSNR dan Konteks sebagai Memori 18,921, dengan keuntungan yang dikaitkan dengan tokenisasi memori yang dikombinasikan dengan perhatian pengambilan dinamis:

Perbandingan kuantitatif yang memasang HyDRA melawan metode paling mutakhir saat ini.
Mengenai tes melawan WorldPlay, penulis menyatakan:
‘Metode kami melampaui WorldPlay di semua metrik, dengan celah PSNR yang signifikan sebesar 5,502. Meskipun WorldPlay menunjukkan kinerja yang lebih rendah pada metrik referensi ground truth (misalnya, PSNR 14,855, DSCGT 0,832) karena kesenjangan distribusi domain dan tidak adanya fine-tuning khusus, itu menunjukkan ketahanan yang mengesankan pada metrik referensi kontekstual dengan mencapai DSCctx 0,822.
‘Pengamatan ini tidak hanya mengkonfirmasi bahwa model yang dilatih secara ekstensif memiliki konsistensi hibrida yang cukup baik, tetapi juga secara tidak langsung memvalidasi rasionalitas metrik DSC yang kami usulkan dalam merefleksikan konsistensi subjek dinamis.
‘Akhirnya, hasil yang mengesankan ini menyoroti kemampuan luar biasa dari model kami, menunjukkan superioritasnya bahkan atas model komersial yang mapan.’
Makalah ini menawarkan representasi statis dari perbandingan kualitatif yang dilakukan untuk tes:

Perbandingan kualitatif keluar dan masuk di bawah gerakan kamera. Penulis menyatakan bahwa HyDRA mempertahankan identitas subjek, pose, dan kontinuitas gerakan setelah meninggalkan dan kembali ke bingkai, sangat dekat dengan ground truth, sedangkan metode lain menunjukkan drift, gerakan tidak kohesif, atau degradasi subjek, yang ditandai dengan warna merah (pemulihan konsisten ditandai dengan warna hijau).
Mengenai hasil ini, penulis mengomentari:
‘Dalam kasus peristiwa keluar-masuk yang kompleks, baseline dan Konteks sebagai Memori menunjukkan distorsi subjek yang parah dan inkonsistensi gerakan. DFoT gagal mempertahankan integritas subjek, menyebabkan subjek menghilang sepenuhnya. Sementara WorldPlay berhasil mempertahankan konsistensi penampilan subjek, itu menderita gerakan yang terputus-putus dan tindakan yang tidak alami.
‘Sebaliknya, metode kami berhasil mempertahankan konsistensi hibrida, mempertahankan baik identitas subjek dan kohesi gerakan setelah subjek kembali ke bingkai.’
Hasil lebih lanjut dapat dilihat dalam format video di situs pelengkap, di mana empat contoh pertama telah dirangkai (oleh kami) ke dalam video di bawah:
Klik untuk memutar. Empat dari enam hasil tes yang ditampilkan di situs proyek. Sumber
Kesimpulan
Sementara setiap upaya untuk mengatasi salah satu masalah terbesar dalam generasi video AI patut disambut, tampaknya tidak dapat dihindari bagi saya bahwa solusi optimal untuk masalah keluar/masuk dari jenis ini akan terbukti, seperti halnya CGI, dalam bentuk referensi yang terpisah yang dapat diedit dan dibawa ke dalam ruang komposisi.
Upaya untuk menjaga embedding tetap hidup dengan cara ad hoc dan langsung saat proses berlangsung ini tampaknya melelahkan, dan juga tidak menawarkan cara yang jelas untuk konsistensi di dalam satu pengambilan gambar yang sekarang ditawarkan di berbagai portal black-box seperti Runway. Jika ternyata pengambilan gambar berikutnya akan memerlukan akses ke ruang laten pengambilan gambar sebelumnya, mengapa tidak memiliki kedua instance menempatkan embedding karakter yang tersendiri dan terpisah?
* Tidak ada yang lain yang telah menamainya, dan diskusi sulit tanpa istilah umum.
** Saat ini dilaporkan sebagai ‘akan segera hadir’, di halaman proyek.
Dipublikasikan pertama kali pada hari Jumat, 27 Maret 2026


