
Model dan platform AI
Dataset OTS (Off-the-Shelf) Baru dari Appen Percepat Penerapan AI

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
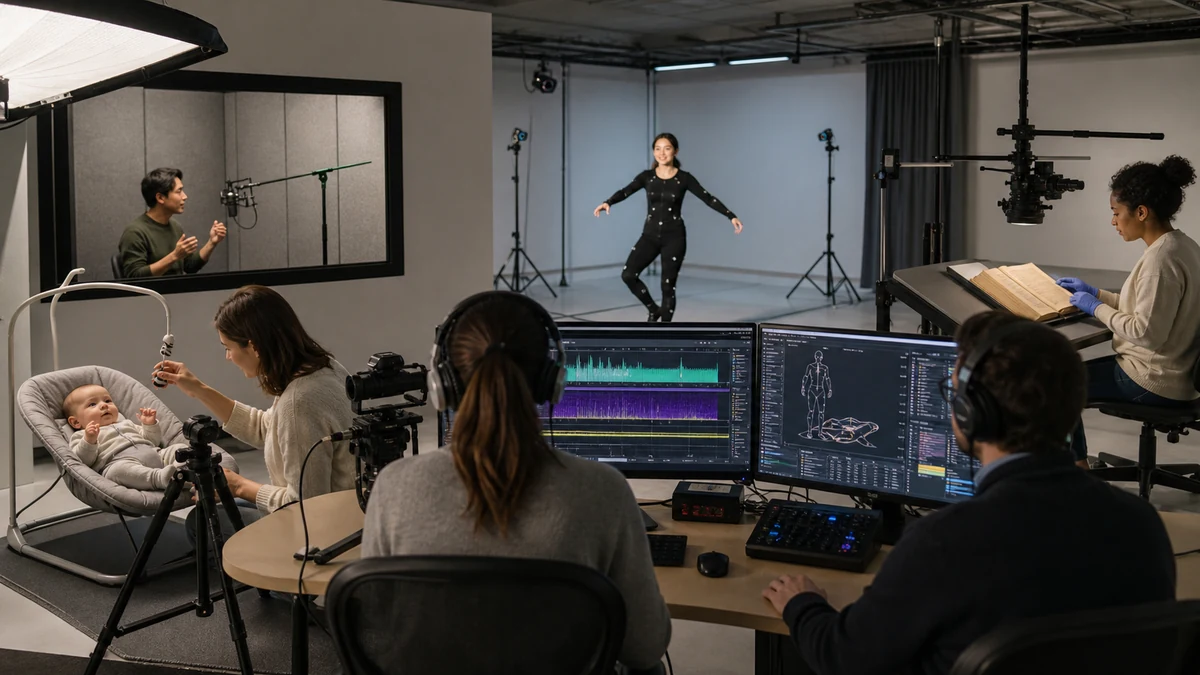
Appen Limited (ASX:APX), penyedia utama data pelatihan berkualitas tinggi untuk organisasi yang membangun sistem AI yang efektif dalam skala besar, hari ini mengumumkan dataset OTS (Off-the-Shelf) baru. Dataset ini dirancang untuk membuat bisnis lebih mudah dan cepat dalam memperoleh data pelatihan berkualitas tinggi yang dibutuhkan untuk mempercepat proyek AI dan pembelajaran mesin (ML) mereka. Dataset OTS baru ini mencakup gerakan tubuh manusia dan suara tangisan bayi inovatif, serta ucapan yang disusun dan gambar dengan teks yang sesuai untuk pengenalan karakter optik (OCR) untuk bahasa yang sulit diperoleh, seperti Arab, Kroasia, Yunani, Hongaria, Thai, dan lain-lain. Dengan dataset yang diperluas, penawaran OTS total Appen mencakup lebih dari 250 dataset, yang terdiri dari lebih dari 11.000 jam audio, lebih dari 25.000 gambar, dan lebih dari 8,7 juta kata dalam 80 bahasa dan dialek yang berbeda.
Dataset OTS Appen adalah alat yang cepat dan efektif biaya untuk memulai proyek AI atau ML dengan data pelatihan berkualitas tinggi yang konsisten. Tim yang memperluas kemampuan AI mereka juga dapat menggunakan dataset OTS untuk secara efektif meningkatkan akurasi, mengembangkan keterampilan model baru, dan mengincorporasi perbaikan lainnya ke dalam model AI mereka. Dataset OTS biasanya disampaikan dalam waktu satu minggu, misalnya, dibandingkan dengan delapan hingga dua belas minggu untuk proyek pengumpulan dan anotasi dataset baru – atau bahkan lebih lama, tergantung pada kompleksitas. Semua dataset Appen dikembangkan menggunakan metode yang sepenuhnya transparan dan opt-in, sehingga spesialis AI dapat yakin bahwa data mereka bersih dan patuh, menghilangkan risiko potensial backlash dan kerusakan reputasi.
“Tim AI di seluruh dunia yang bekerja pada proyek dengan tenggat waktu yang ketat dan persyaratan data yang fleksibel dapat memanfaatkan dataset OTS,” kata Wilson Pang, CTO Appen. “Dataset OTS mempersingkat waktu untuk mendapatkan nilai dan memberikan akses ke data berkualitas tinggi dengan biaya total yang lebih rendah daripada menggunakan metode tradisional. Kami di Appen mengambil langkah-langkah yang diperlukan untuk memastikan bahwa semua dataset kami bersumber etis dan seimbang secara demografis, memungkinkan perusahaan untuk mempertahankan praktik AI yang bertanggung jawab dengan meminimalkan bias dalam model mereka dan memastikan perlakuan yang adil terhadap pengannotasi data. Anda selalu tahu kualitas pasti dari dataset OTS, yang membantu membangun AI yang lebih baik dan berfungsi di dunia nyata.”
MediaInterface telah menyampaikan solusi teknologi bahasa kepada lembaga kesehatan di Jerman dan bagian lain Eropa selama lebih dari 20 tahun. Ketika perusahaan tersebut memperluas ke Prancis, mereka memiliki perangkat lunak yang sepenuhnya dilokalisasi tetapi kekurangan data leksikon bahasa Prancis, terutama nama dan tempat di Prancis, yang sering dirujuk dalam informasi kesehatan pasien. Dengan menggunakan dataset OTS Appen, MediaInterface memperoleh sekitar 21.000 nama Prancis dan 14.000 nama tempat. “Data kritis dari Appen telah diintegrasikan ke dalam leksikon latar belakang kami untuk meluncurkan dengan sukses di pasar baru, dan ini membantu kami membangun kosakata baru untuk klien kami dan memperkuat pendekatan kami untuk peluncuran pasar di masa depan,” kata Ines Wendler, manajer produk di MediaInterface.
Para ahli AI yang paling berpengalaman menggabungkan dataset OTS dengan proyek pengumpulan dan anotasi data on-demand untuk memenuhi kebutuhan data pelatihan model AI yang kompleks. Appen adalah pemimpin dalam menawarkan dukungan terus-menerus melalui berbagai layanan pengumpulan data khusus, seperti anotasi data berkelanjutan dan pelabelan pintar, melalui alat dan alur kerja yang ditenagai AI untuk memaksimalkan efisiensi.
“Kami berinteraksi dengan AI dari saat kita bangun tidur hingga saat kita tidur – melalui asisten virtual, chatbot, mesin pencari, jaringan sosial, perangkat medis, mobil pintar, dan aplikasi lainnya,” kata Judith Bishop, direktur senior spesialis AI di Appen, yang memimpin tim 100 ahli linguistik AI dan ahli bahasa. “Bahasa sering kali merupakan antarmuka utama untuk banyak kasus penggunaan AI yang menarik, sehingga untuk memastikan pengalaman yang luar biasa, model harus dilatih untuk bekerja untuk semua orang. Komitmen Appen terhadap data berkualitas tinggi dan pengembangan AI yang bertanggung jawab dan etis memungkinkan perusahaan yang membeli dataset OTS kami untuk mempercepat proyek AI mereka dengan kepercayaan penuh dalam data mereka.”
Bergabung dengan ratusan dataset yang sudah ada di appen.com, daftar dataset OTS Appen baru yang sekarang tersedia mencakup:
- Ucapan yang disusun untuk Arab (Mesir), Arab (Arab Saudi), Arab (Uni Emirat Arab), Khmer Tengah (Kamboja), Kroasia, Yunani, Hongaria, Polandia, Spanyol (Spanyol), dan Turki
- OCR gambar untuk teks Cina Sederhana, teks Thai, dan teks Finlandia – Termasuk billboard, kemasan luar, tanda, majalah, dan menu yang direkam sebelumnya untuk melatih dan memperbarui model OCR penglihatan komputer
- Gerakan tubuh manusia (Cina) – Termasuk video yang diannotasi dari orang bergerak, dilacak pada tingkat piksel, sesuai untuk pengembangan game, aplikasi kebugaran, dan lain-lain
- Suara tangisan bayi (Cina) – Termasuk suara bayi yang direkam sebelumnya dan diannotasi yang dapat digunakan untuk melatih model AI untuk mengenali suara tangisan yang berbeda dan memberi tahu orang tua
Untuk informasi lebih lanjut dan untuk meminta sampel dataset OTS Appen, klik di sini.


