Model dan platform AI
Apa Itu Hukum Moore, dan Bagaimana Pengaruhnya Terhadap AI?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Hukum Moore adalah pengamatan historis bahwa sirkuit terintegrasi yang berguna secara ekonomi cenderung menambah komponen secara eksponensial. Itu bukan hukum fisika dan tidak menyatakan bahwa komputer secara otomatis menjadi dua kali lebih cepat pada jadwal yang tetap.
Untuk AI, kepadatan transistor penting karena memungkinkan lebih banyak unit aritmetika, memori, dan interkoneksi. Namun kemajuan praktis juga bergantung pada arsitektur, presisi numerik, kemasan, lebar pita memori, algoritma, perangkat lunak, energi, hasil produksi, dan jumlah data yang berguna.
Poin utama
- Artikel asli Moore tahun 1965 menggambarkan tren ekonomi dan teknik, bukan jaminan fisik.
- Skala kecepatan clock melambat; keuntungan modern semakin banyak berasal dari paralelisme dan akselerator khusus.
- Kinerja AI sering dibatasi oleh pergerakan memori dan energi, bukan hanya aritmetika.
- Bandingkan sistem dengan latensi, throughput, kualitas, daya, dan total biaya pada tingkat beban kerja — bukan jumlah transistor.
Apa yang sebenarnya diamati Moore
Gordon Moore memplot jumlah komponen pada sirkuit terintegrasi terkemuka dan memperkirakan pertumbuhan cepat yang berkelanjutan dengan biaya minimum per komponen. Irama ini kemudian biasanya diringkas sebagai penggandaan kira-kira setiap dua tahun, namun formulasi dan kuantitas yang diukur beragam.
Fitur yang lebih kecil dapat meningkatkan kepadatan dan mengurangi beberapa biaya switching, namun kompleksitas manufaktur dan ekonomi menentukan apakah tren tersebut tetap berguna. Nama node adalah label pemasaran, sehingga tidak boleh diperlakukan sebagai perbandingan fisik langsung antar pabrik.
Dari inti yang lebih cepat ke komputasi heterogen
Skala tegangan gaya Dennard dulu memungkinkan tingkat clock yang lebih tinggi tanpa pertumbuhan daya yang proporsional, namun hubungan itu melemah. Perancang beralih ke CPU multicore, GPU, unit tensor, chiplet, kemasan canggih, dan akselerator khusus domain.
Heterogenitas itu menjadi inti deep learning. Operasi matriks padat dapat dijalankan secara efisien pada perangkat keras paralel, sementara CPU mengoordinasikan logika tidak teratur dan pergerakan data. Komponen tercepat tidak membantu bila jalur proses tidak dapat memasoknya.
Memori, presisi, dan algoritma
Pelatihan dan inferensi berulang kali memindahkan bobot, aktivasi, dan data cache melalui hierarki memori di dalam chip dan di luar chip. Lebar pita, kapasitas, lokalitas, dan komunikasi dapat mendominasi biaya. Presisi numerik yang lebih rendah dan kuantisasi mengurangi pergerakan bila kualitas tetap dapat diterima.
Peningkatan algoritmik dapat menurunkan komputasi yang diperlukan untuk mencapai hasil target. Model spars, metode efisiensi transformer, optimizer yang lebih baik, dan data berkualitas tinggi semuanya memengaruhi kemajuan efektif yang dirasakan pengguna.
Cara membandingkan perangkat keras AI
Operasi puncak per detik bersifat teoretis. Gunakan model representatif, ukuran batch, panjang urutan, presisi, tumpukan perangkat lunak, dan ambang kualitas. Laporkan latensi ujung‑ke‑ujung, throughput, energi, jejak memori, pemanfaatan, dan biaya.
Sistem edge mungkin lebih menghargai privasi dan daya rendah dibandingkan throughput maksimum; pusat data mungkin memprioritaskan total token atau sampel per watt. Edge AI menjelaskan mengapa satu angka utama tidak dapat menggambarkan setiap sistem yang berguna.
Mengapa skala semikonduktor berubah
Kemajuan sirkuit terintegrasi awal menggabungkan perangkat yang lebih kecil, manufaktur yang lebih baik, biaya per komponen yang lebih rendah, dan perbaikan desain. Selama bertahun‑tahun, pengurangan dimensi transistor juga mendukung switching yang lebih cepat dan energi per operasi yang lebih rendah. Pada akhirnya, kebocoran, batas tegangan, kepadatan panas, penundaan interkoneksi, dan biaya fabrikasi melemahkan hubungan sederhana antara node proses baru dan inti tujuan umum yang lebih cepat.
Kemajuan modern karenanya multidimensional. Perangkat FinFET dan gate‑all‑around meningkatkan kontrol elektrostatis; litografi ekstrem‑ultraviolet mendukung pola yang lebih kecil; chiplet memungkinkan perancang menggabungkan die yang dibuat dengan proses berbeda; kemasan canggih menempatkan komputasi dan memori lebih dekat. Hasil produksi dan kemasan menentukan apakah desain yang secara teknis mengesankan menjadi ekonomis pada volume besar.
Pelambatan satu mekanisme skala tidak berarti perangkat keras berhenti berkembang. Itu berarti arsitek harus menggunakan transistor dengan lebih sengaja. Unit khusus menukar fleksibilitas untuk throughput atau efisiensi pada beban kerja tertentu, sementara cache dan interkoneksi yang lebih besar berupaya menjaga unit tersebut tetap terpasok.
Bagaimana beban kerja AI menekan perangkat keras
Pelatihan bergantian antara komputasi maju, backpropagation, pembaruan optimizer, dan komunikasi antar akselerator. Inferensi berkisar dari penilaian batch hingga generasi token interaktif. Perkalian matriks penting, namun embedding, normalisasi, fungsi aktivasi, perhatian, routing, akses cache, dan orkestrasi host semuanya berkontribusi pada kinerja nyata.
Intensitas aritmetika — jumlah komputasi yang dilakukan per byte yang dipindahkan — membantu menjelaskan apakah beban kerja terikat pada komputasi atau lebar pita. Ukuran batch kecil dan dekoding autoregresif sering membuat unit aritmetika kurang terpakai karena bobot atau data cache harus diambil berulang kali. Batch yang lebih besar meningkatkan pemanfaatan tetapi menambah latensi dan memori.
Format numerik mengubah pertukaran. FP32, BF16, FP16, FP8, dan format integer berbeda dalam rentang, presisi, dukungan perangkat keras, dan kesalahan. Pelatihan campuran‑presisi mempertahankan operasi sensitif pada presisi lebih tinggi; inferensi terkuantisasi memerlukan kalibrasi dan pengujian kualitas daripada janji bahwa setiap model dapat menoleransi lebar bit yang sama.
Ekonomi sistem dan arah masa depan
Total biaya AI mencakup pembelian atau penyewaan akselerator, penyediaan daya, pendinginan, jaringan, penyimpanan, rekayasa perangkat lunak, kapasitas menganggur, dan eksperimen yang gagal. Chip yang lebih cepat dapat menambah total biaya jika pemanfaatan rendah atau jika model memerlukan topologi terdistribusi yang mahal. Ukur output yang berguna pada ambang kualitas yang ditetapkan.
Skala juga dibatasi oleh data dan algoritma. Lebih banyak komputasi tidak dapat memperbaiki data yang salah label atau evaluasi yang memberi penghargaan pada jalan pintas. Perhatian yang efisien, optimizer yang lebih baik, sparsitas, retrieval, distilasi, dan penemuan algoritmik dapat meningkatkan hasil tanpa peningkatan perangkat keras yang proporsional, meskipun dapat mengalihkan biaya ke tempat lain.
Sistem masa depan akan menggabungkan kemajuan proses dengan penumpukan tiga dimensi, memori ber‑lebar pita tinggi, interkoneksi optik atau listrik canggih, aliran data khusus domain, dan perangkat lunak yang dirancang bersama. Hukum Moore tetap menjadi konteks historis yang berharga, namun perencanaan harus menggunakan kurva beban kerja yang terukur serta kendala pasokan, energi, dan penerapan yang realistis.
Membaca Hukum Moore dengan benar dalam desain sistem AI
Analisis yang berguna memisahkan kepadatan transistor, kinerja CPU tujuan umum, throughput akselerator, kapasitas memori, lebar pita memori, interkoneksi, energi, hasil produksi, dan biaya. Semua ini tidak meningkat pada tingkat yang sama. Beban kerja AI yang didominasi oleh pergerakan bobot model mungkin memperoleh sedikit manfaat dari lebih banyak unit aritmetika, sementara model kecil di dalam chip dapat sangat diuntungkan oleh perangkat keras khusus berpresisi rendah. Sebutkan metrik, presisi, beban kerja, dan batas daya yang tepat daripada memperlakukan node proses sebagai kinerja.
Skala model AI juga mengubah permintaan perangkat lunak dan sistem. Pelatihan yang lebih besar membutuhkan algoritma paralel, checkpoint yang dapat diandalkan, jaringan berkecepatan tinggi, jalur penyimpanan, dan data yang cukup untuk memanfaatkan kapasitas tambahan. Pada inferensi, latensi bergantung pada panjang prompt, token yang dihasilkan, batching, memori cache, dan tujuan tingkat layanan. Peningkatan algoritmik, sparsitas, kuantisasi, retrieval, dan data yang lebih baik dapat memberikan keuntungan yang independen dari tren transistor dan kadang melampaui generasi perangkat keras.
Untuk perencanaan, lakukan benchmark model representatif pada sistem kandidat dan model total biaya selama siklus penggunaan: akuisisi atau harga cloud, daya, pendinginan, pemanfaatan, rekayasa, migrasi, dan risiko pasokan. Gunakan skenario daripada satu perkiraan eksponensial. Hukum Moore tetap menjadi pengamatan historis yang berharga tentang ekonomi integrasi, namun tidak menjamin AI menjadi secara proporsional lebih cepat, lebih murah, lebih mampu, atau lebih berkelanjutan pada jadwal tetap.
Daftar periksa implementasi praktis
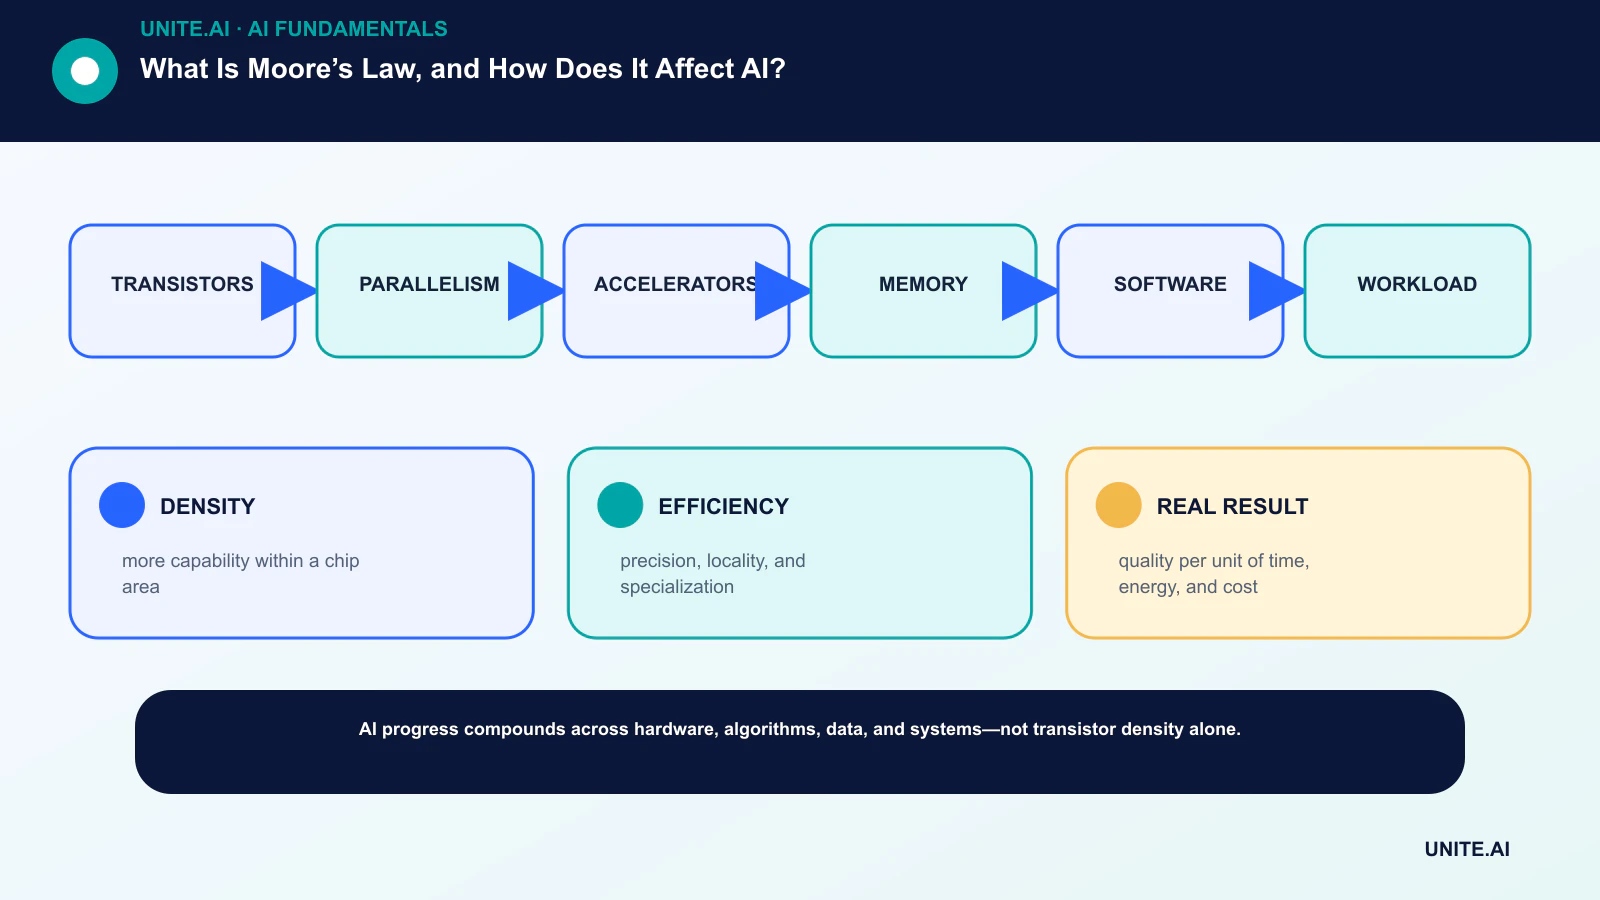
Ubah konsep menjadi alur kerja terbatas yang dapat diuji: transistor → paralelisme → akselerator → memori → perangkat lunak → beban kerja. Tunjuk pemilik yang bertanggung jawab, dokumentasikan data dan ketergantungan, tetapkan baseline sederhana, tetapkan kriteria penerimaan dan penghentian, uji kegagalan representatif, dan definisikan pemantauan, rollback, serta tinjauan sebelum memperluas ruang lingkup. Catat versi dan asumsi sehingga tim lain dapat mereproduksi hasil dan memahami apa yang berubah.
Sebelum peluncuran, lakukan tinjauan kesiapan yang terdokumentasi dengan orang‑orang yang membangun, mengoperasikan, mengamankan, dan terpengaruh oleh sistem. Uji kasus normal, kondisi batas, kegagalan ketergantungan, dan penyalahgunaan; simpan bukti dan risiko yang belum terselesaikan. Tentukan siapa yang dapat menyetujui rilis, mengubah ambang, mengganti output, atau menghentikan operasi. Tinjau kembali keputusan setelah data dunia nyata tersedia, karena pilot yang secara teknis berhasil tidak menjamin kinerja yang dapat diandalkan pada skala yang lebih luas.
- DENSITY: lebih banyak kemampuan dalam area chip.
- EFFICIENCY: presisi, lokalitas, dan spesialisasi.
- REAL RESULT: kualitas per satuan waktu, energi, dan biaya.
Pertanyaan yang sering diajukan
Apakah Hukum Moore sudah berakhir?
Tren historis sederhana telah melambat dan berubah karakter, namun kemajuan semikonduktor terus berlanjut melalui perangkat, arsitektur, kemasan, memori, dan perangkat lunak. Apakah istilah tersebut masih tepat tergantung pada metrik yang digunakan.
Apakah dua kali lebih banyak transistor berarti dua kali lipat kinerja AI?
Tidak. Kinerja bergantung pada cara transistor digunakan serta pada lebar pita, presisi, struktur model, efisiensi perangkat lunak, daya, dan kendala beban kerja.
Referensi utama