
Sudut Anderson
GAN sebagai Renderer Wajah untuk ‘CGI Tradisional’

 Tambahkan Unite.AI ke sumber pilihan Anda di Google

Poin utamaMemisahkan identitas dari ekspresi dalam ruang laten GAN masih menjadi tantangan utama…
Lihat selengkapnya
- Memisahkan identitas dari ekspresi dalam ruang laten GAN masih menjadi tantangan utama yang belum terpecahkan untuk sintesis video wajah.
- Model CGI parametrik seperti SMPL dan 3DMM semakin banyak digunakan untuk menertibkan kode laten GAN yang sulit diatur.
- Pendekatan hibrida Rendering with Style dari Disney menghasilkan hasil yang tidak wajar dengan menggabungkan peta tekstur tradisional dengan citra yang dihasilkan GAN.
Opini Ketika Jaringan Adversarial Generatif (GAN) pertama kali menunjukkan kemampuan mereka untuk mereproduksi wajah 3D yang sangat realistis, hal itu memicu demam emas untuk potensi GAN yang belum dimanfaatkan dalam menciptakan video yang konsisten secara temporal dengan wajah manusia.
Di suatu tempat di ruang laten GAN, tampaknya pasti ada keteraturan dan rasionalitas tersembunyi – skema logika semantik yang mulai terbentuk dan tersembunyi dalam kode laten, yang memungkinkan GAN untuk menghasilkan tampilan yang konsisten dan interpretasi yang berbeda (seperti perubahan ekspresi) dari wajah yang sama – dan kemudian menawarkan metode video deepfake yang secara temporal meyakinkan yang akan mengalahkan autoencoder.
Output resolusi tinggi akan menjadi hal yang sepele dibandingkan dengan lingkungan resolusi rendah yang dipaksa oleh keterbatasan GPU yang memaksa DeepFaceLab dan FaceSwap untuk beroperasi, sementara ‘zona pertukaran’ wajah (dalam alur kerja autoencoder) akan menjadi ‘zona pembuatan’ GAN, yang diberitahu oleh sejumlah kecil gambar input, atau bahkan hanya satu gambar.
Tidak akan ada lagi ketidakcocokan antara wajah ‘pertukaran’ dan ‘tuan rumah’, karena keseluruhan gambar akan dihasilkan dari awal, termasuk rambut, garis rahang, dan bagian terluar dari garis wajah, yang sering kali terbukti menjadi tantangan bagi ‘deepfake tradisional’ autoencoder.
Musim Dingin Video Wajah GAN
Namun, ternyata itu tidak akan semudah itu. Pada akhirnya, disentanglement terbukti menjadi masalah utama, dan tetap menjadi tantangan utama. Bagaimana Anda dapat mempertahankan identitas wajah yang berbeda, dan mengubah pose atau ekspresi tanpa mengumpulkan korpus ribuan gambar referensi yang mengajarkan jaringan saraf apa yang terjadi ketika perubahan tersebut dilakukan, seperti yang dilakukan oleh sistem autoencoder?
Pemikiran selanjutnya dalam penelitian sintesis dan enaktif wajah GAN adalah bahwa identitas input dapat dibuat subjek untuk transformasi berorientasi tujuan, generik, dan berbasis templat yang tidak spesifik terhadap identitas. Contoh dari ini adalah menerapkan ekspresi pada wajah GAN yang tidak hadir dalam gambar orang tersebut yang GAN kenal.

Dari makalah 2022 Tensor-based Emotion Editing in the StyleGAN Latent Space, ekspresi templat diterapkan pada wajah input dari dataset FFHQ. Sumber: https://arxiv.org/pdf/2205.06102.pdf
Jelas bahwa pendekatan ‘satu ukuran untuk semua’ tidak dapat menutupi keragaman ekspresi wajah unik bagi individu. Kita harus bertanya-tanya apakah senyum yang unik seperti yang dimiliki Jack Nicholson atau Willem Dafoe dapat pernah menerima interpretasi yang setia di bawah pengaruh kode laten ‘rata-rata ekspresi’ seperti itu.

Siapa pria asing Latin yang menarik ini? Meskipun metode GAN menghasilkan wajah yang lebih ‘realistis’ dan resolusi lebih tinggi, transformasi tidak diberitahu oleh beberapa gambar dunia nyata dari aktor, seperti yang dilakukan oleh DeepFaceLab, yang melatih secara ekstensif pada database ribuan gambar seperti itu, dan akibatnya kesamaan yang dikompromikan. Di sini (latar belakang) model DeepFaceLab diimpor ke DeepFaceLive, implementasi streaming dari perangkat lunak populer dan kontroversial. Contoh dari https://www.youtube.com/watch?v=9tr35y-yQRY (2022) dan https://arxiv.org/pdf/2205.06102.pdf.
Beberapa editor ekspresi wajah GAN telah diajukan selama beberapa tahun terakhir, sebagian besar menangani identitas yang tidak diketahui, di mana kesetiaan transformasi tidak mungkin untuk pembaca biasa untuk mengetahui, karena ini bukan wajah yang familiar.

Identitas yang tidak dikenal diubah dalam penawaran 2020 Cascade-EF-GAN. Sumber: https://arxiv.org/pdf/2003.05905.pdf
Mungkin editor wajah GAN yang paling banyak mendapat perhatian (dan kutipan) dalam tiga tahun terakhir adalah InterFaceGAN, yang dapat melakukan traversal ruang laten dalam kode laten yang terkait dengan pose (sudut kamera/wajah), ekspresi, usia, ras, jenis kelamin, dan kualitas penting lainnya.
Kemampuan ‘morphing’ gaya 1980-an dari InterFaceGAN dan kerangka kerja serupa sebagian besar merupakan cara untuk mengilustrasikan jalur menuju transformasi sebagai gambar diproyeksikan kembali melalui kode laten yang sesuai (seperti ‘usia’). Dalam hal menghasilkan footage video dengan kontinuitas temporal, skema seperti itu sampai sekarang telah memenuhi syarat sebagai ‘bencana yang mengesankan’.
Jika Anda menambahkan kesulitan menciptakan rambut yang konsisten secara temporal, dan fakta bahwa teknik eksplorasi/manipulasi kode laten tidak memiliki pedoman temporal bawaan untuk bekerja dengan (dan sulit untuk mengetahui bagaimana untuk menyuntikkan pedoman tersebut ke dalam kerangka yang dirancang untuk mengakomodasi dan menghasilkan gambar diam, dan yang tidak memiliki penyediaan asli untuk output video), mungkin logis untuk menyimpulkan bahwa GAN bukan Semua yang Anda Butuhkan™ untuk sintesis video wajah.
Oleh karena itu, upaya selanjutnya telah menghasilkan perbaikan inkremental dalam disentanglement, sementara yang lain telah menambahkan konvensi lain dalam visi komputer sebagai ‘lapisan panduan’, seperti penggunaan segmentasi semantik sebagai mekanisme kontrol dalam makalah akhir 2021 paper SemanticStyleGAN: Learning Compositional Generative Priors for Controllable Image Synthesis and Editing.
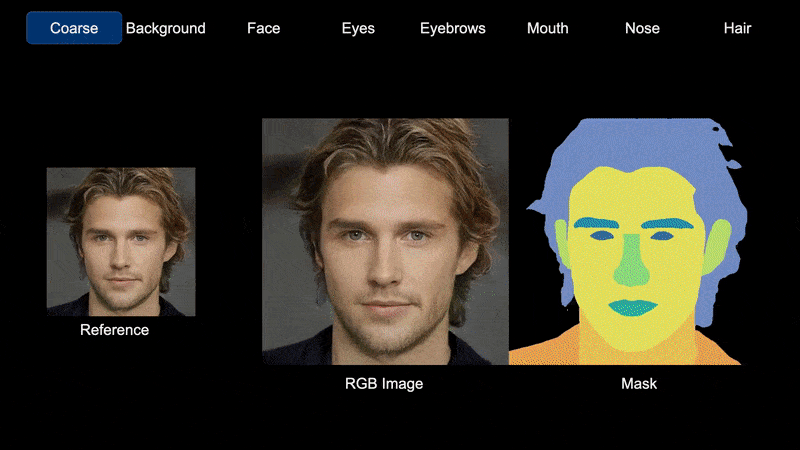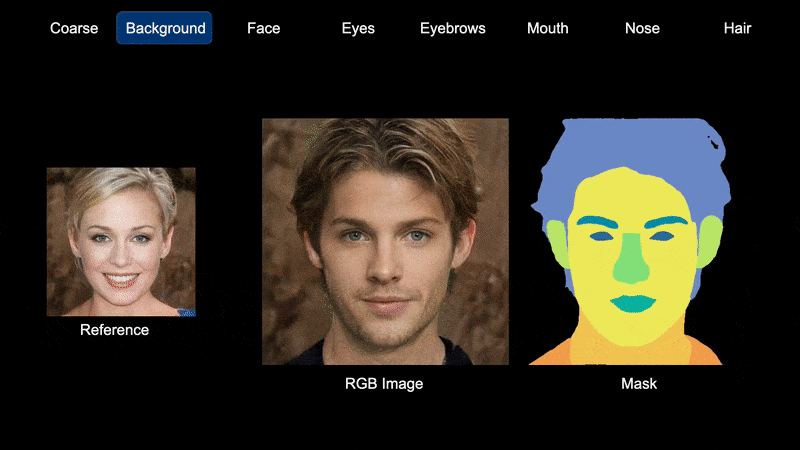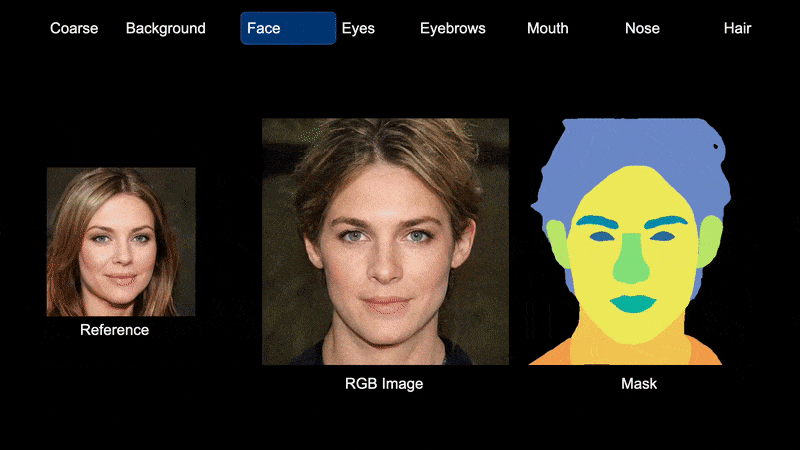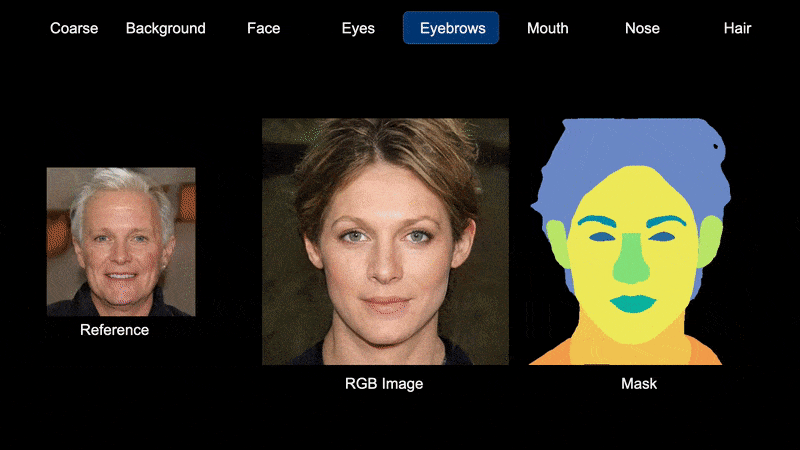
Segmentasi semantik sebagai metode instrumentasi ruang laten di SemanticStyleGAN. Sumber: https://semanticstylegan.github.io/
Panduan Parametrik
Komunitas penelitian sintesis wajah GAN semakin beralih ke penggunaan ‘tradisional’ wajah CGI parametrik sebagai metode untuk memandu dan membawa ketertiban ke kode laten yang mengesankan tetapi tidak teratur di ruang laten GAN.
Walaupun primitif wajah parametrik telah menjadi bagian dari penelitian visi komputer selama lebih dari dua puluh tahun, minat dalam pendekatan ini telah tumbuh belakangan, dengan peningkatan penggunaan primitif CGI Skinned Multi-Person Linear Model (SMPL), pendekatan yang dipelopori oleh Max Planck Institute dan ILM, dan sejak diperbaiki dengan Sparse Trained Articulated Human Body Regressor (STAR) framework.

SMPL (dalam hal ini varian yang disebut SMPL-X) dapat mengimposkan mesh CGI parametrik yang sesuai dengan pose (termasuk ekspresi, jika perlu) dari seluruh tubuh manusia yang ditampilkan dalam gambar, memungkinkan operasi baru untuk dilakukan pada gambar menggunakan mesh parametrik sebagai panduan volumetrik atau perseptual. Sumber: https://arxiv.org/pdf/1904.05866.pdf
Pengembangan paling terkenal dalam garis ini telah menjadi inisiatif Disney 2019 Rendering with Style, yang menggabungkan penggunaan tekstur tradisional dengan gambar GAN yang dihasilkan, dalam upaya untuk menciptakan output animasi yang ditingkatkan, ‘deepfake-gaya’.

Lama bertemu baru, dalam pendekatan hibrida Disney untuk deepfake GAN yang dihasilkan. Sumber: https://www.youtube.com/watch?v=TwpLqTmvqVk
Pendekatan Disney mengimposkan aspek CGI tradisional ke dalam jaringan StyleGAN2 untuk ‘mengisi’ subjek wajah manusia di ‘area masalah’, di mana konsistensi temporal merupakan masalah untuk generasi video – area seperti tekstur kulit.

Alur kerja Rendering with Style.
Karena kepala CGI parametrik yang memandu proses ini dapat disesuaikan dan diubah untuk memenuhi kebutuhan pengguna, wajah GAN yang dihasilkan dapat mencerminkan perubahan tersebut, termasuk perubahan pose dan ekspresi.
Walaupun dirancang untuk menggabungkan kemampuan pengendalian CGI dengan realisme alami wajah GAN, pada akhirnya, hasilnya menunjukkan yang terburuk dari kedua dunia, dan masih gagal untuk menjaga konsistensi tekstur rambut dan bahkan posisi fitur dasar:
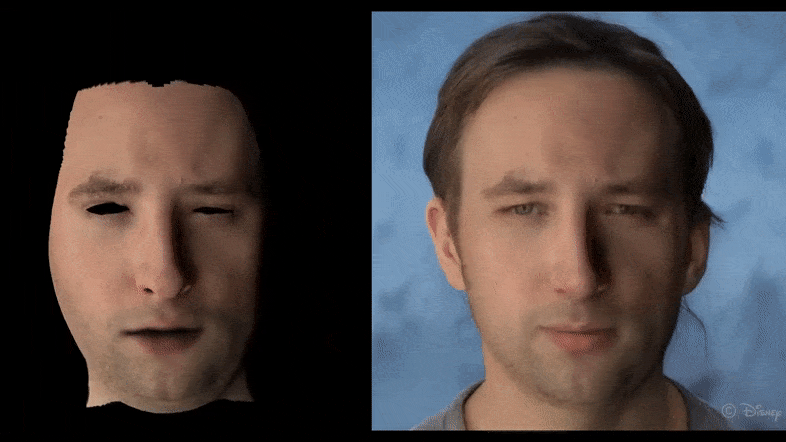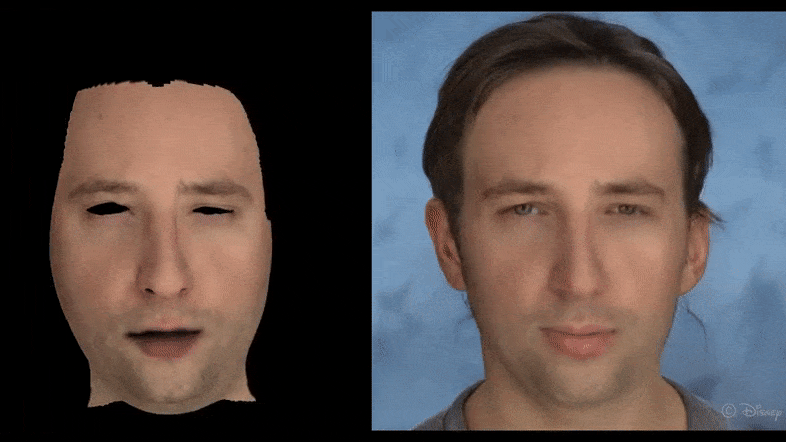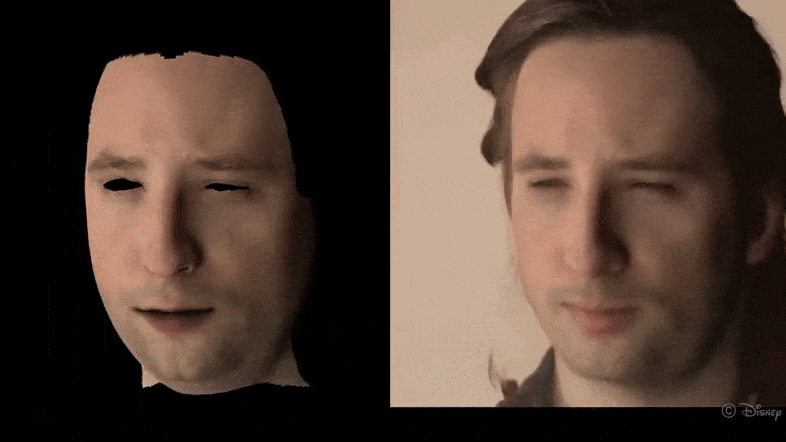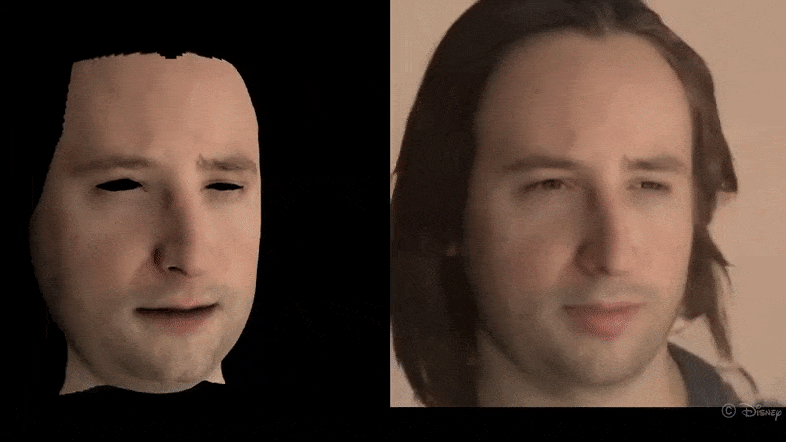
Sebuah lembah yang tidak nyaman muncul dari Rendering with Style, walaupun prinsipnya masih memiliki potensi.
Makalah 2020 paper StyleRig: Rigging StyleGAN untuk Kontrol 3D atas Gambar Potret mengambil pendekatan yang semakin populer, dengan menggunakan model wajah morfabel 3D (3DMM) sebagai proksi untuk mengubah karakteristik dalam lingkungan StyleGAN, dalam hal ini melalui jaringan rigging baru yang disebut RigNet:

3DMM berdiri sebagai proksi untuk interpretasi ruang laten di StyleRig. Sumber: https://arxiv.org/pdf/2004.00121.pdf
Namun, seperti biasa dengan inisiatif ini, hasilnya sampai sekarang tampaknya terbatas pada manipulasi pose minimal, dan perubahan ekspresi/keadaan emosional yang ‘tidak berinformasi’.

StyleRig meningkatkan tingkat kontrol, walaupun rambut yang konsisten secara temporal tetap menjadi tantangan yang belum terpecahkan. Sumber: https://www.youtube.com/watch?v=eaW_P85wQ9k
Output serupa dapat ditemukan dari Mitsubishi Research’s MOST-GAN, makalah 2021 paper yang menggunakan 3DMM nonlinier sebagai arsitektur disentanglement, tetapi juga berjuang untuk mencapai gerakan dinamis dan konsisten.
Penelitian terbaru yang mencoba pengendalian dan pemisahan faktor (disentanglement) adalah One-Shot Face Reenactment on Megapixels, yang lagi-lagi menggunakan kepala 3DMM parametrik sebagai antarmuka yang ramah untuk StyleGAN.

Dalam alur kerja MegaFR dari One-Shot Face Reenactment, jaringan melakukan sintesis wajah dengan menggabungkan gambar dunia nyata yang dipetakan balik ke representasi laten dengan parameter yang diambil dari model 3DMM yang dirender. Sumber: https://arxiv.org/pdf/2205.13368.pdf
OSFR termasuk dalam kelas GAN editor wajah yang tumbuh yang berusaha mengembangkan alur kerja editing linier gaya Photoshop/After Effects, di mana pengguna dapat memasukkan gambar yang diinginkan pada mana transformasi dapat diterapkan, bukan mencari kode laten yang terkait dengan identitas.
Lagi-lagi, ekspresi parametrik mewakili metode non-pribadi untuk menyuntikkan ekspresi, yang mengarah ke manipulasi yang tampak ‘tidak nyaman’ dengan cara yang tidak selalu positif.

Ekspresi yang disuntikkan dalam OSFR.
seperti pekerjaan sebelumnya, OSFR dapat menginfer pose yang mendekati aslinya dari satu gambar, dan juga melakukan ‘frontalization’, di mana gambar wajah dengan pose yang tidak menghadap lurus diubah menjadi foto mugshot:

Asli (atas) dan gambar mugshot yang diinfer dari salah satu implementasi OSFR yang dijelaskan dalam makalah baru.
Dalam prakteknya, jenis inferensi ini mirip dengan beberapa prinsip fotogrametri yang mendasari Neural Radiance Fields (NeRF), kecuali bahwa geometri di sini harus didefinisikan oleh satu foto, bukan 3-4 pandangan yang memungkinkan NeRF untuk menafsirkan pose interstitial yang hilang dan membuat adegan neural 3D yang dapat dijelajahi yang menampilkan manusia.
(Namun, NeRF juga bukan Semua yang Anda Butuhkan™, karena memiliki rangkaian hambatan yang hampir sepenuhnya berbeda dengan GAN dalam hal menghasilkan sintesis video wajah)
Apakah GAN Memiliki Tempat dalam Sintesis Video Wajah?
Mencapai ekspresi dinamis dan pose di luar distribusi pelatihan dari satu gambar sumber tampaknya menjadi obsesi seperti alkimia dalam penelitian sintesis wajah GAN saat ini, terutama karena GAN adalah satu-satunya metode yang saat ini dapat menghasilkan wajah neural yang cukup tinggi resolusi dan relatif tinggi-fidelitas: sementara kerangka deepfake autoencoder dapat melatih pada banyak pose dan ekspresi dunia nyata, mereka harus beroperasi pada resolusi input/output yang terbatas oleh VRAM, dan memerlukan ‘tuan rumah’; sementara NeRF juga terbatas, dan – tidak seperti pendekatan lain – saat ini tidak memiliki metodologi yang mapan untuk mengubah ekspresi wajah, dan menderita keterbatasan kemampuan penyuntingan secara umum.
Tampaknya bahwa satu-satunya cara maju untuk sistem sintesis wajah CGI/GAN yang akurat adalah untuk inisiatif baru untuk menemukan cara untuk merakit entitas identitas multi-foto di dalam ruang laten, di mana kode laten untuk identitas seseorang tidak perlu melakukan perjalanan seluruh ruang laten untuk mengeksploitasi parameter pose yang tidak terkait, tetapi dapat merujuk pada gambar dunia nyata yang terkait sebagai referensi untuk transformasi.
Bahkan dalam kasus seperti itu, atau bahkan jika seluruh jaringan StyleGAN dilatih pada satu set wajah identitas (serupa dengan set pelatihan yang digunakan autoencoder), logika semantik yang kurang masih kemungkinan besar perlu disediakan oleh teknologi pendukung seperti segmentasi semantik atau wajah 3DMM parametrik, yang, dalam skenario seperti itu, setidaknya akan memiliki lebih banyak bahan untuk bekerja dengan.


