Sudut Anderson
Penyuntingan Objek Berbantuan AI dengan Imagic milik Google dan ‘Erase and Replace’ milik Runway

 Tambahkan Unite.AI ke sumber pilihan Anda di Google

Minggu ini dua algoritma grafis berbasis AI yang baru, namun kontras, menawarkan cara baru bagi pengguna akhir untuk melakukan perubahan yang sangat terperinci dan efektif pada objek dalam foto.
Yang pertama adalah Imagic, dari Google Research, bekerja sama dengan Israel Institute of Technology dan Weizmann Institute of Science. Imagic menawarkan penyuntingan objek yang dikondisikan teks dan sangat terperinci melalui fine‑tuning model difusi.

Ubah apa yang Anda suka, dan biarkan sisanya – Imagic menjanjikan penyuntingan terperinci hanya pada bagian yang ingin Anda ubah. Sumber: https://arxiv.org/pdf/2210.09276.pdf
Siapa pun yang pernah mencoba mengubah satu elemen saja dalam render ulang Stable Diffusion pasti sangat menyadari bahwa untuk setiap penyuntingan yang berhasil, sistem akan mengubah lima hal yang Anda sukai persis seperti semula. Ini adalah kelemahan yang saat ini membuat banyak penggemar SD paling berbakat terus bolak‑balik antara Stable Diffusion dan Photoshop untuk memperbaiki ‘kerusakan sampingan’ semacam ini. Dari sudut pandang ini saja, pencapaian Imagic tampak signifikan.
Pada saat penulisan ini, Imagic belum memiliki video promosi sekalipun, dan mengingat sikap hati‑hati Google dalam merilis alat sintesis gambar yang tidak dibatasi, belum jelas sejauh mana, bila ada, kami akan dapat menguji sistem tersebut.
Penawaran kedua adalah fasilitas Erase and Replace milik Runway ML yang lebih mudah diakses, sebuah fitur baru di bagian ‘AI Magic Tools’ dalam rangkaian utilitas efek visual berbasis pembelajaran mesin yang sepenuhnya daring.
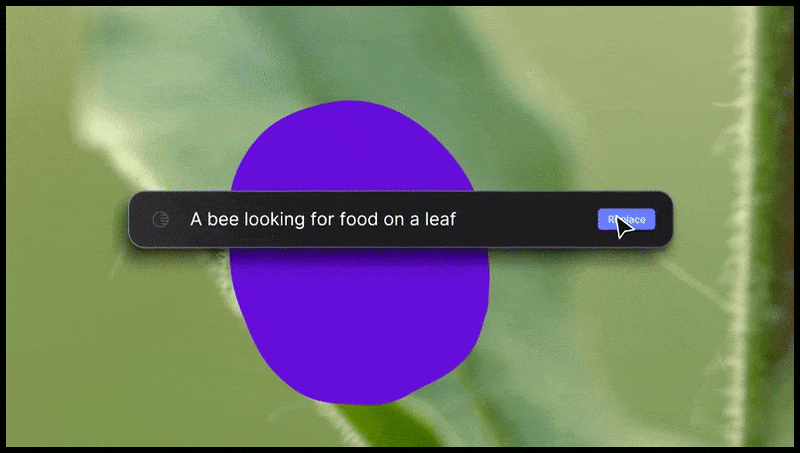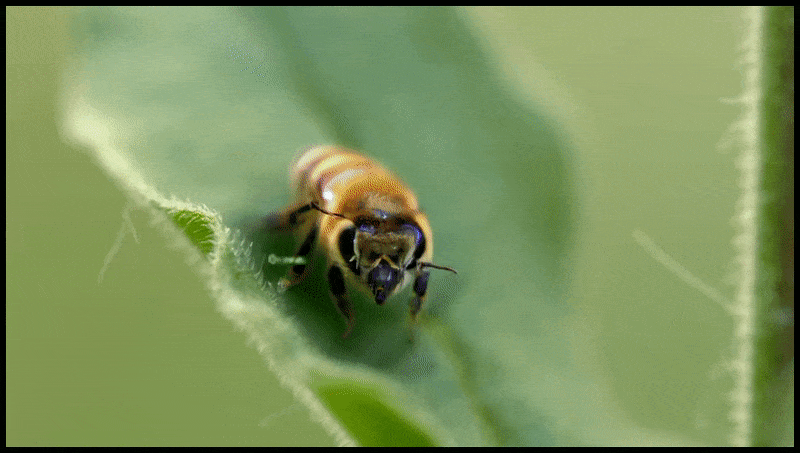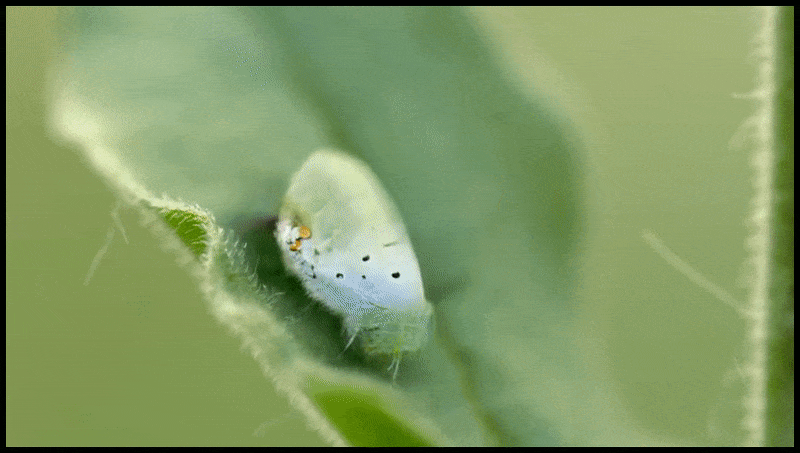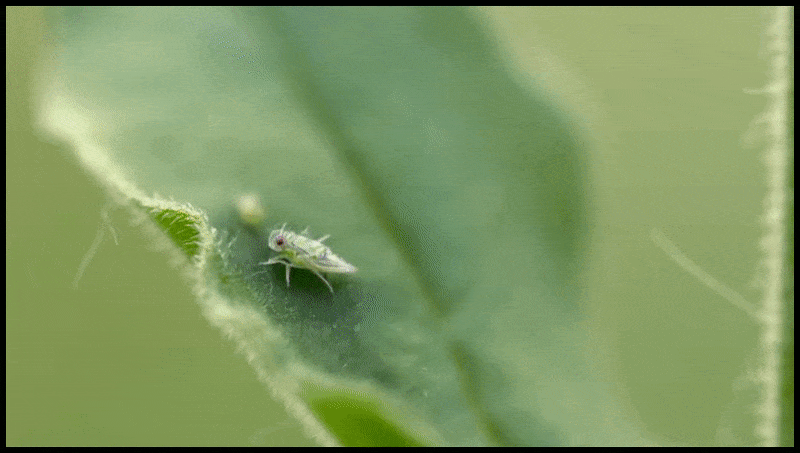
Fitur Erase and Replace milik Runway ML, yang sudah terlihat dalam pratinjau sistem penyuntingan teks‑ke‑video.
Mari kita lihat penawaran Runway terlebih dahulu.
Hapus dan Ganti
Seperti Imagic, Hapus dan Ganti hanya berurusan dengan gambar diam, meskipun Runway telah menunjukkan pratinjau fungsi yang sama dalam solusi penyuntingan teks‑ke‑video yang belum dirilis:
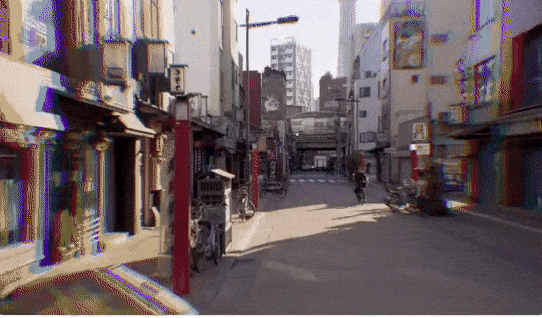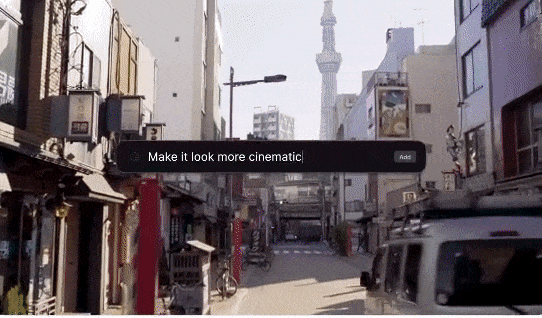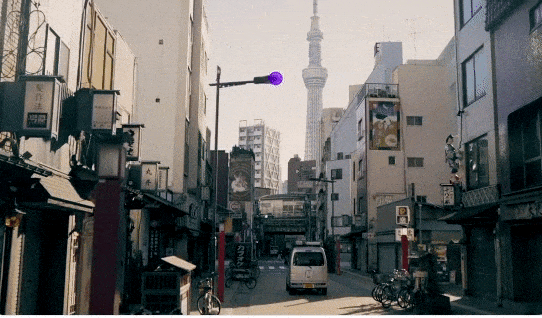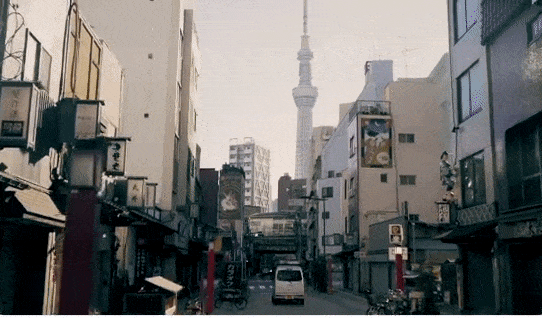
Meskipun siapa pun dapat menguji Erase and Replace yang baru pada gambar, versi video belum tersedia untuk publik. Sumber: https://twitter.com/runwayml/status/1568220303808991232
Meskipun Runway ML belum merilis detail teknologi di balik Hapus dan Ganti, kecepatan Anda dapat menggantikan tanaman hias dengan patung kepala Ronald Reagan yang cukup meyakinkan menunjukkan bahwa model difusi seperti Stable Diffusion (atau, jauh lebih tidak mungkin, DALL‑E 2 berlisensi) adalah mesin yang menciptakan kembali objek pilihan Anda dalam Hapus dan Ganti.

Mengganti tanaman hias dengan patung kepala The Gipper tidak secepat ini, tetapi cukup cepat. Sumber: https://app.runwayml.com/
Sistem ini memiliki beberapa pembatasan tipe DALL‑E 2 – gambar atau teks yang menandai filter Hapus dan Ganti akan memicu peringatan tentang kemungkinan penangguhan akun jika terjadi pelanggaran lebih lanjut – pada dasarnya merupakan salinan standar kebijakan OpenAI yang sedang berjalan untuk DALL‑E 2.
Banyak hasilnya tidak memiliki tepi kasar khas Stable Diffusion. Runway ML merupakan investor dan mitra riset dalam SD, dan mungkin mereka telah melatih model proprietari yang lebih unggul daripada bobot checkpoint sumber terbuka 1.4 yang saat ini kami perjuangkan (seperti banyak kelompok pengembang lain, baik hobi maupun profesional, yang kini melatih atau melakukan fine‑tuning model Stable Diffusion).
Mengganti meja rumah dengan ‘meja terbuat dari es’ dalam Hapus dan Ganti milik Runway ML.
Seperti Imagic (lihat di bawah), Hapus dan Ganti bersifat ‘berorientasi objek’ – Anda tidak dapat sekadar menghapus bagian ‘kosong’ gambar dan mengisinya dengan hasil prompt teks Anda; dalam skenario tersebut, sistem hanya akan melacak objek terdekat yang tampak sepanjang garis pandang masker (seperti dinding atau televisi), dan menerapkan transformasi di sana.
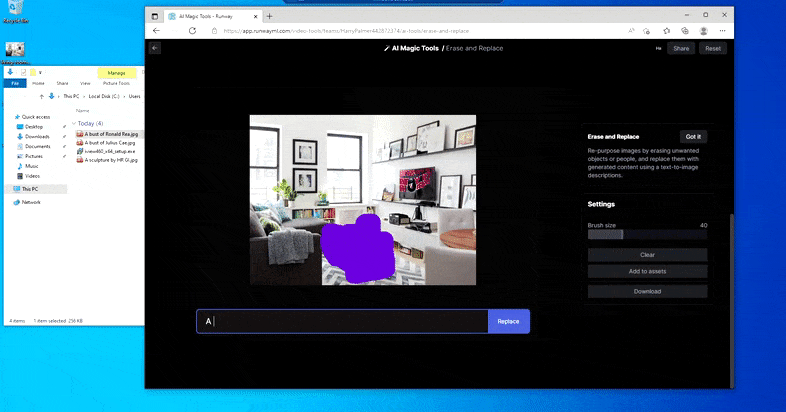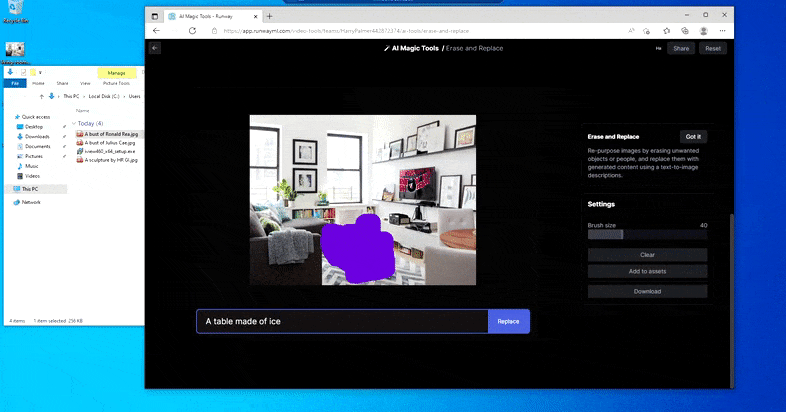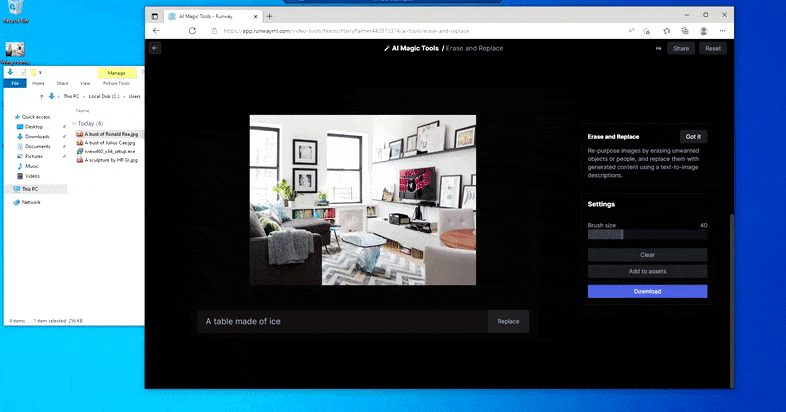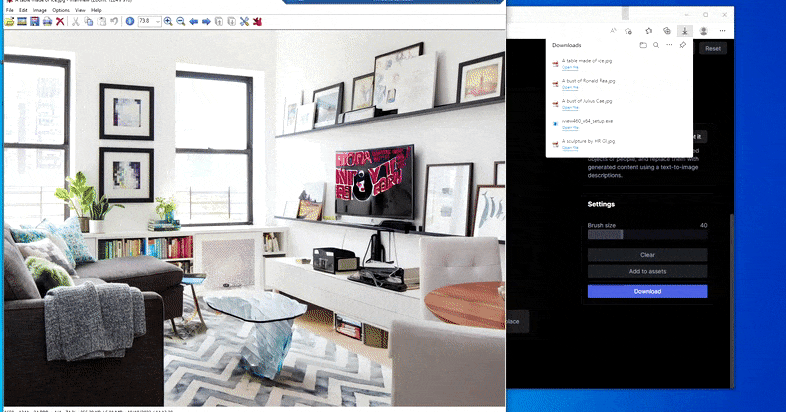
Seperti namanya, Anda tidak dapat menyuntikkan objek ke ruang kosong dalam Hapus dan Ganti. Di sini, upaya memanggil Sith lord paling terkenal menghasilkan mural aneh terkait Vader di TV, kira‑kira di area ‘ganti’ yang digambar.
Sulit untuk menentukan apakah Hapus dan Ganti bersikap mengelak terkait penggunaan gambar berhak cipta (yang masih sebagian besar diblokir, meskipun dengan tingkat keberhasilan yang bervariasi, di DALL‑E 2), atau apakah model yang digunakan dalam mesin rendering backend memang tidak dioptimalkan untuk hal semacam itu.
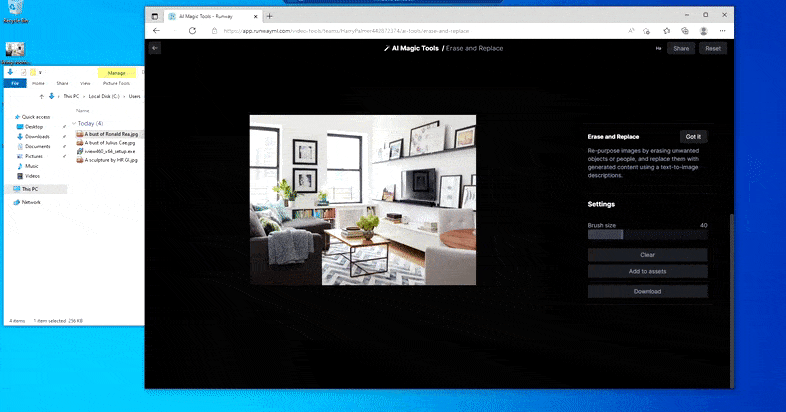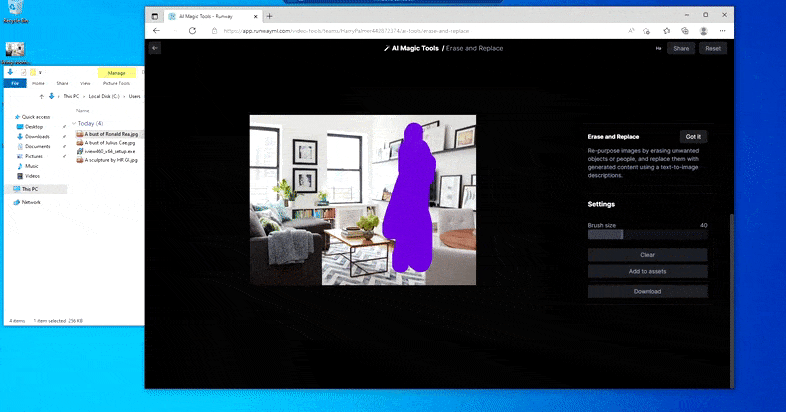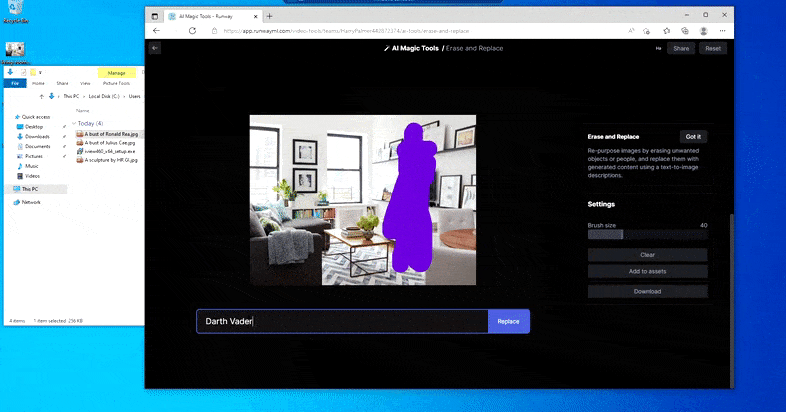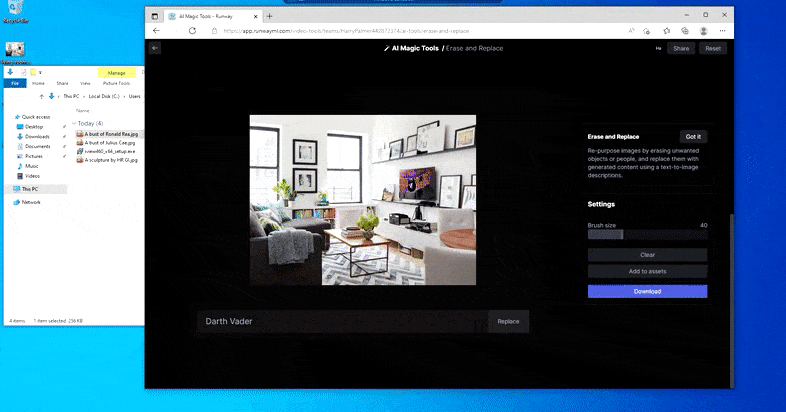
Mural ‘Nicole Kidman’ yang agak NSFW menunjukkan bahwa model berbasis difusi (kemungkinan) ini tidak memiliki penolakan sistematis DALL‑E 2 terhadap rendering wajah realistis atau konten berbau seksual, sementara hasil percobaan menampilkan karya berhak cipta berkisar dari yang ambigu (‘xenomorph’) hingga yang absurd (‘the iron throne’). Di pojok kanan bawah, gambar sumber.
Akan menarik untuk mengetahui metode apa yang digunakan Hapus dan Ganti untuk mengisolasi objek yang dapat digantinya. Kemungkinan gambar diproses melalui turunan CLIP, dengan item terpisah diidentifikasi melalui pengenalan objek dan segmentasi semantik selanjutnya. Tidak ada operasi ini yang bekerja sebaik pada instalasi Stable Diffusion standar.
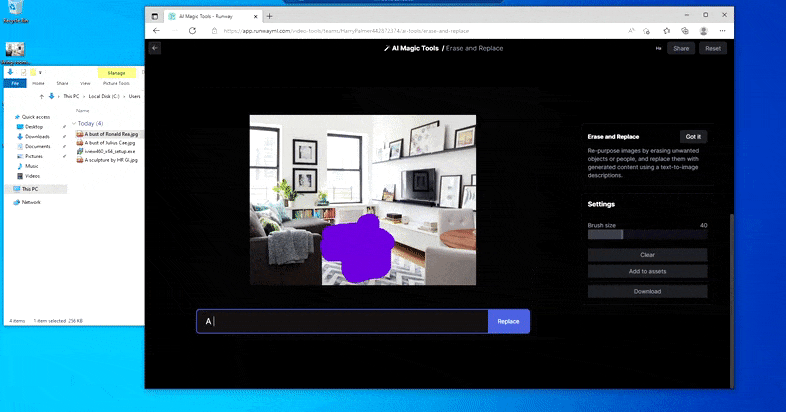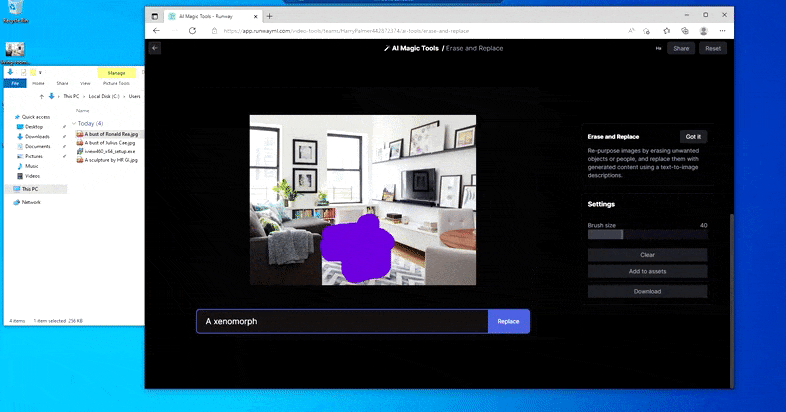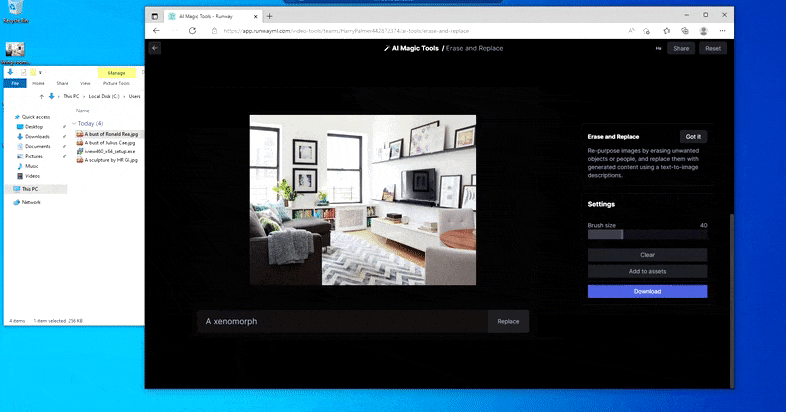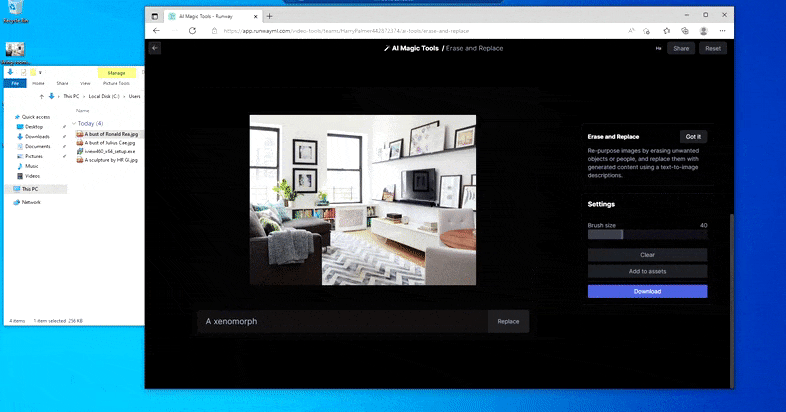
Namun tidak ada yang sempurna – terkadang sistem tampak menghapus tanpa mengganti, bahkan ketika (seperti yang kami lihat pada gambar di atas), mekanisme rendering di baliknya jelas mengerti arti prompt teks. Dalam kasus ini, mustahil mengubah meja kopi menjadi xenomorph – melainkan meja tersebut menghilang.
Iterasi yang lebih menakutkan dari ‘Where’s Waldo’, karena Hapus dan Ganti gagal menghasilkan alien.
Hapus dan Ganti tampaknya merupakan sistem substitusi objek yang efektif, dengan inpainting yang sangat baik. Namun, ia tidak dapat menyunting objek yang sudah ada, melainkan hanya menggantinya. Mengubah konten gambar yang ada tanpa mengorbankan materi sekitar sebenarnya merupakan tugas yang jauh lebih sulit, terkait dengan perjuangan panjang sektor riset visi komputer menuju disentanglement dalam berbagai ruang laten kerangka kerja populer.
Imagic
Itulah tugas yang ditangani Imagic. Makalah baru tersebut menawarkan banyak contoh penyuntingan yang berhasil memperbaiki aspek individual foto sementara membiarkan sisanya tidak berubah.
Dalam Imagic, gambar yang diubah tidak mengalami peregangan, distorsi, dan ‘tebakan penutupan’ khas deepfake puppetry, yang menggunakan prior terbatas yang diambil dari satu gambar.
Sistem ini menggunakan proses tiga tahap – optimasi embedding teks; fine‑tuning model; dan akhirnya, pembuatan gambar yang telah diubah.

Imagic mengkodekan prompt teks target untuk memperoleh embedding teks awal, kemudian mengoptimalkan hasilnya untuk mendapatkan gambar masukan. Setelah itu, model generatif di‑fine‑tune ke gambar sumber, menambahkan berbagai parameter, sebelum dilakukan interpolasi yang diminta.
Tidak mengherankan, kerangka kerja ini didasarkan pada arsitektur teks‑ke‑video Imagen milik Google, meskipun peneliti menyatakan bahwa prinsip sistem ini secara luas dapat diterapkan pada model difusi laten.
Imagen menggunakan arsitektur tiga tingkat, bukan tujuh tingkat yang dipakai untuk iterasi teks‑ke‑video perangkat lunak perusahaan yang lebih baru ini. Tiga modul berbeda tersebut meliputi model difusi generatif yang beroperasi pada resolusi 64×64 px; model super‑resolusi yang meningkatkan output menjadi 256×256 px; dan model super‑resolusi tambahan untuk meningkatkan output hingga resolusi 1024×1024 px.
Imagic terlibat pada tahap paling awal proses ini, mengoptimalkan embedding teks yang diminta pada tahap 64 px menggunakan optimizer Adam dengan laju belajar statis 0,0001.
Kelas master dalam disentanglement: pengguna akhir yang pernah mencoba mengubah sesuatu sesederhana warna objek yang dirender dalam model difusi, GAN, atau NeRF akan mengerti betapa signifikan Imagic dapat melakukan transformasi semacam itu tanpa ‘mengoyak’ konsistensi sisa gambar.
Fine‑tuning kemudian dilakukan pada model dasar Imagen, selama 1500 langkah per gambar masukan, dengan kondisi pada embedding yang telah direvisi. Pada saat yang sama, lapisan sekunder 64 px→256 px dioptimalkan secara paralel pada gambar yang telah dikondisikan. Peneliti mencatat bahwa optimasi serupa untuk lapisan akhir 256 px→1024 px memiliki ‘sedikit atau tidak ada efek’ pada hasil akhir, sehingga tidak diimplementasikan.
Makalah menyatakan bahwa proses optimasi memakan waktu sekitar delapan menit per gambar pada dua chip TPUV4. Render akhir dilakukan di inti Imagen dengan skema sampling DDIM.
Serupa dengan proses fine‑tuning untuk DreamBooth milik Google, embedding yang dihasilkan juga dapat digunakan untuk stylisasi, serta penyuntingan fotorealistik yang memanfaatkan informasi dari basis data yang mendasari Imagen (karena, seperti yang ditunjukkan kolom pertama di bawah, gambar sumber tidak memiliki konten yang diperlukan …).
Gerakan fotorealistik yang fleksibel dan penyuntingan dapat dihasilkan melalui Imagic, sementara kode yang dihasilkan dan disentangled dalam proses tersebut dapat dengan mudah digunakan untuk output bergaya.
Peneliti membandingkan Imagic dengan karya sebelumnya SDEdit, pendekatan berbasis GAN tahun 2021, kolaborasi antara Stanford University dan Carnegie Mellon University; serta Text2Live, kolaborasi April 2022 antara Weizmann Institute of Science dan NVIDIA.
Perbandingan visual antara Imagic, SDEdit, dan Text2Live.
Jelas bahwa pendekatan sebelumnya mengalami kesulitan, namun pada baris paling bawah, yang melibatkan perubahan pose yang besar, para pesaing gagal total merekonstruksi materi sumber, dibandingkan dengan keberhasilan mencolok dari Imagic.
Kebutuhan sumber daya dan waktu pelatihan per gambar Imagic, meskipun singkat menurut standar upaya semacam ini, membuatnya tidak mungkin dimasukkan ke dalam aplikasi penyuntingan gambar lokal di komputer pribadi – dan belum jelas sejauh mana proses fine‑tuning dapat diperkecil ke tingkat konsumen.
Saat ini, Imagic merupakan penawaran yang mengesankan dan lebih cocok untuk API – sebuah lingkungan yang mungkin paling nyaman bagi Google Research, yang berhati‑hati terhadap kritik terkait memfasilitasi deepfake.
Pertama dipublikasikan 18 Oktober 2022.