
Sudut Anderson
Sistem Pembelajaran Mesin untuk Menulis Ulang Artikel Saat Anda Membacanya

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
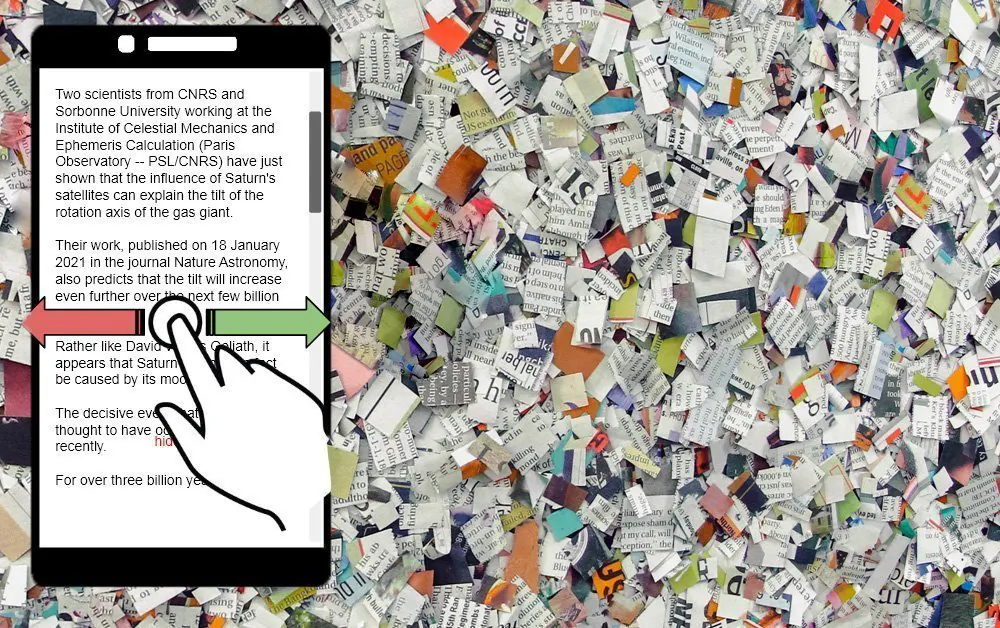
Penelitian baru dari Kanada mengusulkan metode untuk secara otomatis menulis ulang artikel saat Anda membacanya, berdasarkan ‘gesekan’ gaya Tinder, atau pengamatan pasif terhadap interaksi pembaca dengan berbagai jenis konten yang terkandung dalam artikel.
Sistem, yang diberi judul Hone As You Read (HARE), disajikan dalam sebuah makalah dari Western University di Ontario, Kanada, dengan kode Python yang sesuai di GitHub.
Gagasan utama proyek ini adalah bahwa sebuah artikel mungkin berisi berbagai jenis konten, berkembang (seperti ini) dari judul hingga detail lebih lanjut. Bagian akhir artikel mungkin berisi bahan pendukung yang berbeda, contoh penggunaan, atau hipotesis atau dugaan tentang dampak berita.
Dalam HARE, jika Anda tidak menyukai jenis bahan tersebut, Anda dapat memilihnya pada dasar per kalimat sementara sistem belajar preferensi Anda, sehingga ketika Anda menggulirkan ke bawah, konten serupa dengan bahan yang Anda ‘tolak’ telah dihapus atau ditulis ulang. Jika Anda tidak ingin berpartisipasi aktif dalam melatih sistem, HARE dapat menyimpulkan pilihan Anda dengan mengamati interaksi pasif Anda dengan dokumen.
Gesekan Gaya Tinder untuk Kalimat yang Tidak Disukai
Dalam gambar di bawah, kita melihat tiga jenis kategorisasi yang diperkirakan untuk HARE, berdasarkan perilaku eksplisit atau implisit pengguna. Dalam kasus pertama (kiri), pengguna secara aktif ‘menggesek ke kiri’ (atau kanan), dalam gerakan gesekan gaya Tinder yang mengungkapkan persetujuan atau ketidaksetujuan terhadap konten kalimat atau gaya, kompleksitas atau nada.

Sumber: https://arxiv.org/pdf/2105.02923.pdf
Dalam kasus kedua (tengah), sistem menggunakan waktu tinggal sebagai metrik minat pengguna, berdasarkan posisi dan durasi jeda gulir.
Dalam kasus ketiga (kanan), HARE menggunakan kamera smartphone untuk memperkirakan jalur dan waktu tinggal lokasi pandangan pengguna di seluruh paragraf dokumen yang terlihat.
Peneliti menyatakan bahwa waktu tinggal yang lebih lama pada kalimat tertentu dapat menunjukkan minat pengguna yang lebih besar, meskipun secara logis ini mungkin tidak terjadi ketika pengguna mencoba mengasimilasi teks yang mungkin rumit atau hanya ditulis dengan buruk.

Umpan balik pengguna secara efektif mengedit, menulis ulang, atau menghapus sepenuhnya bagian artikel yang belum terlihat.
Pengolahan Konten Sebelumnya ke Preferensi Pengguna
Makalah ini membahas pengalaman pengguna HARE pada dasar per artikel, tetapi jelas interaksi pengguna sebelumnya dengan dokumen memungkinkan penyesuaian pengalaman membaca di masa depan, dengan mengenali konsisten jenis konten dan menerapkan preferensi pengguna yang ditemplatkan ke artikel baru, sehingga kebutuhan interaksi berkurang ketika pengguna melihat lebih sedikit ‘konten yang tidak diinginkan’.
HARE digambarkan sebagai algoritma ringkas, yang memungkinkan konten yang belum terlihat lebih jauh ke bawah halaman untuk ditulis ulang dalam hal gaya atau kepadatan sebelum pengguna tiba di sana; tetapi makalah ini menjelaskan bahwa itu juga dapat menghapus konten sebelumnya berdasarkan umpan balik pengguna.
Untuk tujuan pengujian, sistem menggunakan korpus 11.222 artikel dari surat kabar Daily Mail di Inggris, dan dievaluasi melalui penerapan uji pada aplikasi obrolan Telegram. Artikel dengan kurang dari sepuluh paragraf dihilangkan untuk tujuan uji coba.

Aplikasi Telegram HARE dalam fase uji dengan pengguna.
Metodologi peneliti menggunakan K-Means clustering pada SBERT sematan kalimat dalam artikel, dengan bobot awal acak untuk konsep yang dibahas.
Di antara sejumlah algoritma dan pendekatan, HARE menampilkan tiga model perbandingan, yang pertama (ORACLEGREEDY) memiliki akses ke preferensi pengguna sebelumnya, menunjukkan bahwa algoritma dapat memproses artikel sebelumnya sebelum dimuat, bukan secara interaktif.
Model lainnya, ORACLESORTED dan ORACLEUNIFORM, memilih kalimat berdasarkan tingkat minat atau secara acak di seluruh artikel, masing-masing.
Penghapusan dan Penulisan Ulang Konten
Yang mengejutkan, ORACLEUNIFORM mengungguli himpunan kontrol, meskipun tidak memiliki akses ke minat pengguna sebelumnya. Peneliti menyatakan bahwa ini karena model tersebut menangani artikel secara keseluruhan dalam satu sapuan, ‘hanya memilih kalimat yang paling menarik’. Peneliti mengakui bahwa ini mungkin membatasi konten yang tersedia untuk kalimat yang hanya berhubungan dengan konsep yang paling penting, secara logis menghapus teks lain yang mungkin berhubungan dengan dampak atau evaluasi konsep.
Penulis ringkas ekstraktif yang digunakan dalam HARE adalah LexRank, SumBasic, dan TextRank.
HARE diuji pada 13 relawan selama 70 uji coba dan berbagai pendekatan algoritmik, dan dapat memperbarui ringkasan (teks yang ditulis ulang/dihapus) antara 1,3 milidetik dan 100ms pada laptop konsumen, tergantung pada model yang diuji. Hasil menunjukkan bahwa model yang menghapus sebagian besar teks tidak berkinerja baik, terutama karena ini dapat mempengaruhi koherensi teks yang tersisa.
Implikasi Etis dari Penulisan Ulang Artikel Dinamis
Peneliti mengakui kekhawatiran etis sekitar teknologi ini:
‘Tugas HARE dimaksudkan untuk desain aplikasi pengguna di masa depan. Dengan desain, aplikasi ini memiliki kemampuan untuk mengontrol apa yang dibaca pengguna dari artikel tertentu. Kemungkinan bahwa, ketika diterapkan tanpa perawatan yang cukup, alat ini dapat memperburuk efek “kamar gema” yang sudah dihasilkan oleh umpan berita otomatis, hasil pencarian, dan komunitas online.’
Namun, mereka juga mencatat bahwa sistem seperti ini dapat digunakan dalam aplikasi di masa depan untuk memitigasi efek kamar gema dengan menyuntikkan teks yang mengusulkan sudut pandang alternatif yang mungkin tidak hadir awalnya dalam artikel. Mereka mengamati: ‘Pemberatan faktor ini dapat disesuaikan untuk menyediakan pengalaman membaca yang menarik dan paparan terhadap keragaman ide.’
Orang-orang yang kemungkinan akan mendapat manfaat dari sistem seperti ini, menurut peneliti, adalah pembaca yang ingin menghemat waktu dalam mengambil informasi, dan penerbit konten.


