
एजीआई और भविष्य की एआई
ट्यूरिंग टेस्ट क्या है और यह क्यों महत्वपूर्ण है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
ट्यूरिंग टेस्ट एलन ट्यूरिंग के 1950 के पेपर “Computing Machinery and Intelligence” से उत्पन्न हुआ। विचार को परिभाषित करने की कोशिश करने के बजाय, ट्यूरिंग ने एक अनुकरण खेल प्रस्तावित किया: एक मानव पूछताछकर्ता अदृश्य प्रतिभागियों के साथ लिखित संदेशों का आदान‑प्रदान करता है और यह निर्णय लेता है कि कौन मानव है और कौन मशीन।
यह परीक्षण प्रभावशाली बना रहता है क्योंकि यह एक सारभूत दार्शनिक प्रश्न को एक देखी‑जाने वाली बातचीत में बदल देता है। यह सीमित भी है: बातचीत में मानव जैसा दिखना सत्य, ज्ञानवान, सुरक्षित, चेतन या सामान्य रूप से बुद्धिमान होने के बराबर नहीं है।
मुख्य बिंदु
- ट्यूरिंग का मूल अनुकरण खेल एक पाठ‑आधारित व्यवहारिक परीक्षण है, न कि आंतरिक संज्ञानात्मक गुणों की जाँच सूची।
- परिणाम मूल्यांकनकर्ता, प्रॉम्प्ट, अवधि, प्रतिभागी निर्देश और स्कोरिंग नियम पर निर्भर करते हैं।
- एक मॉडल तथ्य बनाकर या सरल मजबूती परीक्षणों में विफल होकर भी मानव संवाद की नकल कर सकता है।
- आधुनिक मूल्यांकन को संवाद के साथ-साथ कार्य मीट्रिक, प्रतिद्वंद्वी परीक्षण, मानव समीक्षा और जोखिम‑विशिष्ट साक्ष्य की आवश्यकता होती है।
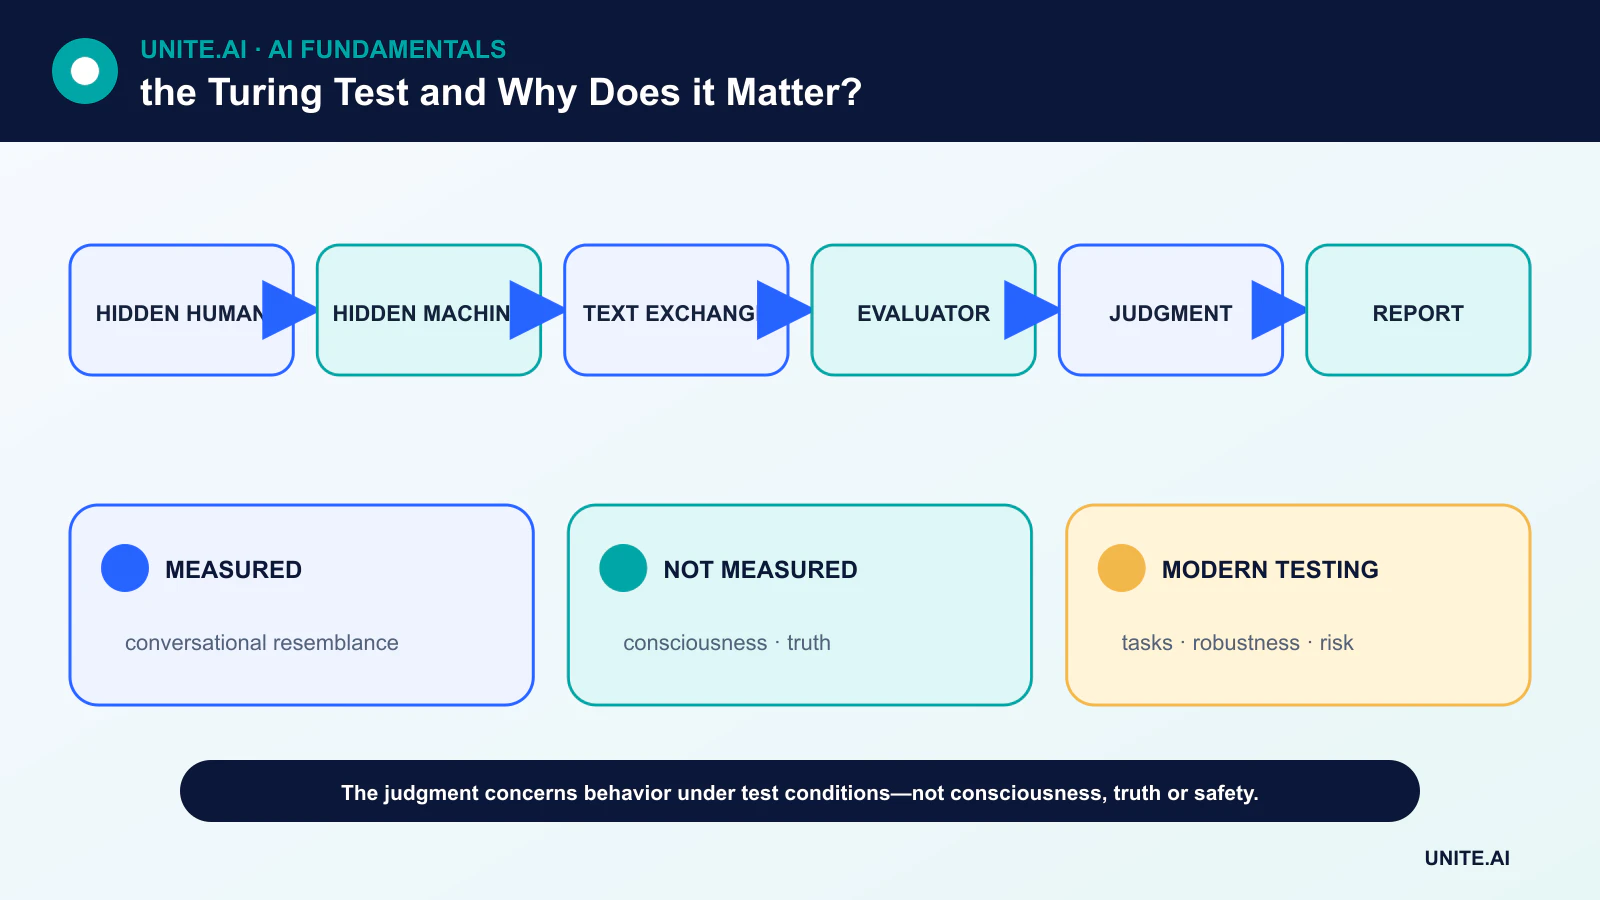
ट्यूरिंग का अनुकरण खेल
मूल सेटअप में, पूछताछकर्ता दूरी से संवाद करता था ताकि आवाज़ और दिखावट पहचान नहीं बता सके। ट्यूरिंग ने पूछा कि क्या मशीन खेल में पर्याप्त रूप से अच्छा प्रदर्शन कर सकती है जिससे मूल्यांकनकर्ता इसे व्यक्ति से विश्वसनीय रूप से अलग न कर सके।
यह कार्यात्मक रूपरेखा सोच की एक परिभाषा तय करने की आवश्यकता से बचती है। इसका दावा नहीं था कि हर प्रभावी संवाद बुद्धिमत्ता सिद्ध करता है, न ही इसने किसी सार्वभौमिक पास थ्रेशोल्ड को निर्दिष्ट किया जो बाद के किसी भी चैटबॉट प्रदर्शन पर लागू हो।
परिणाम वास्तव में क्या मापता है
एक परीक्षण निर्धारित परिस्थितियों में व्यवहारिक असमानता को मापता है। छोटे संवाद, अपरिचित न्यायाधीश या सिस्टम निर्माता द्वारा चुने गए प्रॉम्प्ट कार्य को आसान बना सकते हैं। एक कठोर रिपोर्ट में प्रतिलिपि चयन, न्यायाधीशों की संख्या और पृष्ठभूमि, तुलना के लिए मानव, समय सीमा और सांख्यिकीय विधि का खुलासा होना चाहिए।
एक सिस्टम अपेक्षाओं का भी लाभ उठा सकता है: बचाव, हास्य, टाइपोग्राफिकल त्रुटियां और भूमिका‑नाटक मानव जैसा दिख सकते हैं जबकि विश्वसनीय तर्क नहीं दिखाते। इसके विपरीत, अत्यधिक औपचारिक मानव प्रतिक्रिया को मशीन‑जनित माना जा सकता है।
ट्यूरिंग टेस्ट क्या स्थापित नहीं करता
यह परीक्षण सीधे चेतना, व्यक्तिपरक अनुभव, तथ्यात्मक शुद्धता, कारणात्मक समझ या नैतिक एजेंसी को नहीं मापता। यह बातचीत के बाहर प्रशिक्षण डेटा, मॉडल संरचना या विफलता मोड को नहीं दर्शाता। यह शारीरिक हेरफेर जैसी गैर‑भाषाई बुद्धिमत्ता के बारे में भी कम ही बताता है।
आधुनिक भाषा प्रणालियाँ ट्रांसफ़ॉर्मर न्यूरल नेटवर्क और डीप लर्निंग से निर्मित हैं, लेकिन उनके प्रवाहपूर्ण आउटपुट अभी भी सीखी गई सांख्यिकीय संरचना से उत्पन्न हो सकते हैं न कि सत्यापित विश्व मॉडल से।
आधुनिक एआई मूल्यांकन प्रश्न को कैसे विस्तारित करता है
समकालीन मूल्यांकन में अलग‑रखे कार्य सेट, कैलिब्रेटेड अनिश्चितता, मजबूती परीक्षण, रेड‑टीमिंग, तथ्यात्मकता जांच और मानव प्राथमिकता अध्ययन शामिल हैं। एक टेक्स्ट‑क्लासिफिकेशन मीट्रिक परिभाषित व्यवहार का परीक्षण कर सकता है, जबकि परिदृश्य‑आधारित मूल्यांकन यह देख सकता है कि प्रणाली दबाव में नीति का पालन करती है या नहीं।
कोई एकल बेंचमार्क सभी परिनियोजन को नहीं पकड़ सकता। परीक्षण का दूषित होना स्कोर को बढ़ा सकता है, और स्थिर बेंचमार्क ओवरफ़िटिंग को प्रोत्साहित करते हैं। मॉडल, डेटा, प्रॉम्प्ट, उपकरण और उपयोगकर्ता समूह बदलने पर मूल्यांकन को दोहराया जाना चाहिए।
टेस्ट अभी भी क्यों महत्वपूर्ण है
ट्यूरिंग टेस्ट ने एआई मूल्यांकन का एक मुख्य सबक पूर्वानुमानित किया: आंतरिक सार के दावों पर निर्भर रहने के बजाय देखी‑जाने वाली क्षमता का आकलन करना। यह हमें यह पूछने पर भी मजबूर करता है कि कौन‑से मानव व्यवहार साक्ष्य माने जाते हैं और प्रयोगात्मक सेटअप निष्कर्ष को कैसे आकार देता है।
इसका सबसे अच्छा आधुनिक उपयोग एक ऐतिहासिक और वैचारिक आधाररेखा के रूप में है। अनुकरण खेल को पास करना रोचक हो सकता है, परन्तु परिनियोजन निर्णयों के लिए वास्तविक कार्य, प्रभावित उपयोगकर्ता और संभावित नुकसानों से जुड़ा साक्ष्य आवश्यक है।
ट्यूरिंग टेस्ट क्या मापता है
एलन ट्यूरिंग का अनुकरण खेल यह पूछता था कि क्या पाठ के माध्यम से संवाद करने वाला पूछताछकर्ता मशीन को व्यक्ति से विश्वसनीय रूप से अलग कर सकता है। इसने मशीनों के सोचने के बारे में सारभूत बहस को एक देखी‑जाने वाली संवादात्मक प्रयोग में बदल दिया। परीक्षण प्रतिभागियों, अवधि, प्रोटोकॉल, विषयों और निर्णय नियम पर निर्भर करता है; कोई एकल सार्वभौमिक स्कोर नहीं है। पास होना इस सेटअप में मानव‑समान प्रतिक्रियाएँ उत्पन्न करने को दर्शाता है। यह सीधे तथ्यात्मक शुद्धता, तर्क, चेतना, स्वायत्तता, धारणा, शरीर‑रूप, विश्वसनीयता या लाभकारी वास्तविक‑विश्व व्यवहार को नहीं मापता।
मानव अनुकरण बचाव, व्यक्तित्व, त्रुटियों, हास्य या हेरफेर को पुरस्कृत कर सकता है। एक न्यायाधीश मानव को मशीन समझ सकता है या अपेक्षाओं, भाषा और सांस्कृतिक संदर्भ से प्रभावित हो सकता है। छोटे संवाद ऐसे चालों को सक्षम बनाते हैं जो दीर्घकालिक बातचीत में विफल होते हैं। इसके विपरीत, गणित, अनुवाद या प्रोटीन मॉडलिंग के लिए अत्यधिक उपयोगी प्रणाली विफल हो सकती है क्योंकि वह मानव होने का नाटक नहीं करती। इसलिए यह टेस्ट मूल्यांकनकर्ता द्वारा आकारित सामाजिक और भाषाई क्षमता को मापता है, न कि बुद्धिमत्ता का पूर्ण क्रम।
आधुनिक भाषा मॉडल और सशक्त मूल्यांकन
बड़े भाषा मॉडल व्यापक प्रशिक्षण डेटा और बाद के ट्यूनिंग से क्रमों की भविष्यवाणी करके प्रवाहपूर्ण संवाद बनाए रख सकते हैं, परन्तु प्रवाहता सत्य या समझ का कमजोर प्रमाण है। स्मृत पैटर्न, उपकरण पहुँच, छिपा प्रॉम्प्ट, विलंब और सैंपलिंग सेटिंग्स परिणामों को प्रभावित करती हैं। नियंत्रित मूल्यांकन में मॉडल और प्रोटोकॉल का खुलासा होना चाहिए, सूचना रिसाव को रोकना चाहिए, प्रतिद्वंद्वी और डोमेन प्रश्न शामिल करने चाहिए, तथा अनिश्चितता और उद्धरण को स्कोर करना चाहिए। सफल संवादों से चुना गया प्रदर्शन उपयोग वितरण में विश्वसनीयता का अनुमान नहीं लगा सकता।
आधुनिक मूल्यांकन बहु‑आयामी है: कार्य शुद्धता, कैलिब्रेशन, मजबूती, दीर्घ‑होराइज़न संगतता, सुरक्षा, पक्षपात, गोपनीयता, सुरक्षा, दक्षता और मानव परिणाम। व्यवहारिक परीक्षणों को प्रक्रिया साक्ष्य, रेड‑टीमिंग, पुनरुत्पाद्य बेंचमार्क और वास्तविक‑विश्व निगरानी से पूरक होना चाहिए। बेंचमार्क संतृप्त हो सकते हैं या प्रशिक्षण डेटा में प्रवेश कर सकते हैं, इसलिए निजी और अद्यतन परीक्षण सेट आवश्यक हैं। जो सिस्टम कार्य करते हैं, उनके लिए उपकरण अनुमतियों, पुनर्प्राप्ति और परिणामों का मूल्यांकन संवाद गुणवत्ता से अलग किया जाना चाहिए।
टेस्ट अभी भी क्यों महत्वपूर्ण है
ट्यूरिंग टेस्ट ऐतिहासिक रूप से महत्वपूर्ण बना रहता है क्योंकि यह व्यवहार और बुद्धिमत्ता की परिभाषा की कठिनाई पर केंद्रित है। यह मानवरूपता और धोखे के बारे में निरंतर प्रश्न भी उठाता है। इंटरफ़ेस को कृत्रिम एजेंटों की पहचान करनी चाहिए न कि गलत पहचान को सफलता मानना चाहिए, विशेषकर प्रभावशाली स्थितियों में। इस टेस्ट को दार्शनिक लेंस और एक संवादात्मक मूल्यांकन के रूप में उपयोग करें, न कि सामान्य बुद्धिमत्ता या व्यक्तित्व का प्रमाणपत्र। प्रमुख परिनियोजन प्रश्न यह है कि सिस्टम क्या विश्वसनीय रूप से कर सकता है, किस साक्ष्य और सीमाओं के तहत, और विफल होने पर कौन उत्तरदायी है।
व्यावहारिक उदाहरण: एक नियंत्रित संवादात्मक मूल्यांकन
मूल्यांकनकर्ता स्थायी अवधि, विषय, भाषा और अंधे पहचान के साथ पाठ संवादों में मानव और कई एआई सिस्टमों की तुलना करते हैं। न्यायाधीश रिकॉर्ड करते हैं कि वे प्रत्येक प्रतिभागी को मानव मानते हैं या नहीं और साथ ही तथ्यात्मकता, संगति, उपयोगिता, अनिश्चितता और हेरफेर को स्कोर करते हैं। कई न्यायाधीश और संवाद परिवर्तनशीलता का अनुमान लगाते हैं, और प्रोटोकॉल मॉडल डेवलपर्स को अनुकूल प्रतिलिपि चुनने से रोकता है। मानव गलत वर्गीकरण परिणाम की व्याख्या के लिए आवश्यक आधाररेखा प्रदान करता है।
एक प्रणाली जो न्यायाधीशों को धोखा देती है लेकिन तथ्य बनाती है, उसे सामान्य रूप से बुद्धिमान घोषित नहीं किया जाता, जबकि स्पष्ट रूप से उजागर किया गया विशेषज्ञ मॉडल, अनुकरण में विफल होने के बावजूद अत्यधिक उपयोगी हो सकता है। परिणामों में प्रॉम्प्ट, मॉडल, सैंपलर, उपकरण पहुँच और न्यायाधीश की विशेषताएँ शामिल हैं। प्रयोग को मानव‑समान संवाद के एक परीक्षण के रूप में रूपरेखित किया गया है। परिनियोजन निर्णय कार्य शुद्धता, सुरक्षा, गोपनीयता और पुनर्प्राप्ति के लिए अलग साक्ष्य का उपयोग करते हैं, और इंटरफ़ेस एजेंट की पहचान करता है न कि धोखे को उत्पाद लक्ष्य बनाता है।
कार्यान्वयन साक्ष्य और संचालन तत्परता
एक उत्पादन निर्णय को सफल प्रदर्शन से अधिक चाहिए। इच्छित उपयोगकर्ता, संचालन पर्यावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले पुनरुत्पाद्य आधाररेखा और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपस्थित इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग और उन समूहों या पर्यावरणों का परीक्षण करें जो सबसे अधिक सेवा‑हीन हो सकते हैं। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, विलंब, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि स्वतंत्र समीक्षक परिणाम को पुन: उत्पन्न कर सके और आकर्षक प्रोटोटाइप से साक्ष्य को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक और सेवानिवृत्ति के लिए अधिकार सौंपें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित बैकअप रखें, और जानबूझकर डाली गई विफलताओं के साथ निगरानी सत्यापित करें। संचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक निर्धारित करें, फिर परिनियोजन के बाद वास्तविक‑विश्व साक्ष्य की समीक्षा करें, न कि ऑफ़लाइन प्रदर्शन को स्थायी मानें। डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियों, हार्डवेयर या उद्देश्यों में परिवर्तन होने पर पुनः मूल्यांकन करें। एक रखरखाव प्रणाली को दस्तावेज़ीकृत पुनर्प्राप्ति, घटना सीखना, विलोपन और प्रतिधारण प्रक्रियाओं की भी आवश्यकता होती है, तथा वह स्पष्ट बिंदु जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या कोई एआई निश्चित रूप से ट्यूरिंग टेस्ट पास कर चुका है?
कोई एकल आधिकारिक परीक्षण प्राधिकरण या सार्वभौमिक रूप से स्वीकृत प्रोटोकॉल नहीं है। सार्वजनिक प्रदर्शनों में विभिन्न नियम उपयोग होते हैं, इसलिए “पास” दावे सीधे तुलना योग्य नहीं हैं।
क्या टेस्ट में असफल होना यह सिद्ध करता है कि सिस्टम अज्ञानी है?
नहीं। एक विशिष्ट प्रणाली मानव संवाद शैली की नकल किए बिना भी अत्यधिक सक्षम हो सकती है।
प्राथमिक संदर्भ












