
Anderson का एंगल
यूनीट्यून: गूगल की वैकल्पिक न्यूरल इमेज एडिटिंग तकनीक

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
मुख्य बिंदुUniTune एक एकल छवि पर एक प्रसार मॉडल को सूक्ष्म-समायोजित करता है ताकि सटीक पाठ-संचालित…
और देखें
- UniTune एक एकल छवि पर एक प्रसार मॉडल को सूक्ष्म-समायोजित करता है ताकि सटीक पाठ-संचालित संपादन सक्षम हो सके।
- DreamBooth या Textual Inversion के विपरीत, UniTune बेहतर विवरण संरक्षण के लिए दोनों दृष्टिकोणों को अस्वीकार करता है।
- यह विधि उच्च शब्दार्थ पृथक्करण प्राप्त करती है, कट्टर पृष्ठभूमि परिवर्तनों के दौरान चेहरों को बरकरार रखती है।
गूगल रिसर्च, ऐसा लगता है, टेक्स्ट-आधारित इमेज एडिटिंग पर कई मोर्चों से हमला कर रहा है, और संभवतः, यह देखने के लिए इंतजार कर रहा है कि क्या ‘काम करता है’। इस सप्ताह की शुरुआत में अपने इमैगिक पेपर के रिलीज के बाद, सर्च जाइंट ने एक अतिरिक्त लेटेंट डिफ्यूजन-आधारित विधि का प्रस्ताव किया है जो छवियों पर एआई-आधारित संपादन करने के लिए पाठ आदेशों के माध्यम से असंभव संपादन करने के लिए, इस बार यूनीट्यून नामक एक विधि का प्रस्ताव किया है।
परियोजना के नए पेपर में दिए गए उदाहरणों के आधार पर, यूनीट्यून ने अर्थगत मुद्रा और विचार को वास्तविक छवि सामग्री से अलग करने में एक असाधारण डिग्री हासिल की है:

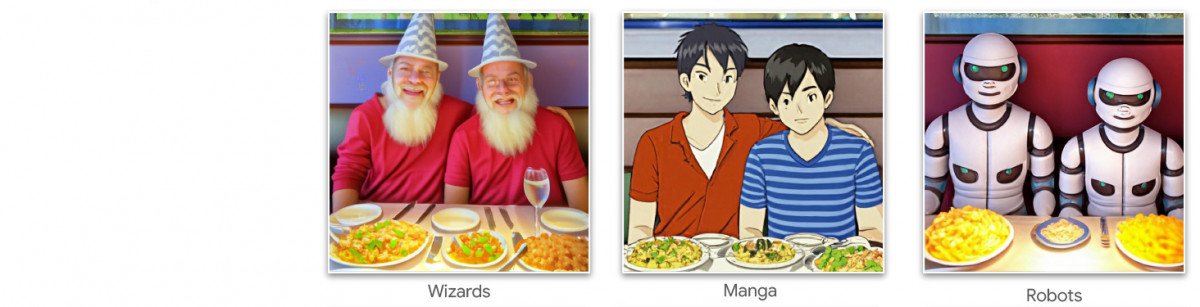

अर्थगत संरचना पर यूनीट्यून का नियंत्रण उत्कृष्ट है। ऊपरी पंक्ति में दोनों लोगों के चेहरे विकृत नहीं हुए हैं, जबकि मूल छवि का बाकी हिस्सा अत्यधिक बदला है (दाएं)। स्रोत: https://arxiv.org/pdf/2210.09477.pdf
स्टेबल डिफ्यूजन प्रशंसकों को अब तक पता चल गया होगा कि एक चित्र के आंशिक भागों में संपादन लागू करना बिना छवि के बाकी हिस्से को खराब किए एक मुश्किल, कभी-कभी असंभव ऑपरेशन हो सकता है। हालांकि लोकप्रिय वितरण जैसे AUTOMATIC1111 स्थानीय और प्रतिबंधित संपादन के लिए मास्क बना सकते हैं, प्रक्रिया दर्दनाक और अक्सर अनियमित होती है।
स्पष्ट उत्तर, कम से कम एक कंप्यूटर विजन प्रैक्टिशनर के लिए, एक छवि में वस्तुओं को पहचानने और अलग करने में सक्षम सेमेंटिक सेगमेंटेशन की एक परत को अंतर्वेशित करना है जो उपयोगकर्ता हस्तक्षेप के बिना होता है, और वास्तव में, हाल ही में इस विचार के साथ कई नए पहल हैं।
एक और संभावना जो अशांत और जटिल न्यूरल इमेज एडिटिंग ऑपरेशन को लॉक करने के लिए है ओपनएआई के प्रभावशाली कंट्रास्टिव लैंग्वेज-इमेज प्री-ट्रेनिंग (सीएलआईपी) मॉड्यूल का लाभ उठाना है, जो डीएलएल-ई 2 और स्टेबल डिफ्यूजन जैसे लेटेंट डिफ्यूजन मॉडल के दिल में है। इस संदर्भ में, सीएलआईपी को एक फिल्टर के रूप में कार्य करना चाहिए जब एक पाठ-से-छवि मॉडल उपयोगकर्ता को एक व्याख्या की गई रेंडर भेजने के लिए तैयार होता है। इस संदर्भ में, सीएलआईपी को एक सेंटिनेल और गुणवत्ता नियंत्रण मॉड्यूल के रूप में कार्य करना चाहिए, जो दोषपूर्ण या अन्यथा अनुपयुक्त रेंडर को अस्वीकार करता है। यह जल्द लागू (डिस्कॉर्ड लिंक) होने वाला है स्टेबिलिटी.एआई के ड्रीमस्टूडियो एपीआई-ड्रिवन पोर्टल पर।
हालांकि, चूंकि सीएलआईपी इस तरह के परिदृश्य में दोषी और समाधान दोनों है (क्योंकि यह मूल रूप से छवि के विकास के तरीके को भी सूचित करता है), और चूंकि हार्डवेयर आवश्यकताएं संभवतः उपयोगकर्ता के लिए स्थानीय रूप से उपलब्ध होने से अधिक हो सकती हैं, यह दृष्टिकोण आदर्श नहीं हो सकता है।
संकुचित भाषा
प्रस्तावित यूनीट्यून इसके बजाय एक मौजूदा डिफ्यूजन मॉडल को ‘फाइन ट्यून’ करता है – इस मामले में, गूगल का अपना इमेजन, हालांकि शोधकर्ता कहते हैं कि यह विधि अन्य लेटेंट डिफ्यूजन आर्किटेक्चर के साथ संगत है – ताकि एक अद्वितीय टोकन इसमें इंजेक्ट किया जा सके जिसे एक पाठ प्रॉम्प्ट में शामिल करके बुलाया जा सकता है।
प्रतीत होता है, यह गूगल ड्रीमबूथ जैसा लगता है, जो वर्तमान में स्टेबल डिफ्यूजन प्रशंसकों और डेवलपर्स के बीच एक जुनून है, जो एक मौजूदा चेकपॉइंट में नए पात्रों या वस्तुओं को इंजेक्ट कर सकता है, अक्सर केवल कुछ स्रोत चित्रों के आधार पर एक घंटे से कम समय में; या टेक्स्टुअल इनवर्जन जैसा, जो एक चेकपॉइंट के लिए ‘साइडकार’ फाइलें बनाता है, जिन्हें माना जाता है कि वे मूल रूप से मॉडल में प्रशिक्षित किए गए थे, और मॉडल के अपने विशाल संसाधनों का लाभ उठाने के लिए इसके पाठ वर्गीकरण को संशोधित करके एक छोटी फाइल (ड्रीमबूथ के कम से कम 2GB आकार वाले प्रून किए गए चेकपॉइंट की तुलना में) बना सकता है।
वास्तव में, शोधकर्ता दावा करते हैं कि यूनीट्यून ने इन दोनों दृष्टिकोणों को अस्वीकार कर दिया। उन्होंने पाया कि टेक्स्टुअल इनवर्जन ने बहुत सारे महत्वपूर्ण विवरणों को छोड़ दिया, जबकि ड्रीमबूथ ‘कम प्रदर्शन किया और अधिक समय लिया’ समाधान की तुलना में जिस पर वे अंततः बस गए।
हालांकि, यूनीट्यून ड्रीमबूथ के समान एन्कैप्सुलेटेड सेमेंटिक ‘मेटाप्रॉम्प्ट’ दृष्टिकोण का उपयोग करता है, जिसमें प्रशिक्षित परिवर्तन प्रशिक्षक द्वारा चुने गए अद्वितीय शब्दों द्वारा बुलाए जाते हैं, जो किसी भी शब्दों से टकराव नहीं करेंगे जो वर्तमान में एक श्रमसाध्य प्रशिक्षित सार्वजनिक रिलीज मॉडल में मौजूद हैं।
QUOTEOPEN‘संपादन ऑपरेशन करने के लिए, हम फाइन-ट्यून किए गए मॉडल को प्रॉम्प्ट “[rare_tokens] edit_prompt” (जैसे “beikkpic दो कुत्ते एक रेस्तरां में” या “beikkpic एक मिनियन”) के साथ नमूना लेते हैं।’QUOTECLOSE
प्रक्रिया
हालांकि यह समझ से बाहर है कि दो लगभग समान पत्र, जिनकी अंतिम कार्यक्षमता के संदर्भ में समान हैं, गूगल से एक ही सप्ताह में क्यों आ सकते हैं, यूनीट्यून और इमैगिक के बीच एक स्पष्ट अंतर है – बाद में ‘असंकुचित’ प्राकृतिक भाषा प्रॉम्प्ट का उपयोग करके छवि संपादन ऑपरेशन को निर्देशित किया जाता है, जबकि यूनीट्यून ड्रीमबूथ शैली के अद्वितीय टोकन में प्रशिक्षित होता है।
अतः, यदि आप इमैगिक के साथ संपादन कर रहे थे और इस प्रकार के परिवर्तन को लागू करना चाहते थे…

यूनीट्यून पेपर से – यूनीट्यून गूगल के पसंदीदा प्रतिद्वंद्वी न्यूरल एडिटिंग फ्रेमवर्क, एसडीईडिट के खिलाफ खुद को स्थापित करता है। यूनीट्यून के परिणाम सबसे दाईं ओर हैं, जबकि अनुमानित मास्क बाईं ओर से दूसरी छवि में है।
.. इमैगिक में, आप ‘पृष्ठभूमि में बैठे तीसरे व्यक्ति को एक प्यारे रोएँदार राक्षस के रूप में’ इनपुट करेंगे।
यूनीट्यून का समकक्ष कमांड ‘पीछे का व्यक्ति [x] के रूप में’ होगा, जहां x वह अजीब और अद्वितीय शब्द है जो फुरी मॉन्स्टर पात्र से जुड़े फाइन-ट्रेन्ड कॉन्सेप्ट से जुड़ा हुआ है।
DreamBooth और Textual Inversion में कई छवियाँ दी जाती हैं ताकि एक डीपफेक जैसी अमूर्त अवधारणा बनाई जा सके जिसे कई मुद्राओं में प्रस्तुत किया जा सके। इसके विपरीत, यूनीट्यून और इमैगिक सिस्टम में केवल एक छवि देते हैं: मूल, अपरिवर्तित छवि।
यह कई GAN-आधारित संपादन टूल्स के समान है जो पिछले कुछ वर्षों में संचालित हुए हैं – एक इनपुट छवि को GAN के लेटेंट स्पेस में लेटेंट कोड में परिवर्तित करके और फिर उन कोड को संशोधन के लिए लेटेंट स्पेस के अन्य भागों में भेजकर (यानी, एक युवा गहरे बालों वाले व्यक्ति की एक तस्वीर इनपुट करना और इसे ‘बुजुर्ग’ या ‘सुनहरे’ से जुड़े लेटेंट कोड के माध्यम से परियोजना करना)।
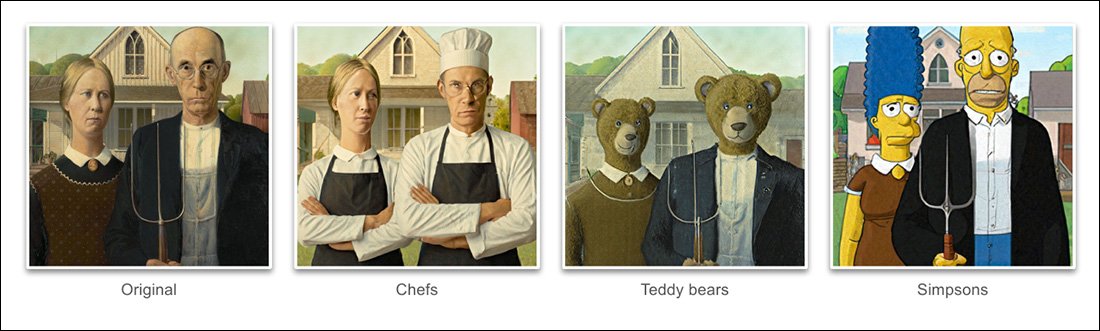
हालांकि, परिणाम, एक डिफ्यूजन मॉडल में, और इस विधि द्वारा, तुलना द्वारा आश्चर्यजनक रूप से सटीक हैं:
फाइन-ट्यूनिंग प्रक्रिया
यूनीट्यून विधि मूल रूप से मॉडिफिकेशन पर निर्देश देने वाले एक सेट के साथ एक मौजूदा छवि को एक डिफ्यूजन मॉडल के माध्यम से भेजती है, जिसे मॉडल में प्रशिक्षित डेटा के विशाल भंडार का उपयोग करके संशोधित किया जा सकता है। वास्तव में, आप इसे अभी स्टेबल डिफ्यूजन के img2img कार्यक्षमता के साथ कर सकते हैं – लेकिन ऐसा करने पर छवि के वे हिस्से भी विकृत या किसी तरह बदल जाते हैं जिन्हें आप सुरक्षित रखना चाहते हैं।
यूनीट्यून प्रक्रिया के दौरान, सिस्टम को फाइन-ट्यून किया जाता है, जिसका अर्थ है कि यूनीट्यून मॉडल को फिर से प्रशिक्षित करने के लिए मजबूर किया जाता है, जिसमें इसकी अधिकांश परतें अनफ्रोजन होती हैं (नीचे देखें)। अधिकांश मामलों में, फाइन-ट्यूनिंग एक उच्च-प्रदर्शन वाले मॉडल के समग्र सामान्य नुकसान मूल्यों को कुछ और पहलू को बनाने या बढ़ाने के लिए टैंक कर देगी जो वांछित है।
हालांकि, यूनीट्यून के साथ, यह लगता है कि मॉडल की प्रतिलिपि जिस पर कार्रवाई की जाती है, जो कई गीगाबाइट या अधिक हो सकती है, एक अपशिष्ट ‘खोल’ के रूप में माना जाएगा और प्रक्रिया के अंत में त्याग दिया जाएगा, एक बार इसका एकमात्र उद्देश्य पूरा हो जाने के बाद। इस तरह के आकस्मिक भारी डेटा मात्रा ड्रीमबूथ प्रशंसकों के लिए एक दैनिक भंडारण संकट बन रहा है, जिनके अपने मॉडल, यहां तक कि प्रून किए जाने पर भी, प्रति विषय 2GB से कम नहीं हैं।
इमैगिक की तरह, यूनीट्यून में मुख्य ट्यूनिंग इमेजन (गूगल का अपना मॉडल) की निचली दो परतों में होती है (बेस 64px, 64px>256px, और 256px>1024px)। इमैगिक के विपरीत, शोधकर्ता इस अंतिम और सबसे बड़ी सुपर-रिज़ॉल्यूशन परत (हालांकि उन्होंने इसे अभी तक नहीं किया है) के लिए ट्यूनिंग को अनुकूलित करने में कुछ मूल्य देखते हैं।
निम्नलिखित 64px परत के लिए, मॉडल को प्रशिक्षण के दौरान आधार छवि की ओर पक्षपातपूर्ण होता है, जिसमें छवि/पाठ के कई डुप्लिकेट जोड़े को 128 पुनरावृत्तियों के लिए बैच आकार 4 के साथ सिस्टम में फीड किया जाता है, और एडाफैक्टर के साथ एक नुकसान कार्य के रूप में कार्य करता है, जो 0.0001 की लर्निंग दर पर संचालित होता है। हालांकि टी5 एन्कोडर अकेले इस फाइन-ट्यूनिंग के दौरान जमे हुए हैं, यह इमेजन के प्राथमिक प्रशिक्षण के दौरान भी जमे हुए हैं।
फिर यही प्रक्रिया 64>256px परत के लिए दोहराई जाती है, जिसमें Imagen के मूल प्रशिक्षण वाली शोर-वृद्धि प्रक्रिया का उपयोग होता है।
नमूना निर्माण
परिवर्तनों को फाइन-ट्यून किए गए मॉडल से प्राप्त करने के लिए कई संभावित नमूना विधियां हैं, जिनमें क्लासिफायर फ्री गाइडेंस (सीएफजी) शामिल है, जो स्टेबल डिफ्यूजन का भी एक मुख्य भाग है। सीएफजी मूल रूप से यह परिभाषित करता है कि मॉडल को अपनी कल्पना का पालन करने और रेंडरिंग संभावनाओं का अन्वेषण करने की स्वतंत्रता की कितनी डिग्री है – या फिर, निम्न सेटिंग्स पर, यह सीमा कि यह कितना इनपुट सोर्स डेटा से चिपके रहना चाहिए, और कम महत्वपूर्ण या नाटकीय परिवर्तन करना चाहिए।

टेक्स्टुअल इनवर्जन (ड्रीमबूथ की तुलना में थोड़ा कम) की तरह, यूनीट्यून मूल छवियों पर विशिष्ट ग्राफिक शैलियों को लागू करने के लिए, साथ ही अधिक फोटोरियलिस्टिक संपादन के लिए भी उपयुक्त है।
शोधकर्ताओं ने एसडीईडिट की ‘लेट स्टार्ट’ तकनीक के साथ भी प्रयोग किया, जहां सिस्टम को मूल विवरण को संरक्षित करने के लिए प्रोत्साहित किया जाता है क्योंकि यह शुरू से ही केवल आंशिक रूप से ‘शोर’ है, लेकिन इसके बजाय इसके मूल गुणों को बनाए रखता है। हालांकि शोधकर्ताओं ने केवल निम्नलिखित परत (64px) पर इसका उपयोग किया, वे मानते हैं कि यह भविष्य में एक उपयोगी सहायक नमूना तकनीक हो सकती है।
शोधकर्ताओं ने प्रॉम्प्ट-टू-प्रॉम्प्ट का भी लाभ उठाया एक अतिरिक्त पाठ-आधारित तकनीक के रूप में मॉडल को सशर्त बनाने के लिए:
QUOTEOPEN‘प्रॉम्प्ट टू प्रॉम्प्ट सेटिंग में, हमने पाया कि एक तकनीक जिसे हम प्रॉम्प्ट गाइडेंस कहते हैं मूल के प्रति सटीकता और अभिव्यक्ति को समायोजित करने के लिए विशेष रूप से सहायक है। ‘QUOTECLOSE
QUOTEOPEN‘प्रॉम्प्ट गाइडेंस क्लासिफायर फ्री गाइडेंस के समान है लेकिन बेसलाइन एक अलग प्रॉम्प्ट है न कि अनशर्त मॉडल। यह मॉडल को दो प्रॉम्प्ट के बीच डेल्टा की ओर मार्गदर्शन करता है।’QUOTECLOSE

यूनीट्यून में प्रॉम्प्ट-टू-प्रॉम्प्ट, जो कि परिवर्तन के लिए क्षेत्रों को अलग करने में प्रभावी है।
हालांकि, प्रॉम्प्ट गाइडेंस, लेखकों का कहना है, कभी-कभी आवश्यक था, जब सीएफजी वांछित परिणाम प्राप्त करने में विफल रहा।
एक और नोवेल नमूना दृष्टिकोण जो यूनीट्यून के विकास के दौरान मिला, इंटरपोलेशन था, जहां छवि के क्षेत्र इतने अलग होते हैं कि मूल और संशोधित छवि रचना में बहुत समान होती है, जिससे एक अधिक सरल इंटरपोलेशन का उपयोग किया जा सकता है।

इंटरपोलेशन यूनीट्यून की उच्च-प्रयास प्रक्रियाओं को तब अनावश्यक बना सकता है जब परिवर्तित किए जाने वाले क्षेत्र अलग-अलग और स्पष्ट सीमाओं वाले होते हैं।
लेखकों का सुझाव है कि इंटरपोलेशन इतना अच्छा काम कर सकता है कि यह एक डिफ़ॉल्ट सेटिंग के रूप में उपयोग किया जा सकता है, और यह भी देखते हैं कि जहाँ अधिक गहन तरीकों से जटिल ओट या ढकाव सँभालने की आवश्यकता नहीं होती, वहाँ यह असाधारण बदलाव कर सकता है।
यूनीट्यून संपादन मास्क के साथ या बिना स्थानीय संपादन कर सकता है, लेकिन संपादन को स्थिति भी निर्धारित कर सकता है, एक असामान्य संयोजन के साथ व्याख्यात्मक शक्ति और मूल इनपुट डेटा का सार।

दूसरी कॉलम में सबसे ऊपरी छवि में, यूनीट्यून को ‘पृष्ठभूमि में एक लाल ट्रेन’ डालने के लिए कहा गया है, जिसे यह एक उपयुक्त और प्रामाणिक स्थिति में रखा गया है। अन्य उदाहरणों में ध्यान दें कि कैसे सेमेंटिक अखंडता मूल छवि को बनाए रखी जाती है, यहां तक कि छवियों के पिक्सेल सामग्री और मूल शैलियों में असाधारण परिवर्तन के बावजूद।
विलंब
हालांकि किसी भी नए सिस्टम का पहला पुनरावृत्ति धीमा होने वाला है, और हालांकि यह संभव है कि समुदाय की भागीदारी या कॉर्पोरेट प्रतिबद्धता (यह आमतौर पर दोनों नहीं है) अंततः संसाधन-गहन दिनचर्या को तेज और अनुकूलित करेगी, दोनों यूनीट्यून और इमैगिक कुछ काफी महत्वपूर्ण मशीन लर्निंग मैन्यूवर्स कर रहे हैं जो इन अद्भुत संपादनों को बनाने के लिए, और यह संदेहास्पद है कि इस तरह की संसाधन-गहन प्रक्रिया को घरेलू उपयोग के लिए कम किया जा सकता है या नहीं, इसके बजाय एपीआई-ड्रिवन एक्सेस (हालांकि बाद वाला गूगल के लिए अधिक वांछनीय हो सकता है)।
वर्तमान में, इनपुट से परिणाम तक का राउंड ट्रिप लगभग 3 मिनट है टी4 जीपीयू पर, और लगभग 30 सेकंड का अतिरिक्त अनुमान (किसी भी अनुमान दिनचर्या के अनुसार)। लेखक स्वीकार करते हैं कि यह विलंब उच्च है, और ‘इंटरैक्टिव’ के रूप में योग्य नहीं है, लेकिन वे यह भी नोट करते हैं कि मॉडल एक बार शुरू में ट्यून हो जाने के बाद आगे के संपादन के लिए उपलब्ध रहता है, जब तक कि उपयोगकर्ता प्रक्रिया के साथ समाप्त नहीं हो जाता, जो प्रति संपादन समय को कम करता है।
पहली बार 21 अक्टूबर 2022 को प्रकाशित।


