
Anderson का एंगल
गूगल के Imagic और Runway के ‘Erase and Replace’ के साथ AI-सहायता प्राप्त वस्तु संपादन

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें

इस सप्ताह दो नई, लेकिन विपरीत AI-चालित ग्राफ़िक्स एल्गोरिदम उपयोगकर्ताओं को फ़ोटो में वस्तुओं में अत्यधिक सूक्ष्म और प्रभावी परिवर्तन करने के नए तरीके प्रदान कर रहे हैं।
पहला है Imagic, जो Google Research द्वारा, इज़राइल के Institute of Technology और Weizmann Institute of Science के सहयोग से विकसित किया गया है। Imagic टेक्स्ट-शर्तीय, सूक्ष्म वस्तु संपादन को डिफ्यूज़न मॉडलों के फाइन‑ट्यूनिंग के माध्यम से प्रदान करता है।

जो आप पसंद करें, उसे बदलें, और बाकी को जैसा है वैसा ही छोड़ें – Imagic केवल उन भागों का सूक्ष्म संपादन करने का वादा करता है जिन्हें आप बदलना चाहते हैं। स्रोत: https://arxiv.org/pdf/2210.09276.pdf
जो भी किसी ने Stable Diffusion के पुनः‑रेंडर में केवल एक तत्व बदलने की कोशिश की है, वह अच्छी तरह जानता है कि हर सफल संपादन के साथ, सिस्टम उन पाँच चीज़ों को बदल देता है जिन्हें आप जैसा था वैसा ही पसंद करते थे। यह कमी वर्तमान में कई सबसे कुशल SD उत्साहियों को लगातार Stable Diffusion और Photoshop के बीच स्विच करते रहने पर मजबूर करती है, ताकि इस प्रकार के ‘सहायक नुकसान’ को ठीक किया जा सके। केवल इस पहलू से ही Imagic की उपलब्धियाँ उल्लेखनीय लगती हैं।
लेखन के समय, Imagic के पास अभी तक कोई प्रचार वीडियो भी नहीं है, और Google की सावधान दृष्टिकोण के कारण, यह अनिश्चित है कि हमें इस प्रणाली को परीक्षण करने का कोई अवसर मिलेगा या नहीं।
दूसरी पेशकश Runway ML की अपेक्षाकृत अधिक सुलभ Erase and Replace सुविधा है, जो नया फीचर है और इसके केवल ऑनलाइन उपलब्ध मशीन लर्निंग‑आधारित विज़ुअल इफ़ेक्ट यूटिलिटीज़ सूट के ‘AI Magic Tools’ अनुभाग में शामिल है।
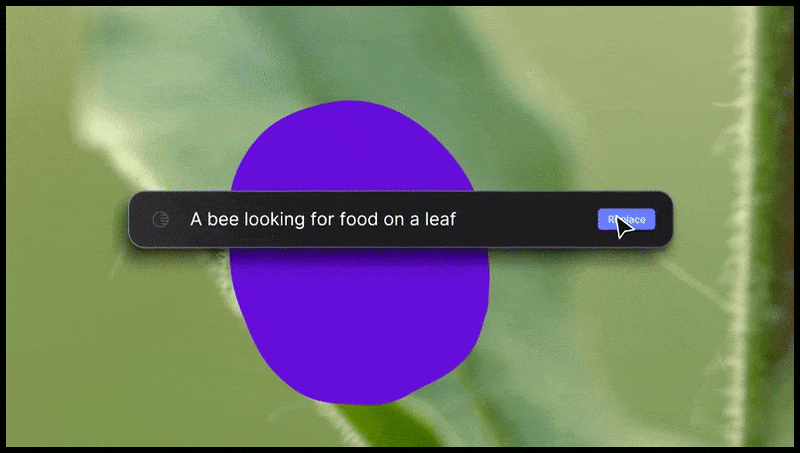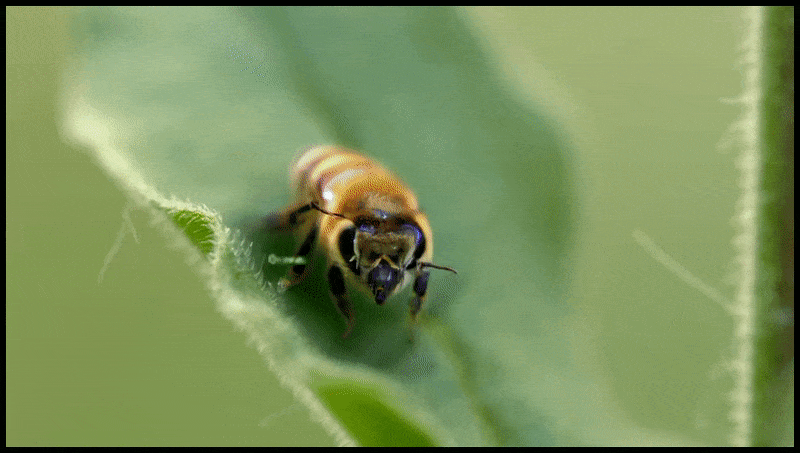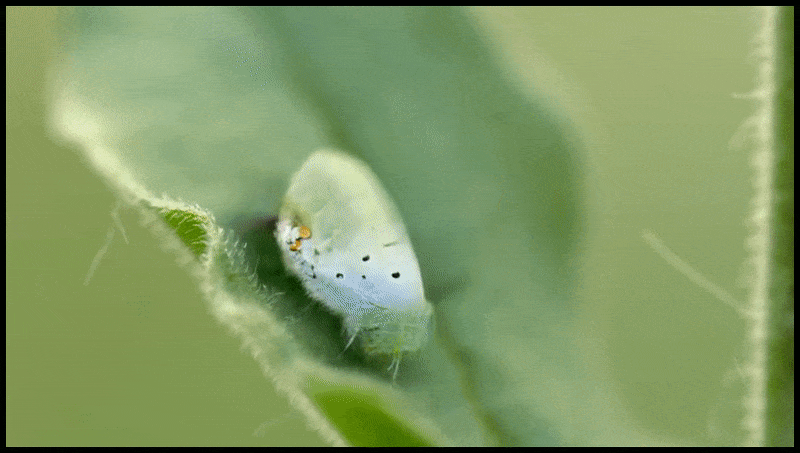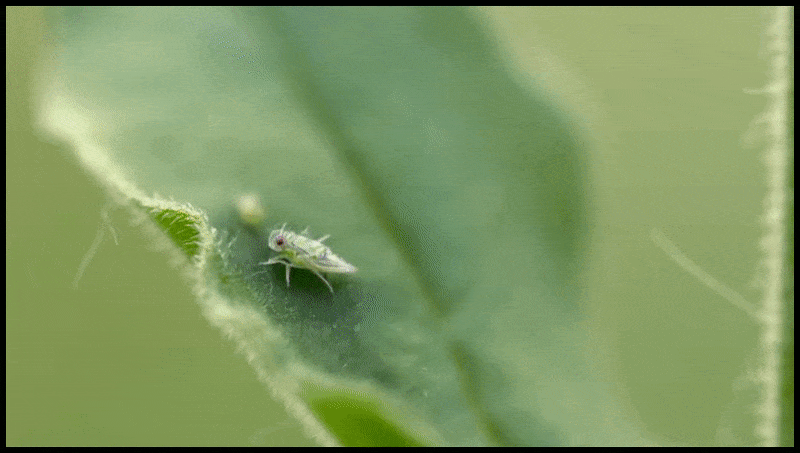
Runway ML की Erase and Replace सुविधा, पहले ही एक टेक्स्ट‑टू‑वीडियो संपादन प्रणाली के प्रीव्यू में देखी जा चुकी है।
चलो पहले Runway की पेशकश को देखें।
Erase and Replace
Imagic की तरह, Erase and Replace केवल स्थिर छवियों के साथ काम करता है, हालांकि Runway ने प्रीव्यू किया है कि वही कार्यक्षमता एक टेक्स्ट‑टू‑वीडियो संपादन समाधान में है जो अभी जारी नहीं हुई है:
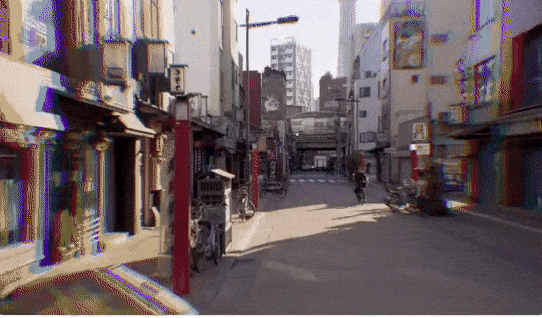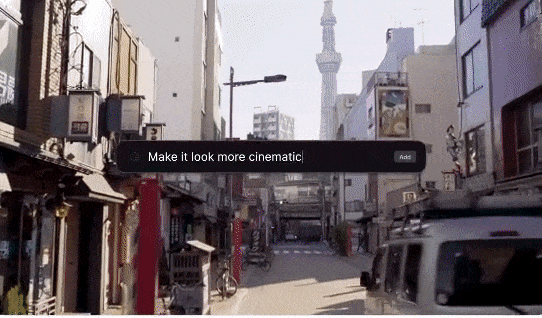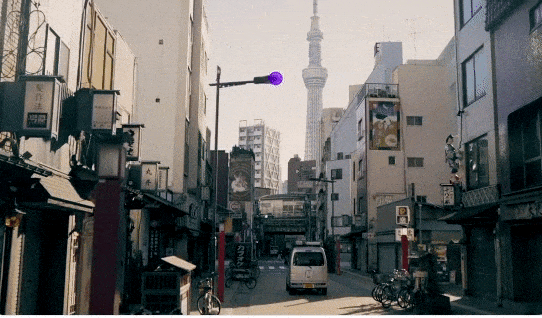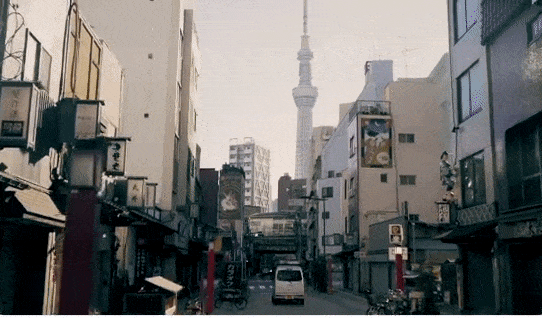
हालांकि कोई भी नई Erase and Replace को छवियों पर परीक्षण कर सकता है, वीडियो संस्करण अभी सार्वजनिक रूप से उपलब्ध नहीं है। स्रोत: https://twitter.com/runwayml/status/1568220303808991232
भले ही Runway ML ने Erase and Replace के पीछे की तकनीकों के विवरण जारी नहीं किए हैं, लेकिन एक घर के पौधे को तुलनात्मक रूप से विश्वसनीय Ronald Reagan की प्रतिमा से बदलने की गति यह संकेत देती है कि Stable Diffusion (या, बहुत कम संभावना, लाइसेंस प्राप्त DALL‑E 2) जैसे डिफ्यूज़न मॉडल ही वह इंजन है जो Erase and Replace में आपके चुने हुए वस्तु को पुनः निर्मित कर रहा है।

एक घर के पौधे को The Gipper की प्रतिमा से बदलना इस जितना तेज़ नहीं है, लेकिन फिर भी काफी तेज़ है। स्रोत: https://app.runwayml.com/
सिस्टम में कुछ DALL‑E 2 प्रकार की प्रतिबंध हैं – ऐसी छवियाँ या टेक्स्ट जो Erase and Replace फ़िल्टर को चिन्हित करती हैं, आगे के उल्लंघन की स्थिति में संभावित खाता निलंबन की चेतावनी उत्पन्न करेंगे – यह व्यावहारिक रूप से OpenAI की चल रही नीतियों का एक बायलरप्लेट क्लोन है।
परिणामों में अक्सर Stable Diffusion की सामान्य खुरदुरे किनारे नहीं दिखते। Runway ML SD के निवेशक और शोध साझेदार हैं, और संभव है कि उन्होंने एक स्वामित्व वाला मॉडल प्रशिक्षित किया हो जो खुले स्रोत के 1.4 चेकपॉइंट वेट्स से बेहतर हो, जिनके साथ हम सभी वर्तमान में जूझ रहे हैं (जैसे कई अन्य विकास समूह, शौकीन और पेशेवर दोनों, वर्तमान में Stable Diffusion मॉडलों को प्रशिक्षित या फाइन‑ट्यून कर रहे हैं)।
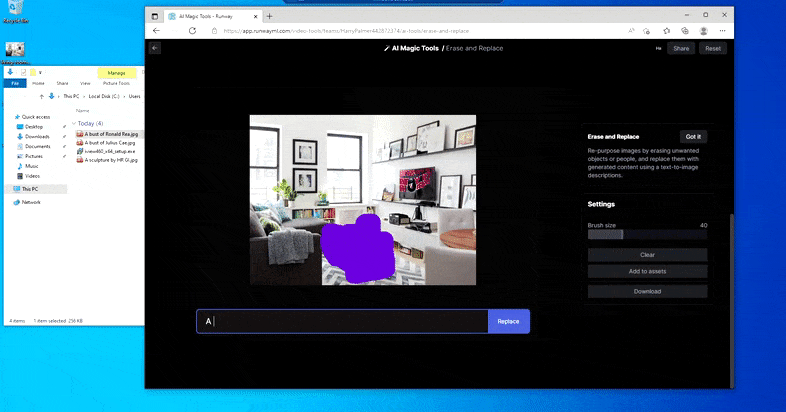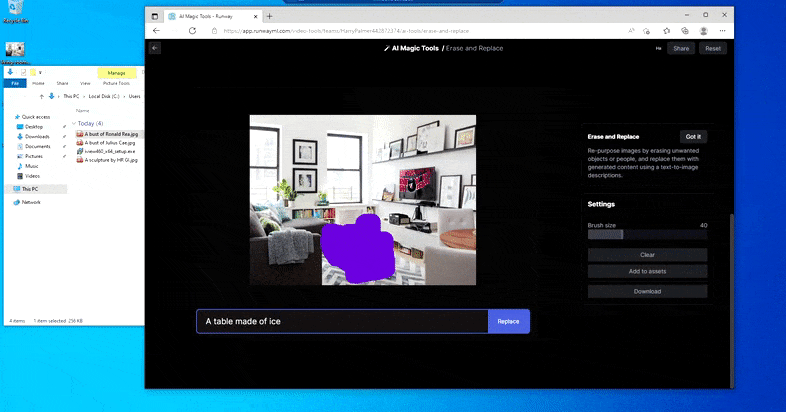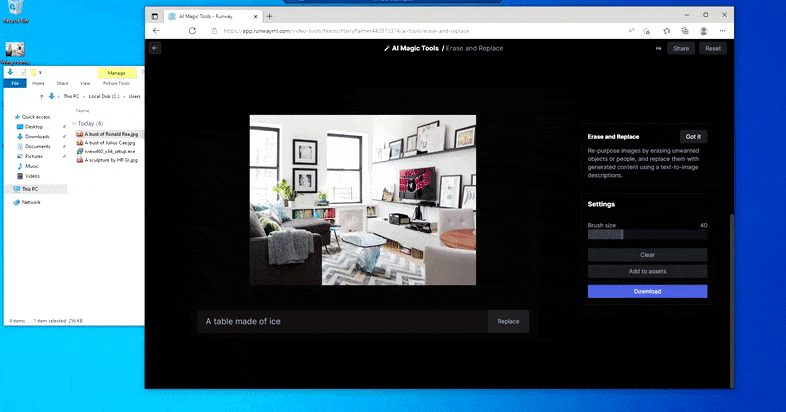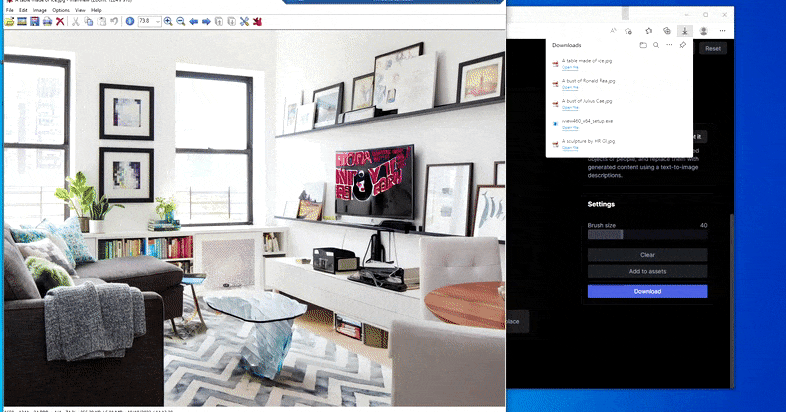
Runway ML के Erase and Replace में घरेलू मेज़ को ‘बर्फ से बनी मेज़’ से बदलना।
Imagic (नीचे देखें) की तरह, Erase and Replace भी ‘ऑब्जेक्ट‑ओरिएंटेड’ है – आप चित्र के किसी ‘खाली’ भाग को मिटा कर उसे अपने टेक्स्ट प्रॉम्प्ट के परिणाम से इनपेंट नहीं कर सकते; ऐसे में सिस्टम मास्क की दृष्टि रेखा के साथ सबसे निकटतम दिखाई देने वाले वस्तु (जैसे दीवार या टेलीविज़न) को ट्रेस करेगा और वहाँ परिवर्तन लागू करेगा।
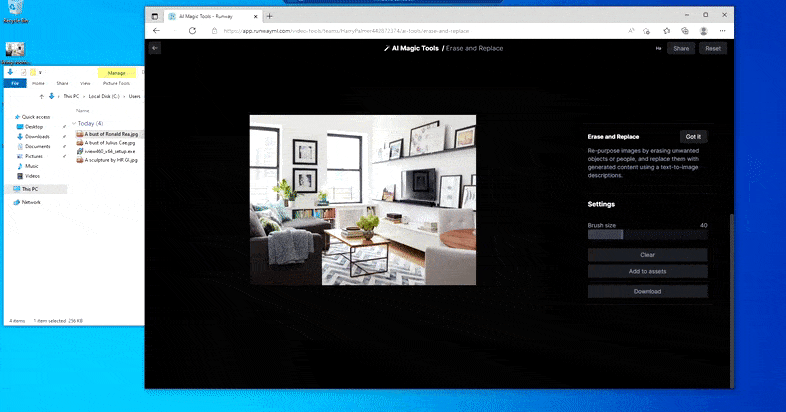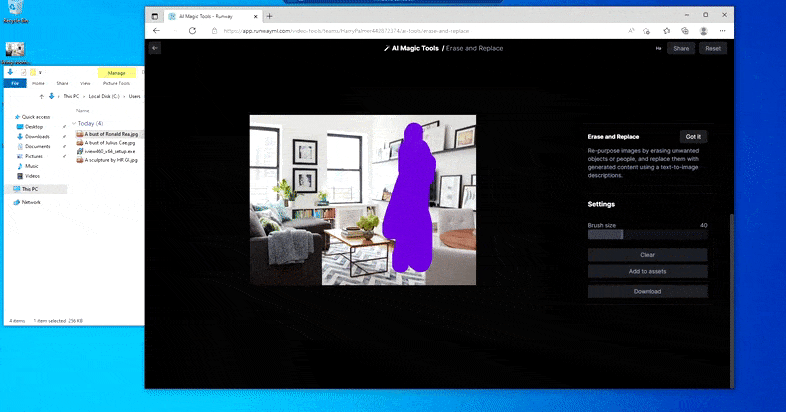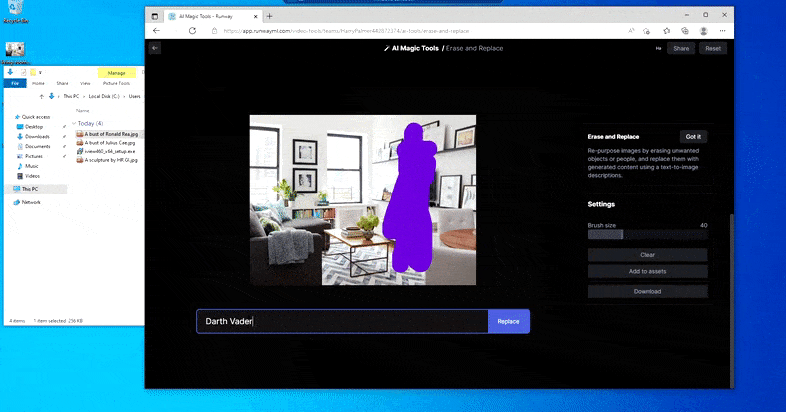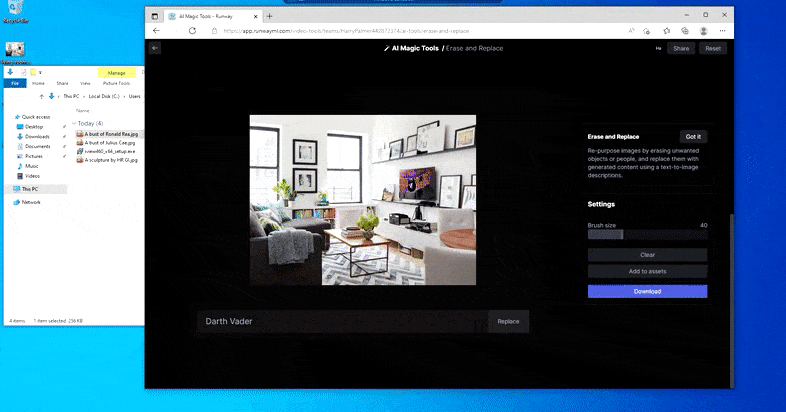
जैसा कि नाम से स्पष्ट है, Erase and Replace में आप खाली स्थान में वस्तुएँ नहीं डाल सकते। यहाँ, सबसे प्रसिद्ध सिथ लॉर्ड को बुलाने की कोशिश ने टीवी पर एक अजीब Vader‑संबंधी म्यूरल बना दिया, लगभग जहाँ ‘replace’ क्षेत्र खींचा गया था।
यह निर्धारित करना कठिन है कि Erase and Replace कॉपीराइटेड छवियों के उपयोग के संबंध में evasive (परहेज़ी) है या नहीं (जो DALL‑E 2 में अभी भी बड़े पैमाने पर प्रतिबंधित हैं, हालांकि सफलता में विविधता है), या बैकएंड रेंडरिंग इंजन में उपयोग किया जा रहा मॉडल बस उस प्रकार की चीज़ के लिए अनुकूलित नहीं है।

थोड़ा NSFW ‘Nicole Kidman की म्यूरल’ दर्शाती है कि (संभवतः) डिफ्यूज़न‑आधारित मॉडल में DALL‑E 2 की पूर्ववर्ती व्यवस्थित वास्तविक चेहरों या कामुक सामग्री को रेंडर करने से रोकने की क्षमता नहीं है, जबकि कॉपीराइटेड कार्यों को दिखाने के प्रयासों के परिणाम अस्पष्ट (‘xenomorph’) से लेकर बेतुके (‘the iron throne’) तक होते हैं। नीचे दाएँ कोने में स्रोत चित्र सम्मिलित है।
यह जानना रोचक होगा कि Erase and Replace किन तरीकों का उपयोग करके उन वस्तुओं को अलग करता है जिन्हें वह बदल सकता है। संभवतः छवि को CLIP के किसी रूपांतरण से गुजारा जा रहा है, जहाँ वस्तु पहचान और बाद की सिमैंटिक सेगमेंटेशन द्वारा अलग‑अलग आइटम पहचाने जाते हैं। इन संचालन में से कोई भी सामान्य Stable Diffusion सेटअप में इतना प्रभावी नहीं है।
परंतु कुछ भी पूर्ण नहीं है – कभी‑कभी सिस्टम केवल मिटाता है और नहीं बदलता, भले ही (जैसा कि हमने ऊपर की छवि में देखा) अंतर्निहित रेंडरिंग तंत्र स्पष्ट रूप से टेक्स्ट प्रॉम्प्ट का अर्थ समझता हो। इस स्थिति में, कॉफ़ी टेबल को xenomorph में बदलना असंभव सिद्ध होता है – बल्कि टेबल बस गायब हो जाता है।
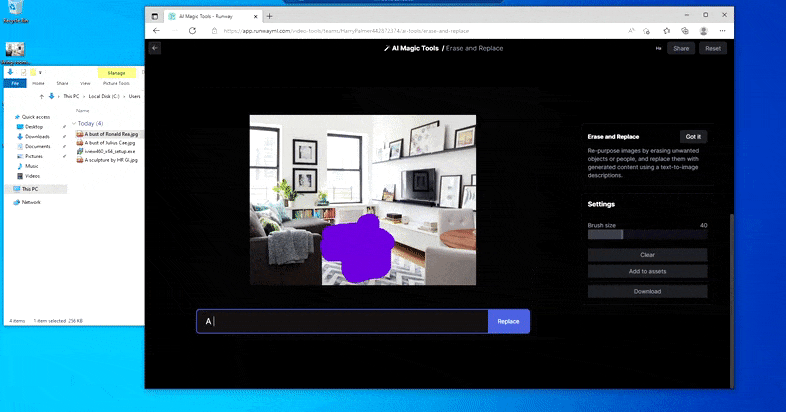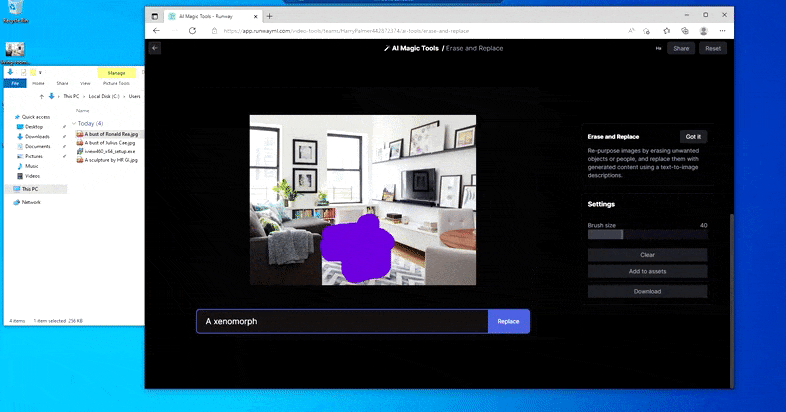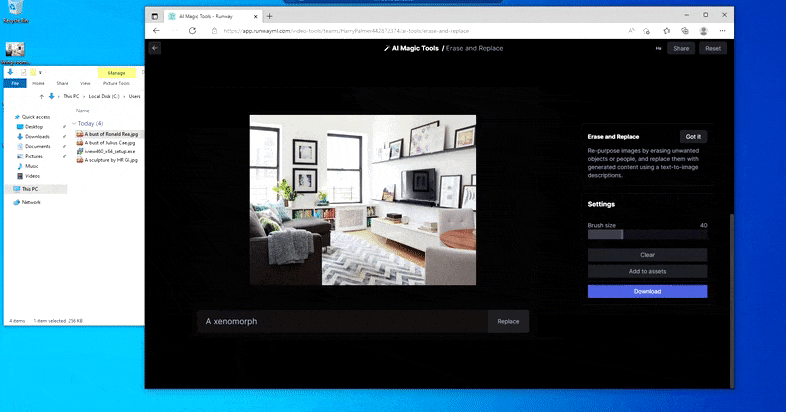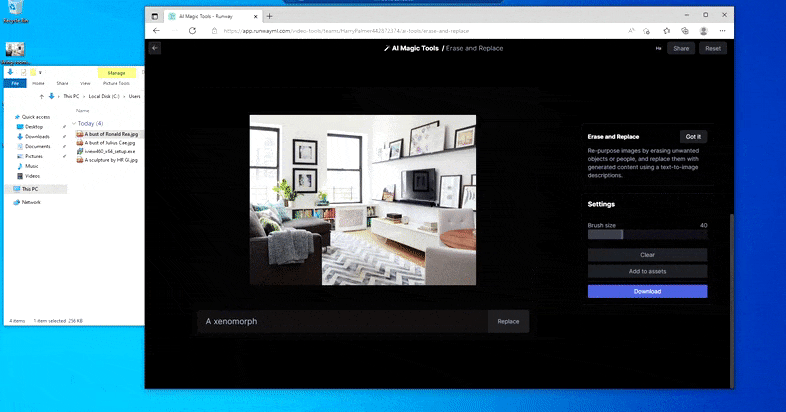
‘Where’s Waldo’ का एक अधिक डरावना संस्करण, क्योंकि Erase and Replace एक एलियन उत्पन्न करने में विफल रहता है।
Erase and Replace एक प्रभावी वस्तु प्रतिस्थापन प्रणाली प्रतीत होती है, जिसमें उत्कृष्ट इनपेंटिंग है। हालांकि, यह मौजूदा देखी गई वस्तुओं को संपादित नहीं कर सकता, केवल उन्हें बदल सकता है। मौजूदा छवि सामग्री को बिना परिवेशीय सामग्री को नुकसान पहुँचाए बदलना संभवतः बहुत कठिन कार्य है, जो लोकप्रिय फ्रेमवर्क के विभिन्न लेटेंट स्पेस में डिसेंटैंगलमेंट की दिशा में कंप्यूटर विज़न अनुसंधान क्षेत्र के लंबे संघर्ष से जुड़ा है।
Imagic
यह वह कार्य है जिसे Imagic संबोधित करता है। नया पेपर कई उदाहरण प्रस्तुत करता है जहाँ संपादन सफलतापूर्वक फोटो के व्यक्तिगत पहलुओं को बदलते हैं जबकि शेष छवि अपरिवर्तित रहती है।

Imagic में, संशोधित छवियों को उस विशिष्ट खिंचाव, विकृति और ‘ऑक्लूज़न गेसिंग’ से नहीं ग्रस्त होना पड़ता जो डीपफ़ेक पपेट्री में देखी जाती है, जहाँ केवल एक छवि से प्राप्त सीमित प्रायर्स का उपयोग किया जाता है।
सिस्टम तीन‑स्तरीय प्रक्रिया अपनाता है – टेक्स्ट एम्बेडिंग अनुकूलन; मॉडल फाइन‑ट्यूनिंग; और अंत में, संशोधित छवि का निर्माण।

Imagic लक्ष्य टेक्स्ट प्रॉम्प्ट को एन्कोड करके प्रारंभिक टेक्स्ट एम्बेडिंग प्राप्त करता है, फिर परिणाम को अनुकूलित करके इनपुट छवि बनाता है। उसके बाद, जनरेटिव मॉडल को स्रोत छवि पर फाइन‑ट्यून किया जाता है, विभिन्न पैरामीटर जोड़ते हुए, और फिर अनुरोधित इंटरपोलेशन के लिए उपयोग किया जाता है।
कोई आश्चर्य नहीं कि यह फ्रेमवर्क Google के Imagen टेक्स्ट‑टू‑वीडियो आर्किटेक्चर पर आधारित है, हालांकि शोधकर्ता बताते हैं कि सिस्टम के सिद्धांत व्यापक रूप से लेटेंट डिफ्यूज़न मॉडलों पर लागू होते हैं।
Imagen तीन‑स्तरीय आर्किटेक्चर का उपयोग करता है, जबकि कंपनी के हालिया टेक्स्ट‑टू‑वीडियो संस्करण में सात‑स्तरीय संरचना उपयोग होती है। ये तीन अलग‑अलग मॉड्यूल शामिल हैं: 64×64 पिक्सेल रिज़ॉल्यूशन पर कार्य करने वाला जनरेटिव डिफ्यूज़न मॉडल; एक सुपर‑रिज़ॉल्यूशन मॉडल जो इस आउटपुट को 256×256 पिक्सेल तक बढ़ाता है; और एक अतिरिक्त सुपर‑रिज़ॉल्यूशन मॉडल जो आउटपुट को 1024×1024 पिक्सेल तक ले जाता है।
Imagic इस प्रक्रिया के सबसे प्रारंभिक चरण में हस्तक्षेप करता है, 64px चरण पर अनुरोधित टेक्स्ट एम्बेडिंग को Adam ऑप्टिमाइज़र के साथ स्थिर लर्निंग रेट 0.0001 पर अनुकूलित करता है।

डिसेंटैंगलमेंट में एक मास्टर‑क्लास: जो अंतिम‑उपयोगकर्ता डिफ्यूज़न, GAN या NeRF मॉडल में रेंडर की गई वस्तु के रंग जैसे सरल परिवर्तन करने की कोशिश करते हैं, वे जानेंगे कि Imagic इन रूपांतरणों को बिना छवि की शेष स्थिरता को ‘फाड़े’ कैसे कर सकता है, यह कितना महत्वपूर्ण है।
फाइन‑ट्यूनिंग तब Imagen के बेस मॉडल पर किया जाता है, प्रत्येक इनपुट छवि के लिए 1500 चरणों के लिए, संशोधित एम्बेडिंग के आधार पर। साथ ही, द्वितीयक 64px>256px लेयर को समानांतर रूप से कंडीशन की गई छवि पर अनुकूलित किया जाता है। शोधकर्ता नोट करते हैं कि अंतिम 256px>1024px लेयर के लिए समान अनुकूलन का ‘थोड़ा या कोई प्रभाव नहीं’ पड़ता, इसलिए इसे लागू नहीं किया गया है।
पेपर में कहा गया है कि अनुकूलन प्रक्रिया प्रत्येक छवि के लिए द्वि-TPUV4 चिप्स पर लगभग आठ मिनट लेती है। अंतिम रेंडर कोर Imagen में DDIM सैंपलिंग स्कीम के तहत किया जाता है।
Google के DreamBooth जैसी समान फाइन‑ट्यूनिंग प्रक्रियाओं के समान, प्राप्त एम्बेडिंग्स का उपयोग स्टाइलाइज़ेशन के साथ-साथ फोटोरियलिस्टिक संपादन के लिए भी किया जा सकता है, जिसमें Imagen को शक्ति देने वाले व्यापक अंतर्निहित डेटाबेस से निकाली गई जानकारी शामिल होती है (क्योंकि, नीचे पहले कॉलम में दिखाया गया है, स्रोत छवियों में इन रूपांतरणों के लिए आवश्यक सामग्री नहीं है)।

Imagic के माध्यम से लचीली फोटोरियलिस्टिक गति और संपादन प्राप्त किए जा सकते हैं, जबकि प्रक्रिया में प्राप्त किए गए व्युत्पन्न और डिसेंटैंगल्ड कोड्स को स्टाइलाइज़्ड आउटपुट के लिए भी आसानी से उपयोग किया जा सकता है।
शोधकर्ताओं ने Imagic की तुलना पूर्व कार्यों SDEdit (2021 का GAN‑आधारित दृष्टिकोण, Stanford University और Carnegie Mellon University के सहयोग से) और Text2Live (अप्रैल 2022 में Weizmann Institute of Science और NVIDIA के सहयोग से) से की।

Imagic, SDEdit और Text2Live के बीच एक दृश्य तुलना।
स्पष्ट है कि पूर्ववर्ती दृष्टिकोण संघर्ष कर रहे हैं, लेकिन नीचे की पंक्ति में, जहाँ बड़ी पोज़ परिवर्तन का समावेश है, मौजूदा विधियाँ स्रोत सामग्री को पुनः निर्मित करने में पूरी तरह विफल रहती हैं, जबकि Imagic ने उल्लेखनीय सफलता हासिल की है।
Imagic की संसाधन आवश्यकताएँ और प्रति छवि प्रशिक्षण समय, इस प्रकार के कार्यों के मानकों के मुकाबले छोटा है, फिर भी यह व्यक्तिगत कंप्यूटर पर स्थानीय छवि संपादन एप्लिकेशन में शामिल होने की संभावना कम है – और यह स्पष्ट नहीं है कि फाइन‑ट्यूनिंग प्रक्रिया को उपभोक्ता स्तर तक कितना घटाया जा सकता है।
वर्तमान में, Imagic एक प्रभावशाली प्रस्ताव है जो अधिकतर API के लिए उपयुक्त है – ऐसा वातावरण जिसमें Google Research, डीपफ़ेक को सुविधाजनक बनाने के संबंध में आलोचना से बचता है, संभवतः सबसे आरामदायक हो सकता है।
पहली बार प्रकाशित 18 अक्टूबर 2022।


