
Anderson का एंगल
मशीन लर्निंग से वीडियो में वस्तुओं को अधिक कुशलता से हटाना

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
मुख्य बिंदुE2FGVI तीन वीडियो इनपेंटिंग चरणों को एक एंड-टू-एंड सिस्टम में एकीकृत करता है, जिससे…
और देखें
- E2FGVI तीन वीडियो इनपेंटिंग चरणों को एक एंड-टू-एंड सिस्टम में एकीकृत करता है, जिससे प्रमुख दक्षता लाभ प्राप्त होते हैं।
- यह सिस्टम पिछले ऑप्टिकल फ्लो विधियों की तुलना में पंद्रह गुना तेज चलता है, साथ ही अत्याधुनिक परिणाम प्राप्त करता है।
- एक नवीन टेम्पोरल फोकल ट्रांसफॉर्मर 2D से 3D तक ध्यान का विस्तार करता है, जिससे फ्रेम्स में सुसंगत कंटेंट हेलुसिनेशन संभव होता है।
चीन से नए शोध में अत्याधुनिक स्तर के परिणामों की सूचना दी गई है, साथ ही साथ एक नए वीडियो इनपेंटिंग सिस्टम के लिए दक्षता में एक प्रभावशाली सुधार, जो वीडियो से वस्तुओं को हटाने में सक्षम है।
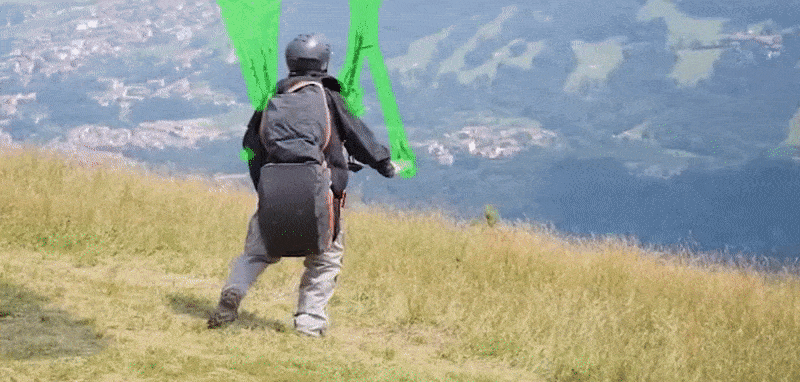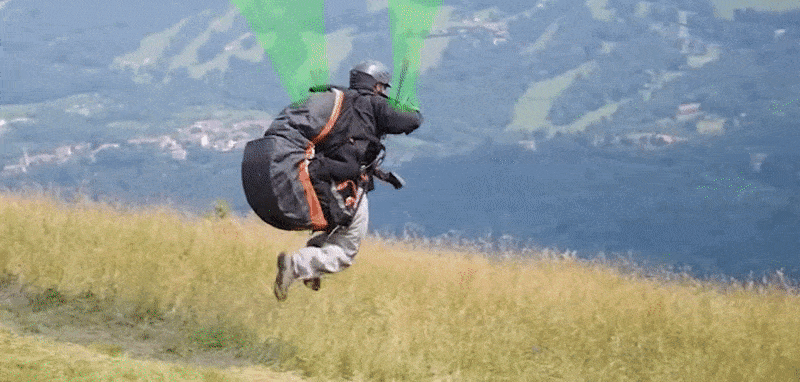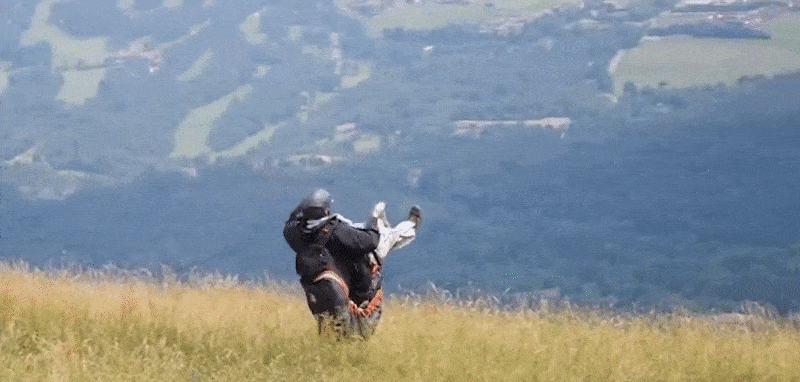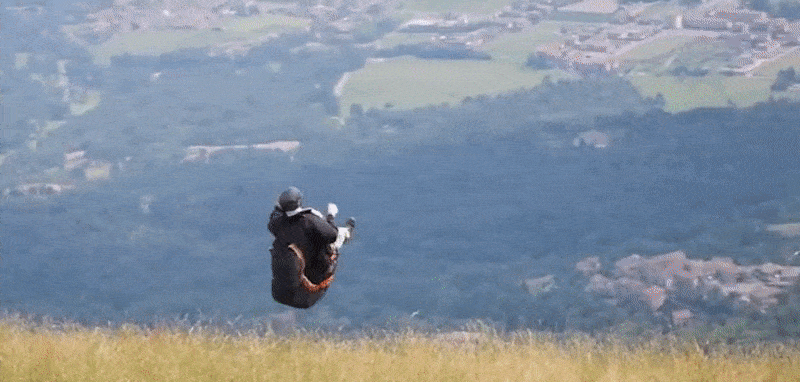
एक हैंग-ग्लाइडर पायलट का हार्नेस नई प्रक्रिया से चित्र से मिटा दिया गया है। बेहतर रिज़ॉल्यूशन और अधिक उदाहरणों के लिए स्रोत वीडियो देखें। स्रोत: https://www.youtube.com/watch?v=N–qC3T2wc4
इस तकनीक, जिसे एंड-टू-एंड फ्रेमवर्क फॉर फ्लो-गाइडेड वीडियो इनपेंटिंग (ई2एफजीवीआई) कहा जाता है, वीडियो सामग्री से वॉटरमार्क और विभिन्न प्रकार के ओक्लूजन को हटाने में भी सक्षम है।
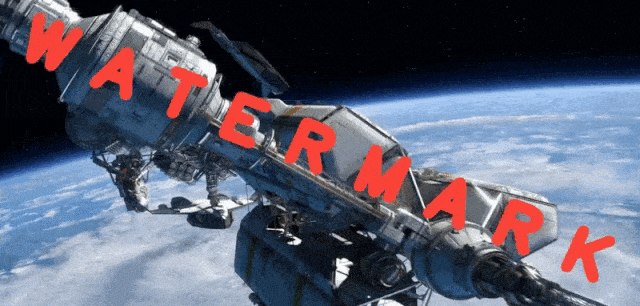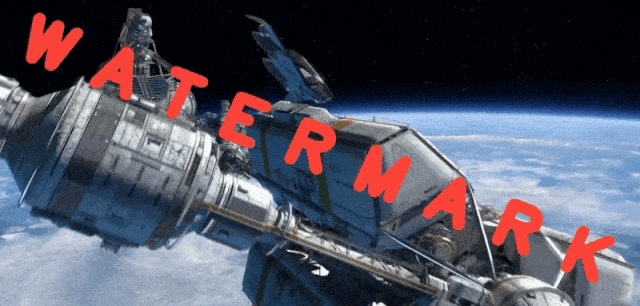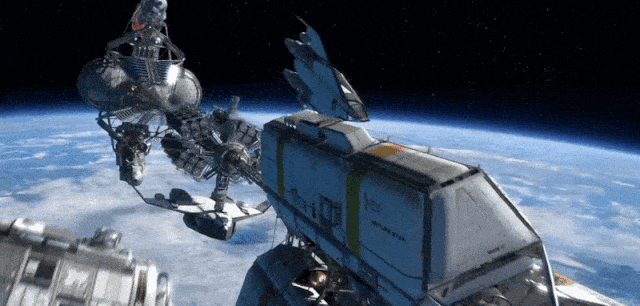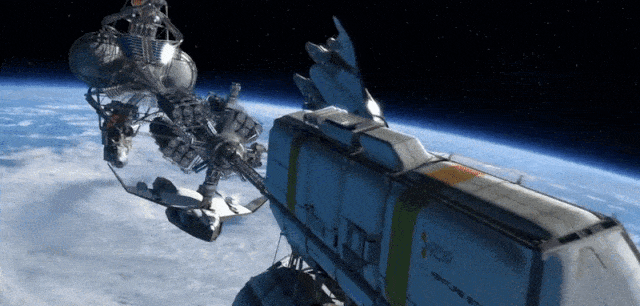
ई2एफजीवीआई ओक्लूजन के पीछे सामग्री के लिए भविष्यवाणियां गणना करता है, जो यहां तक कि उल्लेखनीय और दुर्गम वॉटरमार्क को हटाने की अनुमति देता है। स्रोत: https://github.com/MCG-NKU/E2FGVI
(बेहतर रिज़ॉल्यूशन में अधिक उदाहरण देखने के लिए वीडियो देखें)
हालांकि प्रकाशित पत्र में उल्लिखित मॉडल को 432px x 240px वीडियो (आम तौर पर कम इनपुट आकार, उपलब्ध जीपीयू मेमोरी, इष्टतम बैच आकार और अन्य कारकों के बीच संतुलन के कारण सीमित) पर प्रशिक्षित किया गया था, लेखकों ने ई2एफजीवीआई-एचक्यू जारी किया है, जो किसी भी रिज़ॉल्यूशन वाले वीडियो को संभाल सकता है।
वर्तमान संस्करण के लिए कोड गिटहब पर उपलब्ध है, जबकि एचक्यू संस्करण, जो पिछले रविवार को जारी किया गया था, गूगल ड्राइव और बायडू डिस्क से डाउनलोड किया जा सकता है।

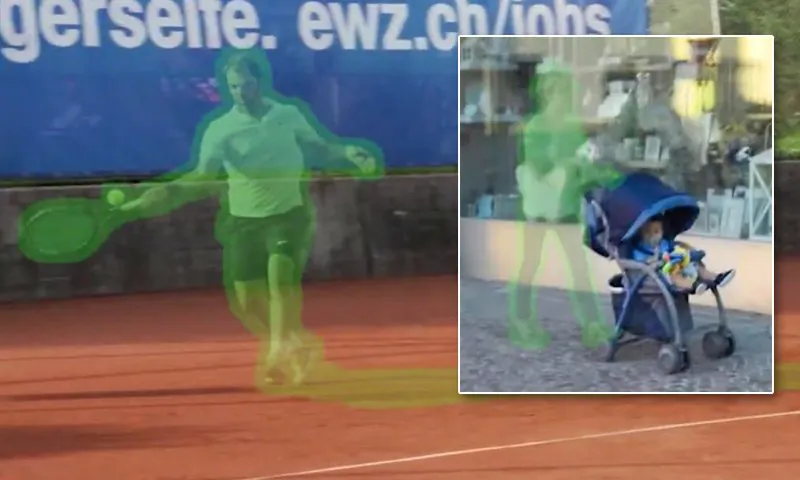
बच्चा तस्वीर में रहता है।
ई2एफजीवीआई 432×240 वीडियो को 0.12 सेकंड प्रति फ्रेम पर एक टाइटन एक्सपी जीपीयू (12GB वीआरएएम) पर प्रोसेस कर सकता है, और लेखकों का कहना है कि सिस्टम ऑप्टिकल फ्लो पर आधारित पिछले अत्याधुनिक तरीकों की तुलना में पंद्रह गुना तेजी से चलता है।
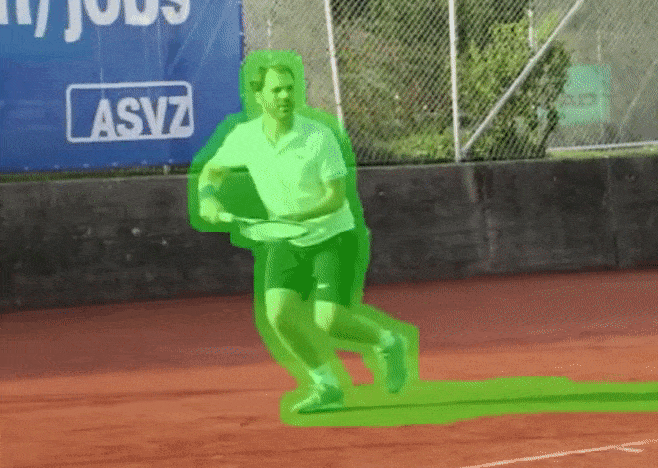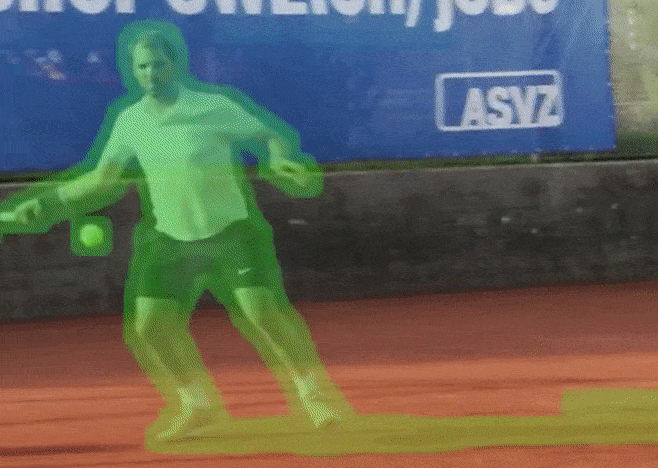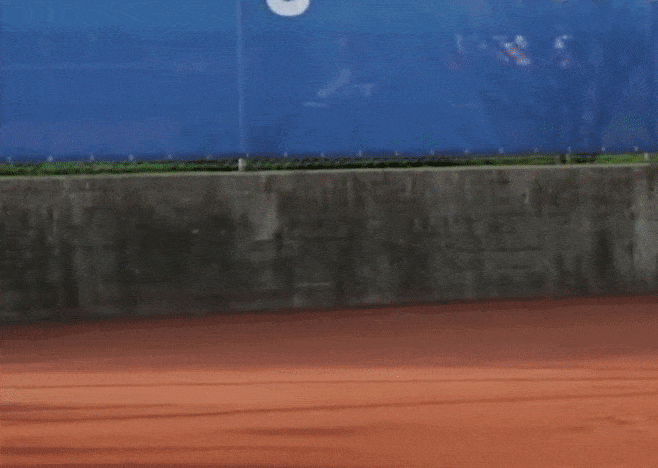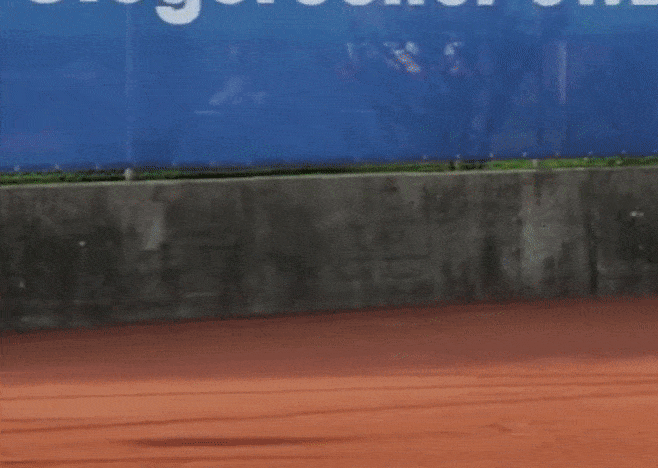
एक टेनिस खिलाड़ी अप्रत्याशित रूप से बाहर निकलता है।
वीडियो इनपेंटिंग अनुसंधान के इस उप-क्षेत्र के लिए मानक डेटासेट पर परीक्षण किए जाने पर, नई विधि ने गुणात्मक और मात्रात्मक मूल्यांकन दौरों में प्रतिद्वंद्वियों को पीछे छोड़ दिया।

पिछले दृष्टिकोणों के खिलाफ परीक्षण। स्रोत: https://arxiv.org/pdf/2204.02663.pdf
इस पत्र का शीर्षक फ्लो-गाइडेड वीडियो इनपेंटिंग के लिए एक एंड-टू-एंड फ्रेमवर्क की ओर है, और यह नांकाई विश्वविद्यालय के चार शोधकर्ताओं के बीच एक सहयोग है, साथ ही हिसिलिकॉन टेक्नोलॉजीज के एक शोधकर्ता के साथ।
इस तस्वीर में क्या गायब है
इसके स्पष्ट अनुप्रयोगों के अलावा दृश्य प्रभावों के लिए, उच्च गुणवत्ता वाला वीडियो इनपेंटिंग नए एआई-आधारित छवि संश्लेषण और छवि-परिवर्तन प्रौद्योगिकियों की एक मुख्य विशेषता बनने के लिए तैयार है।
यह विशेष रूप से शरीर-परिवर्तन फैशन अनुप्रयोगों के मामले में है, और अन्य फ्रेमवर्क जो छवियों और वीडियो में दृश्यों को ‘पतला’ करने या अन्यथा बदलने का प्रयास करते हैं। ऐसे मामलों में, यह आवश्यक है कि संश्लेषण द्वारा उजागर किए गए अतिरिक्त पृष्ठभूमि को विश्वसनीय ढंग से ‘भरना’ है।

एक हालिया पत्र से, एक शरीर ‘पुनर्गठन’ एल्गोरिदम को व्यक्ति का आकार बदलने पर नई उजागर हुई पृष्ठभूमि को इनपेंट करने का काम सौंपा गया है। यहाँ कमी को उस लाल रूपरेखा से दिखाया गया है जहाँ वास्तविक जीवन का अधिक भरे हुए शरीर वाला व्यक्ति पहले था (बाईं छवि देखें)। स्रोत सामग्री से https://arxiv.org/pdf/2203.10496.pdf
सुसंगत ऑप्टिकल फ्लो
ऑप्टिकल फ्लो (ओएफ) वीडियो ऑब्जेक्ट रिमूवल के विकास में एक मुख्य प्रौद्योगिकी बन गया है। जैसे कि एक अटलस, ओएफ एक समय क्रम के लिए एक एकल मानचित्र प्रदान करता है। अक्सर कंप्यूटर विजन पहलों में वेग को मापने के लिए उपयोग किया जाता है, ओएफ समय के साथ सुसंगत इन-पेंटिंग को भी सक्षम कर सकता है, जहां कार्य का समग्र योग एक ही पास में माना जा सकता है, न कि डिज़नी शैली के ‘प्रति-फ्रेम’ ध्यान के बजाय, जो अनिवार्य रूप से समयिक विचलन की ओर ले जाता है।
अब तक के वीडियो इनपेंटिंग तरीकों ने तीन-चरण प्रक्रिया पर केंद्रित किया है: फ्लो पूर्णता, जहां वीडियो मूल रूप से एक अलग और अन्वेषण योग्य इकाई में मैप किया जाता है; पिक्सेल प्रोपेगेशन, जहां ‘दूषित’ वीडियो में छेद द्विदिशात्मक रूप से प्रसारित पिक्सेल द्वारा भरे जाते हैं; और सामग्री हॉलुसिनेशन (पिक्सेल ‘आविष्कार’ जो अधिकांश लोगों के लिए डीपफेक्स और टेक्स्ट-टू-इमेज फ्रेमवर्क जैसे डीएलएल-ई श्रृंखला से परिचित है) जहां अनुमानित ‘गुम’ सामग्री का आविष्कार किया जाता है और फुटेज में डाला जाता है।
ई2एफजीवीआई की केंद्रीय नवाचार है इन तीन चरणों को एक एंड-टू-एंड सिस्टम में मिलाना, जिससे सामग्री या प्रक्रिया पर मैनुअल ऑपरेशन करने की आवश्यकता समाप्त हो जाती है।

इस पत्र में यह देखा गया है कि मैनुअल हस्तक्षेप की आवश्यकता के कारण पुरानी प्रक्रियाएं जीपीयू का लाभ नहीं उठा पाती हैं, जिससे वे बहुत समय लेने वाली हो जाती हैं। पत्र से*:
‘DFVI को एक उदाहरण के रूप में लेते हुए, DAVIS से लिए गए लगभग 70 फ़्रेम वाले 432 × 240 आकार के एक वीडियो को पूरा करने में लगभग 4 मिनट लगते हैं, जो कि अधिकांश वास्तविक दुनिया के अनुप्रयोगों में अस्वीकार्य है। इसके अलावा, उपरोक्त उल्लिखित खामियों के अलावा, केवल सामग्री हॉलुसिनेशन चरण में एक पूर्व-प्रशिक्षित छवि इनपेंटिंग नेटवर्क का उपयोग करना समयिक पड़ोसियों के साथ सामग्री संबंधों की अनदेखी करता है, जिससे वीडियो में असंगत उत्पन्न सामग्री होती है।’
ई2एफजीवीआई द्वारा वीडियो इनपेंटिंग के तीन चरणों को एकजुट करके, यह दूसरे चरण, पिक्सेल प्रोपेगेशन को फीचर प्रोपेगेशन से बदलने में सक्षम है। पिछले कार्यों की अधिक खंडित प्रक्रियाओं में, विशेषताएं इतनी व्यापक रूप से उपलब्ध नहीं हैं, क्योंकि प्रत्येक चरण अपेक्षाकृत हेरमेटिक है, और कार्यप्रवाह केवल अर्ध-स्वचालित है।
इसके अलावा, शोधकर्ताओं ने सामग्री हॉलुसिनेशन चरण के लिए एक समय-आधारित फोकल ट्रांसफॉर्मर का आविष्कार किया है, जो केवल वर्तमान फ्रेम में पिक्सेल के सीधे पड़ोसियों (अर्थात् पिछले या अगले चित्र में फ़्रेम के उस भाग में क्या हो रहा है) पर विचार नहीं करता है, बल्कि दूर के पड़ोसियों को भी जो कई फ्रेम दूर हैं और फिर भी वीडियो के संपूर्ण प्रभाव को प्रभावित करेंगे।

ई2एफजीवीआई की वास्तुकला।
नई विशेषता-आधारित केंद्रीय अनुभाग कार्यप्रवाह का लाभ उठाने में सक्षम है और अधिक विशेषता-स्तर की प्रक्रियाओं और सीखने योग्य नमूना ऑफसेट का लाभ उठा सकता है, जबकि परियोजना के नए फोकल ट्रांसफॉर्मर, लेखकों के अनुसार, फोकल विंडो के आकार को ‘2डी से 3डी’ तक बढ़ाता है।
परीक्षण और डेटा
ई2एफजीवीआई का परीक्षण करने के लिए, शोधकर्ताओं ने इस प्रणाली का मूल्यांकन दो लोकप्रिय वीडियो ऑब्जेक्ट सेगमेंटेशन डेटासेट पर किया: यूट्यूब-वीओएस, और डीएवीआईएस. यूट्यूब-वीओएस में 3741 प्रशिक्षण वीडियो क्लिप, 474 सत्यापन क्लिप, और 508 परीक्षण क्लिप हैं, जबकि डीएवीआईएस में 60 प्रशिक्षण वीडियो क्लिप, और 90 परीक्षण क्लिप हैं।
ई2एफजीवीआई को यूट्यूब-वीओएस पर प्रशिक्षित किया गया था और दोनों डेटासेट पर मूल्यांकन किया गया था। प्रशिक्षण के दौरान, वस्तु मास्क (ऊपर दी गई छवियों में हरे क्षेत्र, और साथी यूट्यूब वीडियो) को वीडियो पूर्णता का अनुकरण करने के लिए उत्पन्न किया गया था।
मेट्रिक्स के लिए, शोधकर्ताओं ने पीक सिग्नल-टू-शोर रेशियो (पीएसएनआर), संरचनात्मक समानता (एसएसआईएम), वीडियो-आधारित फ्रेचेट इन्सेप्शन दूरी (वीएफआईडी), और फ्लो वार्पिंग त्रुटि को अपनाया, जो प्रभावित वीडियो में समयिक स्थिरता को मापने के लिए है।
पिछले आर्किटेक्चर जिनके खिलाफ सिस्टम का परीक्षण किया गया था, वे थे वीआईनेट, डीएफवीआई, एलजीटीएसएम, सीएपी, एफजीवीसी, एसटीटीएन, और फ्यूजफॉर्मर.

पत्र के मात्रात्मक परिणाम अनुभाग से। ऊपर और नीचे की तीरें संकेत देती हैं कि उच्च या निम्न संख्याएं बेहतर हैं। ई2एफजीवीआई बोर्ड भर में सर्वश्रेष्ठ स्कोर प्राप्त करता है। तरीकों का मूल्यांकन फ्यूजफॉर्मर के अनुसार किया जाता है, हालांकि डीएफवीआई, वीआईनेट और एफजीवीसी एंड-टू-एंड सिस्टम नहीं हैं, जिससे उनके फ्लॉप्स का अनुमान लगाना असंभव हो जाता है।
सभी प्रतिस्पर्धी प्रणालियों के खिलाफ सर्वश्रेष्ठ स्कोर प्राप्त करने के अलावा, शोधकर्ताओं ने एक गुणात्मक उपयोगकर्ता अध्ययन भी किया, जिसमें पांच प्रतिनिधि तरीकों के साथ परिवर्तित वीडियो को बीस स्वयंसेवकों को व्यक्तिगत रूप से दिखाया गया, जिन्हें दृश्य गुणवत्ता के संदर्भ में उन्हें रेट करने के लिए कहा गया था।

उपयोगकर्ता अध्ययन में भाग लेने वाले प्रतिभागियों का प्रतिशत ई2एफजीवीआई आउटपुट को दृश्य गुणवत्ता के संदर्भ में पसंद करता है।
लेखकों का उल्लेख है कि उनके तरीके के लिए सर्वसम्मत पसंद के बावजूद, परिणामों में से एक, एफजीवीसी, मात्रात्मक परिणामों को प्रतिबिंबित नहीं करता है, और वे सुझाव देते हैं कि यह इंगित करता है कि ई2एफजीवीआई संभवतः भ्रामक ढंग से ‘देखने में अधिक सुखद परिणाम’ उत्पन्न कर सकता है।
दक्षता के संदर्भ में, लेखकों का उल्लेख है कि उनकी प्रणाली डीएवीआईएस डेटासेट पर एक एकल टाइटन जीपीयू पर फ्लोटिंग पॉइंट ऑपरेशन प्रति सेकंड (फ्लॉप्स) और अनुमान समय को काफी कम कर देती है, और परिणामों से पता चलता है कि ई2एफजीवीआई फ्लो-आधारित तरीकों की तुलना में पंद्रह गुना तेजी से चलता है।
वे टिप्पणी करते हैं:
‘[ई2एफजीवीआई] सभी अन्य तरीकों की तुलना में सबसे कम फ्लॉप्स रखता है। यह दर्शाता है कि प्रस्तावित तरीका वीडियो इनपेंटिंग के लिए अत्यधिक कुशल है।’
*लेखकों के इनलाइन उद्धरणों को हाइपरलिंक में परिवर्तित करने के लिए मेरा रूपांतरण।
पहली बार 19 मई 2022 को प्रकाशित।
मंगलवार 28 अक्टूबर 2025 को संशोधित, दोषपूर्ण वीडियो एम्बेड को हटाने और लेख के मुख्य पाठ में एम्बेडेड वीडियो के संदर्भों को संशोधित करने के लिए।


