
Anderson का एंगल
संगत एआई वीडियो सामग्री संपादन टेक्स्ट-निर्देशित इनपुट के साथ

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
मुख्य बिंदुText2Live टेक्स्ट प्रॉम्प्ट से प्रति-फ्रेम प्रोसेसिंग के बिना सुसंगत वीडियो संपादन…
और देखें
- Text2Live टेक्स्ट प्रॉम्प्ट से प्रति-फ्रेम प्रोसेसिंग के बिना सुसंगत वीडियो संपादन सक्षम करता है।
- सिस्टम एक न्यूरल लेयर्ड एटलस का उपयोग करके पूरे वीडियो टाइमलाइन पर एक बार संपादन लागू करता है।
- Text2Live मास्किंग और कंपोज़िटिंग को स्वचालित करता है, जिससे रोटोस्कोपिंग या ग्रीन स्क्रीन की आवश्यकता समाप्त हो जाती है।
व्यावसायिक वीएफएक्स समुदाय नए नवाचारों से आकर्षित होता है – और कभी-कभी छवि और वीडियो सिंथेसिस में खतरा महसूस करता है, लेकिन अधिकांश एआई-आधारित वीडियो संपादन परियोजनाओं में समयिक निरंतरता की कमी उन्हें मतिभ्रम-जैसे दृश्य प्रभावों के क्षेत्र में सीमित कर देती है, जिसमें चमकते और तेजी से बदलते टेक्सचर और संरचनाएं, असंगत प्रभाव और प्रकार की क्रूड प्रौद्योगिकी-प्रबंधन होती है जो फोटोकेमिकल युग की याद दिलाती है।
यदि आप किसी वीडियो में कुछ विशिष्ट बदलना चाहते हैं जो डीपफेक (यानी, किसी व्यक्ति की मौजूदा फुटेज पर एक नई पहचान थोपा) के क्षेत्र में नहीं आता है, तो अधिकांश वर्तमान समाधान उत्पादन-गुणवत्ता वाले दृश्य प्रभावों के लिए आवश्यक सटीकता के संदर्भ में काफी सख्त सीमाओं के तहत संचालित होते हैं।
एक अपवाद विज़मैन इंस्टीट्यूट ऑफ साइंस के एक ढीले संघ के शोधकर्ताओं का चल रहा काम है। 2021 में, इसके तीन शोधकर्ताओं ने, एडोबी के साथ मिलकर, घोषणा की एक नई विधि के लिए वीडियो को विभाजित करने और एक सुसंगत आंतरिक मानचित्र – एक परतदार तंत्रिका मानचित्र – को एक संयुक्त आउटपुट में शामिल करने के लिए, जिसमें अल्फा चैनल और समयिक रूप से संगत आउटपुट शामिल हैं।
(ADBE )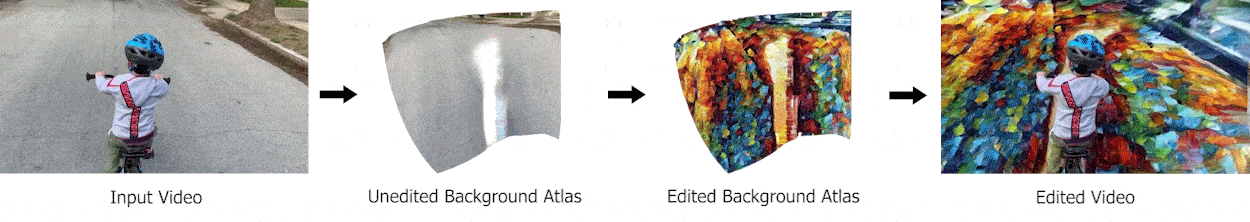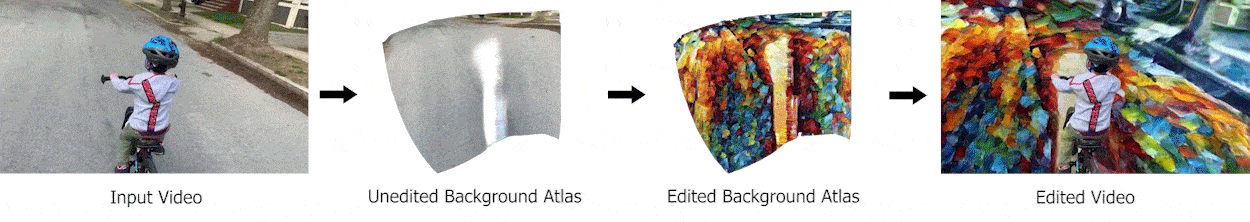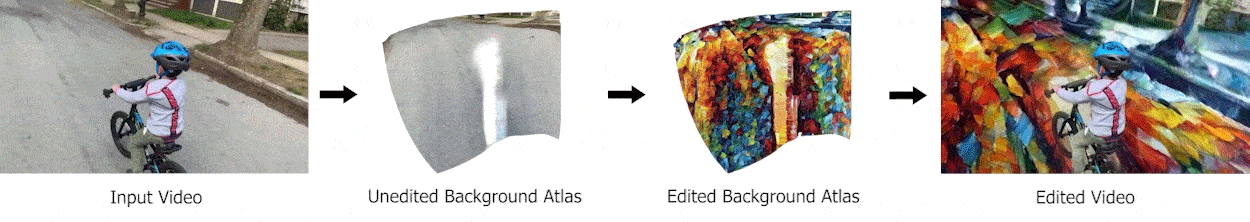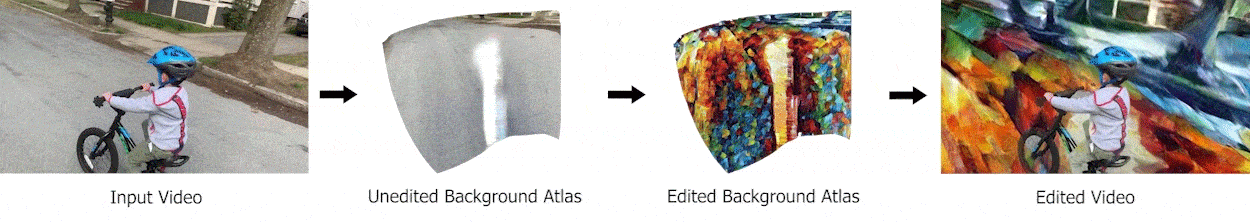
2021 के पेपर से: स्रोत क्लिप में सड़क के पूर्ण पारगमन का एक अनुमान तंत्रिका नेटवर्क द्वारा संपादित किया गया है जिस तरह से पारंपरिक रूप से व्यापक रोटोस्कोपिंग और मैच-मूविंग की आवश्यकता होगी। चूंकि पृष्ठभूमि और अग्रभूमि तत्व अलग-अलग नेटवर्क द्वारा संभाले जाते हैं, मास्क वास्तव में ‘स्वचालित’ हैं। स्रोत: https://layered-neural-atlases.github.io/
हालांकि यह वीएफएक्स पाइपलाइनों में ऑप्टिकल फ्लो द्वारा कवर किए गए क्षेत्र में कहीं गिरता है, परतदार मानचित्र में पारंपरिक सीजीआई कार्य प्रवाह में कोई सीधा समकक्ष नहीं है, क्योंकि यह मूल रूप से एक ‘कालिक बनावट मानचित्र’ का गठन करता है जिसे पारंपरिक सॉफ्टवेयर विधियों से बनाया और संपादित किया जा सकता है। ऊपर के चित्रण की दूसरी छवि में सड़क की सतह की पृष्ठभूमि को प्रतीकात्मक रूप से वीडियो की पूरी अवधि में दर्शाया गया है। इस मूल छवि को बदलने से—जो चित्रण में बाईं ओर से तीसरी छवि है—पृष्ठभूमि में एक समान बदलाव होता है।
उपरोक्त चित्रण में ‘अनफोल्ड’ मानचित्र केवल व्यक्तिगत व्याख्या किए गए फ्रेम का प्रतिनिधित्व करते हैं; लक्ष्य वीडियो फ्रेम में संगत परिवर्तन वापस मूल फ्रेम में मैप किए जाते हैं, जिसमें आवश्यक ओक्लूजन और अन्य आवश्यक दृश्य प्रभाव शामिल होते हैं, जैसे कि छाया या परावर्तन।
मूल वास्तुकला एक मल्टीलेयर परसेप्ट्रॉन (एमएलपी) का उपयोग खोले गए एटलसों, अल्फा चैनलों और मैपिंगों का प्रतिनिधित्व करने के लिए करती है, जो सभी 2डी स्थान में पूरी तरह से अनुकूलित होते हैं, जो 3डी ज्यामिति बिंदुओं, गहराई मानचित्रों और NeRF-जैसे पूर्व ज्ञान और समान सीजीआई संरचनाओं की आवश्यकता को समाप्त करते हैं।
व्यक्तिगत वस्तुओं के संदर्भ मानचित्र को भी विश्वसनीय रूप से बदला जा सकता है:
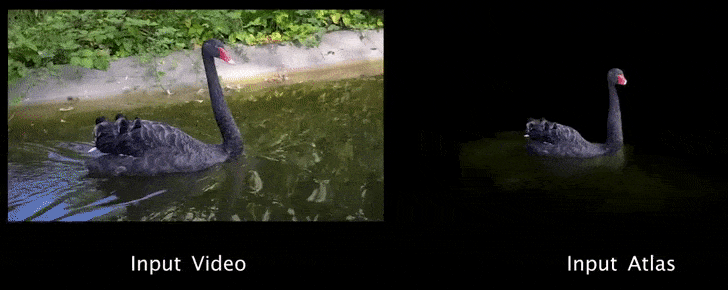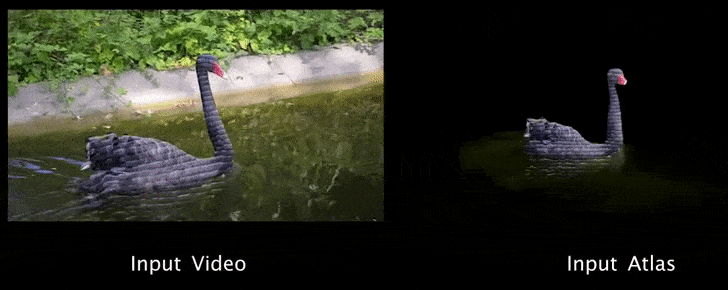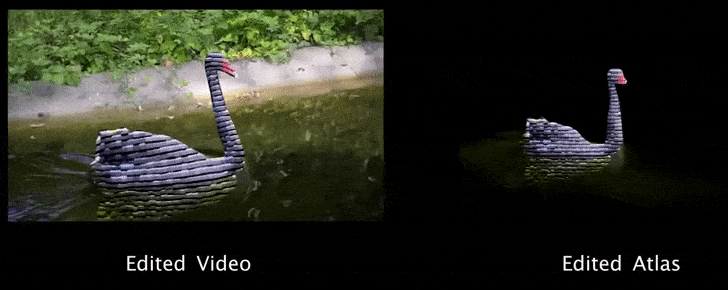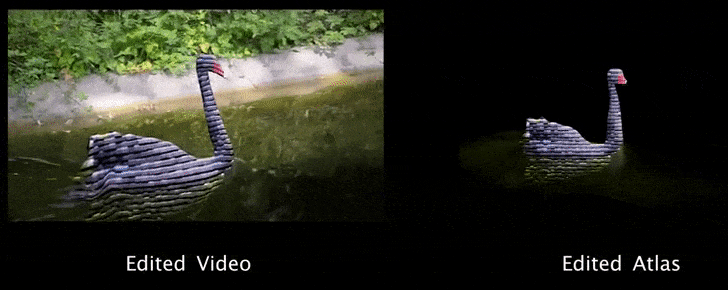
2021 के फ्रेमवर्क के तहत एक चलती वस्तु में संगत परिवर्तन। स्रोत: https://www.youtube.com/watch?v=aQhakPFC4oQ
मूल रूप से, 2021 प्रणाली ज्यामितीय संरेखण, मैच-मूविंग, मानचित्रण, पुनः-टेक्सचराइजेशन और रोटोस्कोपिंग को एक विच्छिन्न तंत्रिका प्रक्रिया में जोड़ती है।
Text2Live
2021 के पेपर के तीन मूल शोधकर्ता, NVIDIA (NVDA ) शोध के साथ मिलकर, एक नए नवाचार में योगदानकर्ता हैं जो परतदार मानचित्रों की शक्ति को उस प्रकार के टेक्स्ट-निर्देशित CLIP प्रौद्योगिकी के साथ जोड़ती है जो इस सप्ताह OpenAI के DALL-E 2 फ्रेमवर्क की रिलीज के साथ प्रमुखता में वापस आया है।
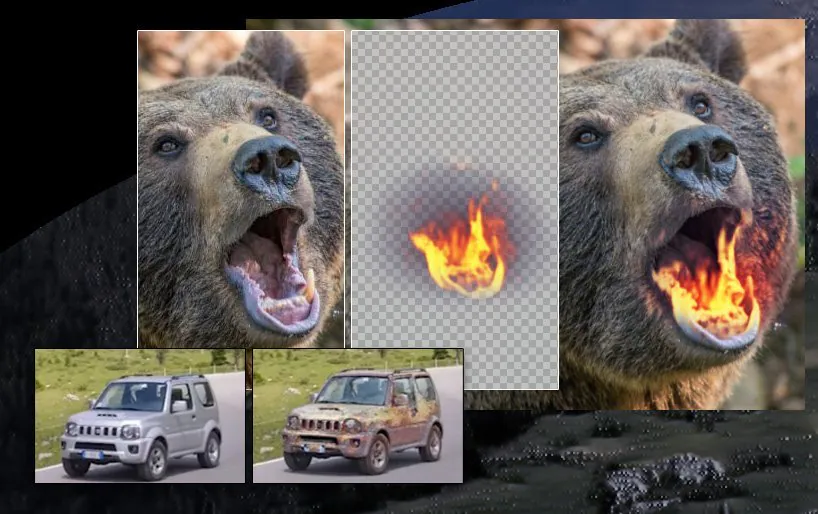
नई वास्तुकला, जिसे Text2Live कहा जाता है, एक अंतिम उपयोगकर्ता को टेक्स्ट प्रोम्प्ट के आधार पर वास्तविक वीडियो सामग्री में स्थानीय संपादन बनाने की अनुमति देती है:
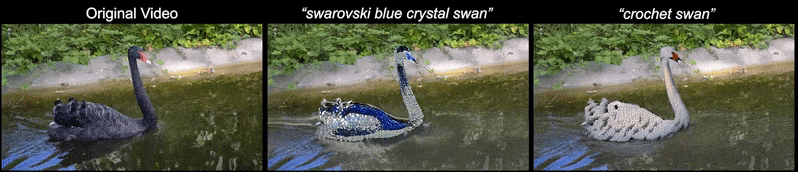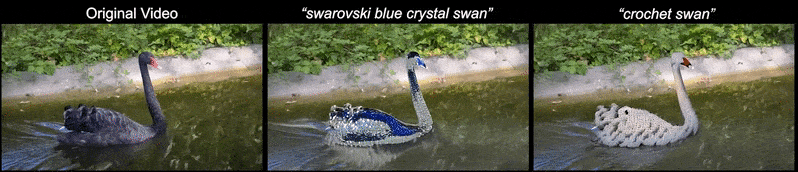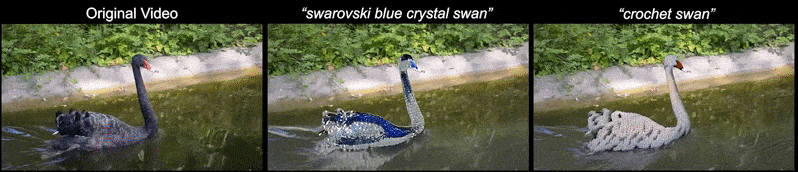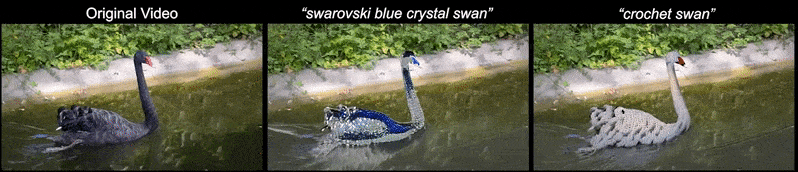
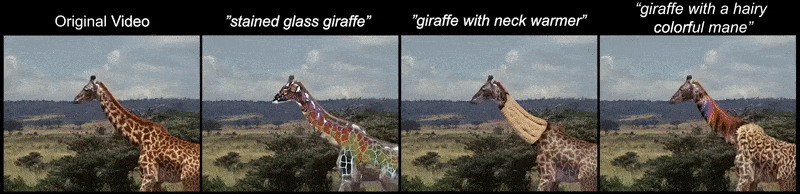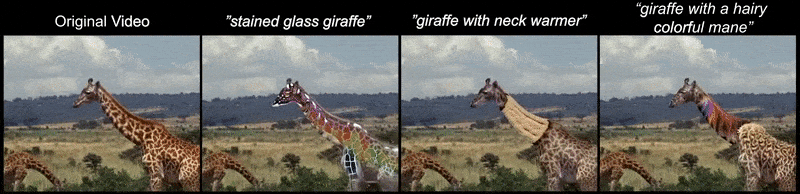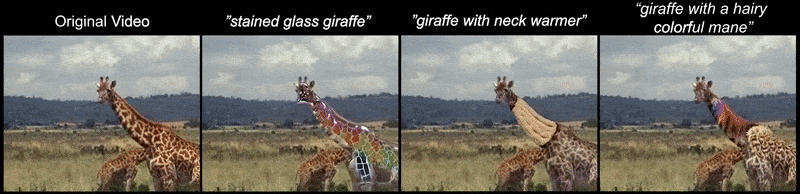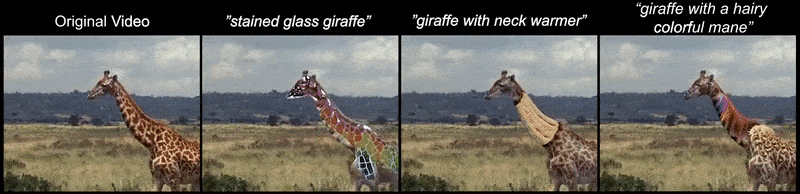
अग्रभूमि संपादन के दो उदाहरण। बेहतर रिज़ॉल्यूशन और स्पष्टता के लिए, मूल वीडियो https://text2live.github.io/sm/pages/video_results_atlases.html पर देखें
Text2Live बिना पूर्व-प्रशिक्षित जनरेटर का उपयोग किए सेमेंटिक और अत्यधिक स्थानीय संपादन प्रदान करता है, जो प्रभावित वीडियो क्लिप के लिए विशिष्ट एक आंतरिक डेटाबेस का उपयोग करता है।

Text2Live के तहत पृष्ठभूमि और अग्रभूमि (वस्तु) परिवर्तन। स्रोत: https://text2live.github.io/sm/pages/video_results_atlases.html
इस तकनीक में उपयोगकर्ता द्वारा दिए गए मास्क की आवश्यकता नहीं होती, जैसे पारंपरिक रोटोस्कोपिंग या ग्रीन-स्क्रीन कार्यप्रवाह में होती है। इसके बजाय यह बूटस्ट्रैपिंग तकनीक से प्रासंगिकता मानचित्रों का अनुमान लगाती है। यह तकनीक तेल अवीव विश्वविद्यालय के कंप्यूटर विज्ञान स्कूल और Facebook AI Research (FAIR) के 2021 के शोध पर आधारित है।

एक ट्रांसफॉर्मर-आधारित जेनेरिक ध्यान मॉडल द्वारा उत्पन्न आउटपुट मानचित्र।
नए शोधपत्र का शीर्षक Text2LIVE: टेक्स्ट-निर्देशित परतदार छवि और वीडियो संपादन है। 2021 की मूल टीम के साथ विज़मैन के ओमेर बार-ताल और NVIDIA रिसर्च के योनी कास्टेन भी जुड़े हैं।
वास्तुकला
Text2Live में एक जनरेटर शामिल है जो एकमात्र इनपुट छवि और लक्ष्य टेक्स्ट प्रोम्प्ट पर प्रशिक्षित होता है। 40 करोड़ टेक्स्ट/छवि जोड़ियों पर पूर्व-प्रशिक्षित कॉन्ट्रास्टिव लैंग्वेज–इमेज प्रीट्रेनिंग (CLIP) मॉडल संबंधित दृश्य सामग्री प्रदान करता है जिससे उपयोगकर्ता-इनपुट परिवर्तनों की व्याख्या की जा सकती है।

जनरेटर एक इनपुट छवि (फ्रेम) स्वीकार करता है और एक लक्ष्य आरजीबी ए लेयर का उत्पादन करता है जिसमें रंग और अपारदर्शिता जानकारी शामिल है। इस परत को तब मूल फुटेज में अतिरिक्त अभिवृद्धि के साथ संयुक्त किया जाता है।

उत्पन्न आरजीबी ए लेयर में अल्फा चैनल एक आंतरिक संयोजन कार्य प्रदान करता है जो पारंपरिक पाइपलाइनों को शामिल नहीं करता है जिसमें पिक्सेल-आधारित सॉफ्टवेयर जैसे कि आफ्टर इफेक्ट्स शामिल हैं।
लक्ष्य वीडियो या छवि से संबंधित आंतरिक छवियों पर प्रशिक्षण लेकर Text2Live दो आवश्यकताओं से बचता है। पहली, इनपुट छवि को जेनरेटिव एडवर्सारियल नेटवर्क (GAN) के लेटेंट स्पेस में इनवर्ट करना, जो अभी उत्पादन-स्तर के वीडियो संपादन के लिए पर्याप्त सटीकता से बहुत दूर है। दूसरी, अधिक सटीक और समायोज्य डिफ्यूजन मॉडल का उपयोग करना, जो लक्ष्य वीडियो के प्रति निष्ठा बनाए नहीं रख सकता।

Text2Live से प्रोम्प्ट-आधारित परिवर्तन संपादन।
पिछले दृष्टिकोणों ने या तो प्रसार-आधारित विधियों या ऑप्टिकल फ्लो-आधारित दृष्टिकोण का उपयोग किया है। चूंकि ये तकनीकें किसी न किसी हद तक फ्रेम-आधारित हैं, वे आउटपुट वीडियो में परिवर्तनों की संगत कालिक उपस्थिति बनाने में सक्षम नहीं हैं। एक तंत्रिका परतदार मानचित्र, इसके बजाय, एक एकल स्थान प्रदान करता है जिसमें परिवर्तनों को संबोधित किया जा सकता है, जो तब प्रतिबद्ध परिवर्तन के प्रति वफादार रहता है क्योंकि वीडियो आगे बढ़ता है।
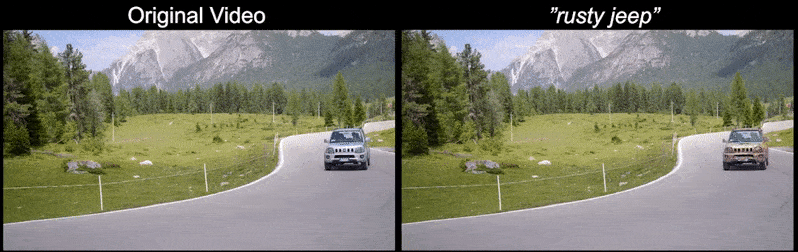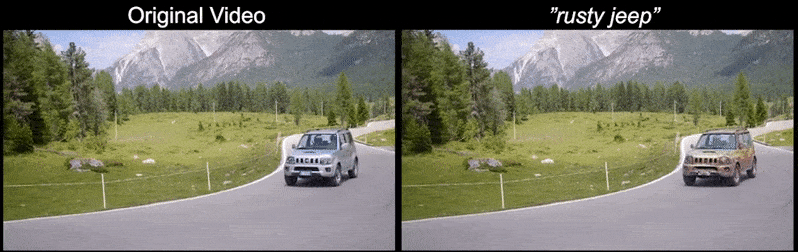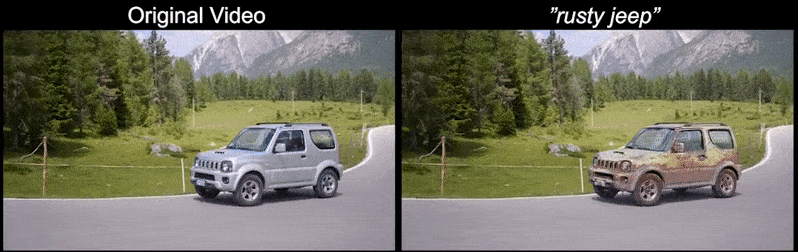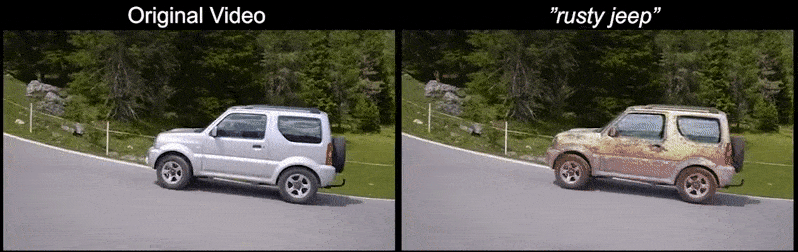
कोई दृश्य झिलमिलाहट या यादृच्छिक हॉलुसिनेशन नहीं: Text2Live टेक्स्ट प्रोम्प्ट ‘रस्टी जीप’ की व्याख्या प्राप्त करता है और इसे वीडियो में कार के तंत्रिका परतदार मानचित्र में एक बार लागू करता है, प्रत्येक व्याख्या किए गए फ्रेम के लिए परिवर्तन को पुनः आरंभ करने के बजाय।

जीप को एक जंग खाए हुए अवशेष में Text2Live के संगत परिवर्तन का कार्यप्रवाह।
Text2Live, टेक्स्ट से छवि बनाने के क्षेत्र की तुलना में एआई-आधारित कंपोज़िटिंग में बड़ी प्रगति के अधिक करीब है। टेक्स्ट से छवि बनाने के क्षेत्र ने इस सप्ताह OpenAI के DALL-E फ्रेमवर्क की दूसरी पीढ़ी के जारी होने से बहुत ध्यान आकर्षित किया है। DALL-E रूपांतरण में लक्ष्य छवियों को शामिल कर सकता है, लेकिन किसी तस्वीर में सीधे बदलाव करने की उसकी क्षमता सीमित है। इसके अलावा, उपयोगकर्ता के दुरुपयोग को रोकने के लिए मूल प्रशिक्षण डेटा पर सेंसरशिप और फ़िल्टर लगाए गए हैं।
इसके बजाय, Text2Live अंतिम उपयोगकर्ता को एक मानचित्र निकालने और फिर इसे एक ही पास में उच्च-नियंत्रण पिक्सेल-आधारित वातावरण जैसे फोटोशॉप (और तर्कसंगत रूप से अधिक अमूर्त छवि संश्लेषण फ्रेमवर्क जैसे NeRF) में संपादित करने की अनुमति देता है, इससे पहले कि इसे एक सही ढंग से उन्मुख वातावरण में वापस खिलाया जाए जो 3डी अनुमान या पुरानी विधियों की ओर लौटने वाले सीजीआई दृष्टिकोण पर निर्भर नहीं करता है।
इसके अलावा, Text2Live, लेखकों का दावा है, एक पूरी तरह से स्वचालित तरीके से मास्किंग और संयोजन हासिल करने वाला पहला तुलनीय फ्रेमवर्क है।
पहली बार 7 अप्रैल 2022 को प्रकाशित।





