
एआई मॉडल और प्लेटफ़ॉर्म
ओपनएआई का जीपीटी-4ओ: मानव-मशीन इंटरैक्शन को बदलने वाला मल्टीमॉडल एआई मॉडल

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें

मुख्य बिंदुGPT-4o पहली बार एक ही मॉडल में टेक्स्ट, ऑडियो और विज़न को मूल रूप से समन्वित करता है।
और देखें
- GPT-4o पहली बार एक ही मॉडल में टेक्स्ट, ऑडियो और विज़न को मूल रूप से समन्वित करता है।
- GPT-4o भावनात्मक संकेतों को पहचानता है और सहानुभूति के साथ प्रतिक्रिया देने के लिए अपना लहजा समायोजित करता है।
- OpenAI सभी उपयोगकर्ताओं को GPT-4o की मुख्य क्षमताएँ निःशुल्क प्रदान करता है।
ओपनएआई ने अपने नवीनतम और सबसे उन्नत भाषा मॉडल को जारी किया है – जीपीटी-4ओ, जिसे “ओम्नी” मॉडल के नाम से भी जाना जाता है। यह क्रांतिकारी एआई सिस्टम मानव और कृत्रिम बुद्धिमत्ता के बीच की रेखा को धुंधला करने वाला एक विशाल कदम है।
जीपीटी-4ओ के केंद्र में इसकी मूल मल्टीमॉडल प्रकृति है, जो इसे टेक्स्ट, ऑडियो, छवियों और वीडियो सहित विभिन्न माध्यमों में सामग्री को संसाधित और उत्पन्न करने की अनुमति देती है। एक ही मॉडल में कई माध्यमों का एकीकरण एक पहला है, जो एआई सहायकों के साथ हमारे इंटरैक्शन को कैसे बदलता है, यह दिखाने का वादा करता है।
जीपीटी-4ओ केवल एक मल्टीमॉडल सिस्टम से अधिक है। यह अपने पूर्ववर्ती, जीपीटी-4, और प्रतिस्पर्धी मॉडल जैसे जेमिनी 1.5 प्रो, क्लॉड 3, और लामा 3-70बी की तुलना में एक आश्चर्यजनक प्रदर्शन सुधार का दावा करता है। आइए जीपीटी-4ओ को वास्तव में क्या बनाता है इसे गहराई से देखें।
अनुपम प्रदर्शन और दक्षता
जीपीटी-4ओ की सबसे प्रभावशाली विशेषताओं में से एक इसकी अभूतपूर्व प्रदर्शन क्षमता है। ओपनएआई के मूल्यांकन के अनुसार, मॉडल को पिछले शीर्ष प्रदर्शनकर्ता, जीपीटी-4 टर्बो, के साथ 60 एलो पॉइंट की बढ़त हासिल है। यह महत्वपूर्ण लाभ जीपीटी-4ओ को अपने आप में एक लीग में रखता है, जो वर्तमान में उपलब्ध सबसे उन्नत एआई मॉडल को भी पीछे छोड़ देता है।
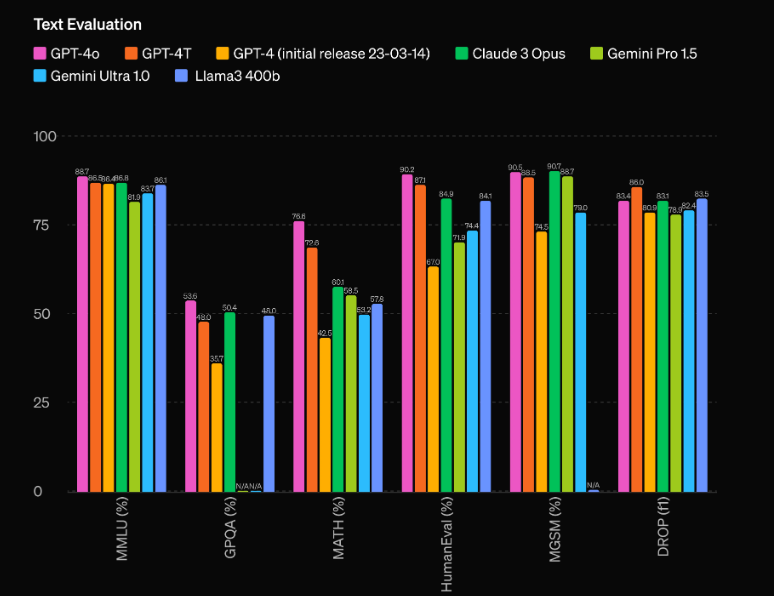
लेकिन कच्चा प्रदर्शन जीपीटी-4ओ की एकमात्र ऐसी विशेषता नहीं है जो चमकती है। मॉडल को जीपीटी-4 टर्बो की तुलना में दोगुनी गति से चलने और इसके चलने की लागत केवल आधी होने का दावा किया जाता है। यह बेहतर प्रदर्शन और लागत प्रभावशीलता का संयोजन जीपीटी-4ओ को उन्नत एआई क्षमताओं को अपने अनुप्रयोगों में एकीकृत करने के लिए विकासकर्ताओं और व्यवसायों के लिए एक अत्यंत आकर्षक प्रस्ताव बनाता है।
मल्टीमॉडल क्षमताएं: टेक्स्ट, ऑडियो और दृष्टि का मिश्रण
जीपीटी-4ओ की सबसे क्रांतिकारी विशेषता शायद इसकी मूल मल्टीमॉडल प्रकृति है, जो इसे टेक्स्ट, ऑडियो और दृष्टि सहित विभिन्न माध्यमों में सामग्री को संसाधित और उत्पन्न करने की अनुमति देती है। एक ही मॉडल में कई माध्यमों का एकीकरण एक पहला है, जो एआई सहायकों के साथ हमारे इंटरैक्शन को कैसे बदलता है, यह दिखाने का वादा करता है।
जीपीटी-4ओ के साथ, उपयोगकर्ता भाषण का उपयोग करके प्राकृतिक, वास्तविक समय की बातचीत में संलग्न हो सकते हैं, मॉडल तुरंत ऑडियो इनपुट को पहचान और प्रतिक्रिया करता है। लेकिन क्षमताएं वहीं नहीं रुकती हैं – जीपीटी-4ओ दृश्य सामग्री की व्याख्या और उत्पन्न करने में भी सक्षम है, जो छवि विश्लेषण और उत्पन्न, वीडियो समझ और निर्माण जैसे अनुप्रयोगों के लिए संभावनाओं का एक नया दुनिया खोलता है।
जीपीटी-4ओ की मल्टीमॉडल क्षमताओं का सबसे प्रभावशाली प्रदर्शन इसकी क्षमता है कि यह दृश्य या छवि को वास्तविक समय में व्याख्या और व्याख्या कर सकता है, जो दृश्य तत्वों की व्याख्या और व्याख्या करता है। यह सुविधा दृष्टि से वंचित लोगों के लिए सहायक प्रौद्योगिकियों, साथ ही सुरक्षा, निगरानी और स्वचालन जैसे क्षेत्रों में गहरे निहितार्थ हैं।
लेकिन जीपीटी-4ओ की मल्टीमॉडल क्षमताएं केवल दृश्य सामग्री को समझने और उत्पन्न करने तक ही सीमित नहीं हैं। मॉडल इन माध्यमों को मिलाकर真正 अनुभव और आकर्षक अनुभव बना सकता है। उदाहरण के लिए, ओपनएआई के लाइव डेमो में, जीपीटी-4ओ ने इनपुट शर्तों के आधार पर एक गीत उत्पन्न किया, जो भाषा, संगीत सिद्धांत और ऑडियो उत्पन्न की अपनी समझ को एक साथ मिलाकर एक सुसंगत और प्रभावशाली आउटपुट बनाया।
पाइथन का उपयोग करके जीपीटी0 का उपयोग करना
import openai
<p># अपनी वास्तविक ओपनएआई एपीआई कुंजी के साथ बदलें
OPENAI_API_KEY = "your_openai_api_key_here"</p>
<p># प्रतिक्रिया सामग्री निकालने के लिए एक फ़ंक्शन
def get_response_content(response_dict, exclude_tokens=None):
if exclude_tokens is None:
exclude_tokens = []
if response_dict and response_dict.get("choices") and len(response_dict["choices"]) > 0:
content = response_dict["choices"][0]["message"]["content"].strip()
if content:
for token in exclude_tokens:
content = content.replace(token, '')
return content
raise ValueError(f"Unable to resolve response: {response_dict}")</p>
<p># ओपनएआई चैट एपीआई को अनुरोध भेजने के लिए एक असिंक्रोनस फ़ंक्शन
async def send_openai_chat_request(prompt, model_name, temperature=0.0):
openai.api_key = OPENAI_API_KEY
message = {"role": "user", "content": prompt}
response = await openai.ChatCompletion.acreate(
model=model_name,
messages=[message],
temperature=temperature,
)
return get_response_content(response)</p>
<p># उदाहरण उपयोग
async def main():
prompt = "नमस्ते!"
model_name = "gpt-4o-2024-05-13"
response = await send_openai_chat_request(prompt, model_name)
print(response)</p>
<p>if __name__ == "__main__":
import asyncio
asyncio.run(main())</p>
मैंने:
- सीधे ओपनएआई मॉड्यूल को आयात किया है, कस्टम क्लास का उपयोग किए बिना।
- ओपनएआई_चैट_रिज़ॉल्व फ़ंक्शन को get_response_content में बदल दिया है और इसके कार्यान्वयन में कुछ मामूली बदलाव किए हैं।
- एएसिंक्रोनसओपनएआई क्लास को ओपनएआई के आधिकारिक असिंक्रोनस विधि openai.ChatCompletion.acreate के साथ बदल दिया है।
- एक उदाहरण मुख्य फ़ंक्शन जोड़ा है जो send_openai_chat_request फ़ंक्शन का उपयोग करने का तरीका दिखाता है।
कृपया ध्यान दें कि आपको कोड को सही से काम करने के लिए “your_openai_api_key_here” को अपनी वास्तविक ओपनएआई एपीआई कुंजी से बदलना होगा।


