
एआई मॉडल और प्लेटफ़ॉर्म
नए ऑफ-द-शेल्फ (ओटीएस) डेटासेट्स से अपेन एक्सेलेरेट एआई डिप्लॉयमेंट

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
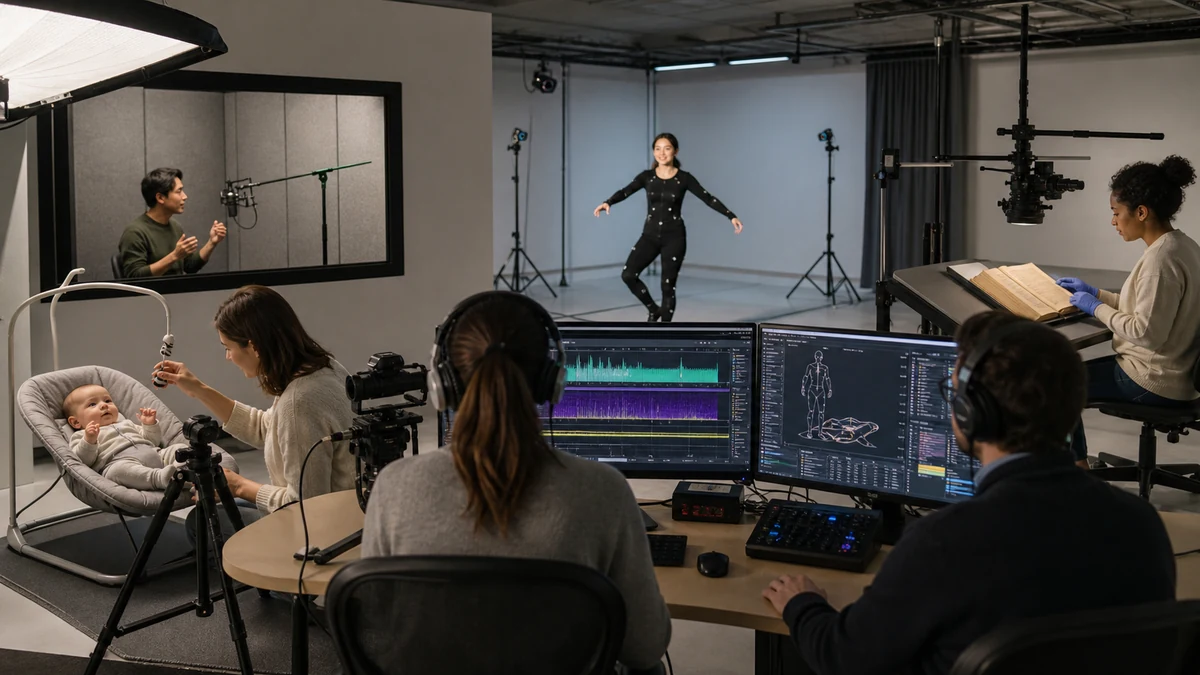
अपेन लिमिटेड (एएसएक्स: एपीएक्स), उच्च-गुणवत्ता वाले प्रशिक्षण डेटा के प्रमुख प्रदाता, जो संगठनों को प्रभावी एआई सिस्टम बनाने में मदद करते हैं, ने आज नए ऑफ-द-शेल्फ (ओटीएस) डेटासेट्स की घोषणा की। ये डेटासेट व्यवसायों को उनके कृत्रिम बुद्धिमत्ता (एआई) और मशीन लर्निंग (एमएल) परियोजनाओं को तेजी से आगे बढ़ाने के लिए आवश्यक उच्च-गुणवत्ता वाले प्रशिक्षण डेटा प्राप्त करने में मदद करने के लिए डिज़ाइन किए गए हैं। नए ओटीएस डेटासेट्स में मानव शरीर की गति और नवीन शिशु रोने की आवाज़, साथ ही स्क्रिप्टेड भाषण और ऑप्टिकल कैरेक्टर रिकॉग्निशन (ओसीआर) के लिए पाठ के साथ छवियाँ शामिल हैं, जो अरबी, क्रोएशियाई, ग्रीक, हंगेरियन, थाई और अधिक जैसी उच्च-मांग वाली लेकिन कठिन-से-प्राप्त भाषाओं के लिए उपयुक्त हैं। विस्तारित डेटासेट्स के साथ, अपेन की कुल ओटीएस पेशकश में 250 से अधिक डेटासेट शामिल हैं, जिसमें 11,000 घंटे से अधिक ऑडियो, 25,000 से अधिक छवियाँ और 80 भाषाओं और कई बोलियों में 8.7 मिलियन शब्द शामिल हैं।
अपेन के ओटीएस डेटासेट्स एक तेज़, लागत-प्रभावी उपकरण हैं जो उच्च-गुणवत्ता वाले प्रशिक्षण डेटा के साथ एआई या एमएल परियोजना को शुरू करने में मदद करते हैं। अपनी एआई क्षमताओं का विस्तार करने वाली टीमें ओटीएस डेटासेट्स का भी लाभ उठा सकती हैं ताकि उनके एआई मॉडलों में सटीकता में सुधार, नए मॉडल कौशल विकसित करने और अन्य सुधारों को शामिल करने में मदद मिल सके। एक ओटीएस डेटासेट अक्सर एक सप्ताह में वितरित किया जाता है, उदाहरण के लिए, एक नए डेटासेट संग्रह और एनोटेशन परियोजना के लिए आठ से बारह सप्ताह की तुलना में – या जटिलता के आधार पर और भी लंबा समय। सभी अपेन डेटासेट पूरी तरह से पारदर्शी और ऑप्ट-इन विधि का उपयोग करके विकसित किए जाते हैं, ताकि एआई विशेषज्ञों को यह सुनिश्चित किया जा सके कि उनका डेटा साफ और अनुपालन है, जो प्रतिक्रिया और प्रतिष्ठा की क्षति के जोखिम को समाप्त करता है।
“दुनिया भर में एआई टीमें जो तंग समय सीमा और लचीले डेटा आवश्यकताओं वाली परियोजनाओं पर काम कर रही हैं, ऑफ-द-शेल्फ डेटासेट्स का उपयोग करने से लाभान्वित हो सकती हैं,” अपेन के सीटीओ विल्सन पांग ने कहा। “ओटीएस डेटासेट्स मूल्य के समय को छोटा करते हैं और उच्च-गुणवत्ता वाले डेटा तक पहुंच प्रदान करते हैं पारंपरिक तरीकों की तुलना में कम कुल लागत पर। हम अपेन में यह सुनिश्चित करने के लिए आवश्यक कदम उठाते हैं कि हमारे सभी डेटासेट नैतिक रूप से सourced और जनसांख्यिकीय रूप से संतुलित हों, जो कंपनियों को जिम्मेदार एआई प्रथाओं को बनाए रखने में मदद करते हैं bằng कम करने में मदद करते हैं अपने मॉडलों में पूर्वाग्रह और डेटा एनोटेटरों के साथ न्यायपूर्ण व्यवहार सुनिश्चित करना। आप हमेशा एक ओटीएस डेटासेट की सटीक गुणवत्ता जानते हैं, जो वास्तविक दुनिया में काम करने वाले बेहतर एआई का निर्माण करने में मदद करता है। “
मीडियाइंटरफेस ने 20 वर्षों से अधिक समय से जर्मनी और यूरोप के अन्य हिस्सों में स्वास्थ्य से संबंधित संस्थानों को भाषा प्रौद्योगिकी समाधान प्रदान किए हैं। जब कंपनी फ्रांस में विस्तार कर रही थी, तो उसके पास पूरी तरह से स्थानीयकृत सॉफ़्टवेयर था, लेकिन फ्रांसीसी लексिकन डेटा की कमी थी, विशेष रूप से फ्रांसीसी नाम और स्थान, जो अक्सर रोगी स्वास्थ्य जानकारी में संदर्भित होते हैं। अपेन ओटीएस डेटासेट्स का उपयोग करके, मीडियाइंटरफेस ने लगभग 21,000 फ्रांसीसी नाम और 14,000 स्थान नाम प्राप्त किए। “अपेन से महत्वपूर्ण डेटा को हमारे पृष्ठभूमि लексिकन में शामिल किया गया है ताकि एक नए बाजार में सफलतापूर्वक लॉन्च किया जा सके, और यह हमें अपने ग्राहकों के लिए नए शब्दावली बनाने और भविष्य के बाजार लॉन्च के लिए अपने दृष्टिकोण को मजबूत करने में मदद करता है,” मीडियाइंटरफेस के उत्पाद प्रबंधक इनेस वेंडलर ने कहा।
अनुभवी एआई विशेषज्ञ जटिल एआई मॉडल प्रशिक्षण डेटा आवश्यकताओं को पूरा करने के लिए ओटीएस डेटासेट्स को ऑन-डिमांड डेटा संग्रह और एनोटेशन परियोजनाओं के साथ जोड़ते हैं। अपेन विशिष्ट डेटा संग्रह सेवाओं के माध्यम से निरंतर समर्थन प्रदान करने में अग्रणी है, जैसे कि निरंतर डेटा एनोटेशन और स्मार्ट लेबलिंग, एआई-संचालित उपकरणों और स्वचालित कार्य प्रवाहों के माध्यम से अधिकतम दक्षता प्राप्त करने के लिए।
“हम एआई के साथ जागते हैं और सोते हैं – वर्चुअल सहायक, चैटबॉट, सर्च इंजन, सोशल नेटवर्क, चिकित्सा उपकरण, स्मार्ट कार और अन्य अनुप्रयोगों के माध्यम से,” अपेन की एआई विशेषज्ञों की वरिष्ठ निदेशक जूडिथ बिशप ने कहा, जो 100 एआई भाषाविदों और भाषा विशेषज्ञों की एक टीम का नेतृत्व करती हैं। “भाषा अक्सर इन कई एआई उपयोग के मामलों के लिए प्राथमिक इंटरफ़ेस है, इसलिए एक महान अनुभव की गारंटी देने के लिए, मॉडल को सभी के लिए काम करने के लिए प्रशिक्षित किया जाना चाहिए। अपेन की उच्च-गुणवत्ता वाले डेटा और जिम्मेदार, नैतिक एआई विकास के प्रति प्रतिबद्धता हमारे ऑफ-द-शेल्फ डेटासेट्स को खरीदने वाली कंपनियों को अपने डेटा में पूर्ण विश्वास के साथ अपनी एआई परियोजनाओं को तेजी से आगे बढ़ाने में मदद करती है। “
मौजूदा सैकड़ों डेटासेट्स के अलावा, जो पहले से ही appen.com पर लाइव हैं, नए अपेन ओटीएस डेटासेट्स की सूची जो अब उपलब्ध है उसमें शामिल हैं:
- अरबी (मिस्र), अरबी (सऊदी अरब), अरबी (संयुक्त अरब अमीरात), केंद्रीय खमेर (कंबोडिया), क्रोएशियाई, ग्रीक, हंगेरियन, पोलिश, स्पेनिश (स्पेन), और तुर्की के लिए स्क्रिप्टेड भाषण
- सimplified चीनी मुद्रित पाठ, थाई मुद्रित पाठ, और फिनिश मुद्रित पाठ के लिए इमेज ओसीआर – प्री-रिकॉर्डेड बिलबोर्ड, बाहरी पैकेजिंग, संकेत, पत्रिकाएं, और मेनू शामिल हैं जो कंप्यूटर दृष्टि ओसीआर मॉडल को प्रशिक्षित और अद्यतन करने के लिए उपयुक्त हैं
- मानव शरीर की गति (चीन) – लोगों की गति के एनोटेटेड वीडियो शामिल हैं, जो पिक्सेल स्तर पर ट्रैक किए जाते हैं, जो गेम विकास, फिटनेस ऐप और अधिक के लिए उपयुक्त हैं
- शिशु रोने की ऑडियो (चीन) – शिशु की आवाज़ शामिल हैं जो प्रशिक्षित की जा सकती हैं और माता-पिता को अलग-अलग रोने की आवाज़ को पहचानने और अलर्ट करने के लिए प्रशिक्षित की जा सकती हैं
अधिक जानकारी और अपेन ओटीएस डेटासेट नमूना अनुरोध करने के लिए, यहां क्लिक करें।


