
Anderson का एंगल
एआई को पुराने युग में आईफ़ोन का चित्रण करने से कैसे रोकें

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
मुख्य बिंदुएआई छवि जनरेटर प्रॉम्प्ट निर्देशों के बावजूद प्रत्येक ऐतिहासिक काल के लिए विशिष्ट दृश्य…
और देखें
- एआई छवि जनरेटर प्रॉम्प्ट निर्देशों के बावजूद प्रत्येक ऐतिहासिक काल के लिए विशिष्ट दृश्य शैलियों को डिफ़ॉल्ट रूप से अपनाते हैं।
- डिफ्यूज़न मॉडल अक्सर उलझे हुए प्रशिक्षण डेटा संबंधों के कारण ऐतिहासिक दृश्यों में स्मार्टफोन जैसी आधुनिक वस्तुएं डाल देते हैं।
- शोधकर्ताओं ने प्रमुख एआई मॉडलों में इन ऐतिहासिक अशुद्धियों को व्यवस्थित रूप से मापने के लिए एक नया डेटासेट और मीट्रिक विकसित किया है।
एआई इमेज जनरेटर पिछले समय को कैसे चित्रित करते हैं? नए शोध से पता चलता है कि वे 18वीं शताब्दी में स्मार्टफ़ोन ड्रॉप करते हैं, 1930 के दृश्यों में लैपटॉप डालते हैं, और 19वीं शताब्दी के घरों में वैक्यूम क्लीनर रखते हैं, जो इस बात पर सवाल उठाते हैं कि ये मॉडल इतिहास की कल्पना कैसे करते हैं – और क्या वे संदर्भिक ऐतिहासिक सटीकता के लिए सक्षम हैं भी या नहीं।
2024 की शुरुआत में, गूगल के जेमिनी मल्टीमॉडल एआई मॉडल की छवि-पीढ़ी क्षमता आलोचना के तहत आई थी क्योंकि यह अनुचित संदर्भों में जनसांख्यिकीय न्याय लागू कर रहा था, जैसे कि द्वितीय विश्व युद्ध के जर्मन सैनिकों को असंभावित पृष्ठभूमि के साथ उत्पन्न करना:

असंभावित जनसांख्यिकीय जर्मन सैन्य कर्मी, जैसा कि गूगल के जेमिनी मल्टीमॉडल मॉडल द्वारा 2024 में कल्पना किया गया था। स्रोत: जेमिनी एआई/गूगल वाया द गार्जियन
यह एक ऐसा उदाहरण था जहां एआई मॉडल में पूर्वाग्रह को दूर करने के प्रयासों ने ऐतिहासिक संदर्भ को ध्यान में नहीं रखा था। इस मामले में, समस्या को जल्द ही हल कर लिया गया था। हालांकि, विसरण-आधारित मॉडल अभी भी ऐतिहासिक संदर्भ और कलाकृतियों को मिलाने वाले इतिहास के संस्करण उत्पन्न करने के लिए प्रवण होते हैं।
यह आंशिक रूप से जुड़ाव के कारण है, जहां प्रशिक्षण डेटा में एक साथ बार-बार दिखाई देने वाली विशेषताएं मॉडल के आउटपुट में जुड़ जाती हैं। उदाहरण के लिए, यदि आधुनिक वस्तुएं जैसे स्मार्टफ़ोन अक्सर डेटासेट में बातचीत या सुनने की क्रिया के साथ सहवर्ती होती हैं, तो मॉडल उन गतिविधियों को आधुनिक उपकरणों के साथ जोड़ना सीख सकता है, भले ही प्रॉम्प्ट एक ऐतिहासिक सेटिंग निर्दिष्ट करता हो। एक बार जब ये संबंध मॉडल के आंतरिक प्रतिनिधित्व में निहित हो जाते हैं, तो गतिविधि को उसके समकालीन संदर्भ से अलग करना मुश्किल हो जाता है, जिससे ऐतिहासिक रूप से असटीक परिणाम मिलते हैं।
स्विट्जरलैंड से एक नए शोध पत्र में, जो लेटेंट डिफ्यूजन मॉडल में ऐतिहासिक पीढ़ियों के जुड़ाव की घटना की जांच करता है, यह देखा गया है कि एआई फ्रेमवर्क जो फोटोरियलिस्टिक लोगों बनाने में काफी सक्षम हैं, फिर भी ऐतिहासिक आंकड़ों को ऐतिहासिक तरीके से चित्रित करना पसंद करते हैं:

नए पत्र से, एलडीएम के माध्यम से विविध प्रतिनिधित्व ‘एक फोटोरियलिस्टिक छवि [ऐतिहासिक अवधि] में एक मित्र के साथ हंसते हुए एक व्यक्ति की’ प्रॉम्प्ट के, प्रत्येक आउटपुट में प्रत्येक अवधि का संकेत दिया गया है। जैसा कि हम देख सकते हैं, युग का माध्यम सामग्री से जुड़ गया है। स्रोत: https://arxiv.org/pdf/2505.17064
प्रॉम्प्ट ‘एक फोटोरियलिस्टिक छवि [ऐतिहासिक अवधि] में एक मित्र के साथ हंसते हुए एक व्यक्ति की’ के लिए, तीन परीक्षण मॉडलों में से एक अक्सर नकारात्मक प्रॉम्प्ट ‘मोनोक्रोम’ को अनदेखा कर देता है और इसके बजाय उस युग की दृश्य मीडिया की रंग योजनाओं का उपयोग करता है, जैसे कि 1950 और 1970 के दशक की सेल्युलाइड फिल्म की म्यूट टोन की नकल करना।
परीक्षण में यह पाया गया कि मॉडल एक सामान्य प्रवृत्ति दिखाते हैं जो समयहीन गतिविधियों (जैसे ‘गाना’ या ‘खाना पकाना’) को आधुनिक संदर्भ और उपकरणों के साथ जोड़ते हैं:

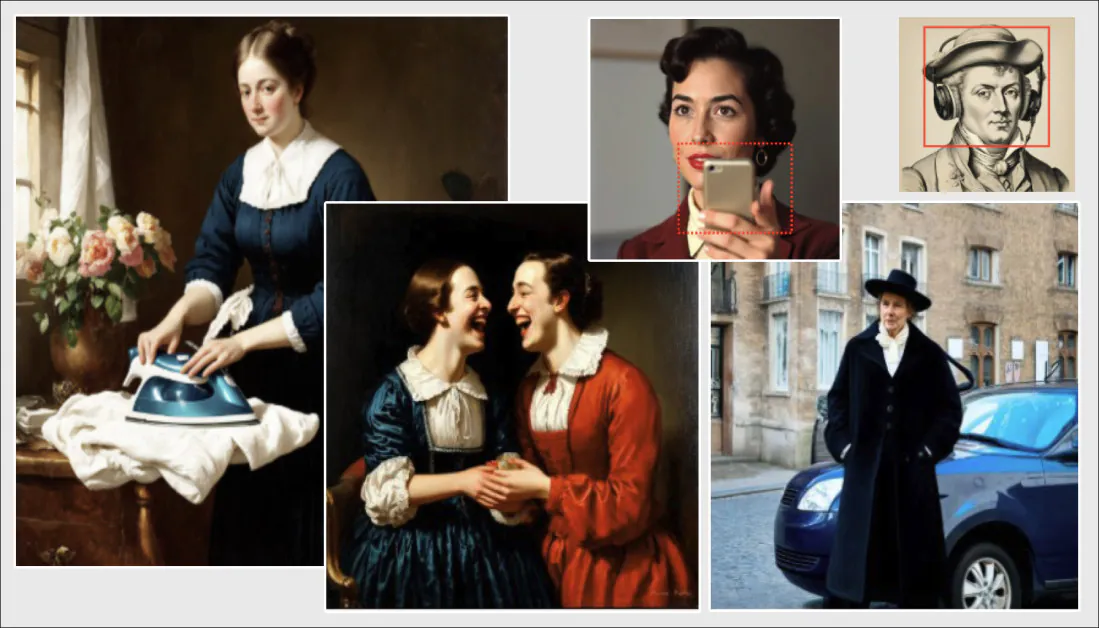
विभिन्न गतिविधियाँ जो पिछली शताब्दियों के लिए पूरी तरह से वैध हैं, वर्तमान या हाल की प्रौद्योगिकी और परिधान के साथ चित्रित की जाती हैं, जो अनुरोधित छवियों की भावना के विरुद्ध है।
यह ध्यान देने योग्य है कि स्मार्टफ़ोन फोटोग्राफी की धारा से अलग करना मुश्किल है, और कई ऐतिहासिक संदर्भों से, क्योंकि उनका प्रसार और चित्रण प्रभावशाली हाइपरस्केल डेटासेट जैसे कॉमन क्रॉल में अच्छी तरह से प्रतिनिधित्व किया जाता है:

फ्लक्स जेनरेटिव टेक्स्ट-टू-इमेज मॉडल में, संचार और स्मार्टफ़ोन जुड़े हुए अवधारणाएं हैं – भले ही ऐतिहासिक संदर्भ इसकी अनुमति न दे।
समस्या की सीमा का पता लगाने के लिए, और इस विशिष्ट बगबियर के साथ भविष्य के शोध प्रयासों के लिए एक तरीका प्रदान करने के लिए, नए पत्र के लेखकों ने एक विशेष डेटासेट विकसित किया जिसके खिलाफ उत्पन्न प्रणालियों का परीक्षण किया जा सके:
एक नाजुक ‘सत्य’
इस पत्र में कुछ विषय सांस्कृतिक रूप से संवेदनशील मुद्दों को छूते हैं, जैसे कि ऐतिहासिक प्रतिनिधित्व में जातियों और लिंग का कम प्रतिनिधित्व। जबकि जेमिनी का द्वितीय विश्व युद्ध के जर्मन सैनिकों में जनसांख्यिकीय समानता लागू करना एक असंभव और अपमानजनक ऐतिहासिक संशोधन है, ‘पारंपरिक’ जातीय प्रतिनिधित्व को बहाल करना (जहां विसरण मॉडल ने उन्हें ‘अद्यतन’ किया है) अक्सर इतिहास को ‘पुनः-श्वेत’ करने का परिणाम देगा:
हाल की कई सफल ऐतिहासिक श्रृंखलाएं, जैसे ब्रिजर्टन, ऐतिहासिक जनसांख्यिकीय सटीकता को धुंधला करती हैं जो भविष्य के प्रशिक्षण डेटासेट को प्रभावित करने की संभावना है, जो पारंपरिक मानकों के साथ एलएलएम-उत्पन्न अवधि छवियों को संरेखित करने के प्रयासों को जटिल बनाती है। हालांकि, यह एक जटिल विषय है, दी गई (पश्चिमी) इतिहास की प्रवृत्ति को देखते हुए समृद्धि और श्वेतता को प्राथमिकता देने और इतनी सारी ‘निचली’ कहानियों को अनकहा छोड़ने के लिए:
इन जटिल और बदलते सांस्कृतिक पैरामीटर को ध्यान में रखते हुए, आइए शोधकर्ताओं के नए दृष्टिकोण पर गौर करें:
विधि और परीक्षण
ऐतिहासिक संदर्भ की व्याख्या कैसे जनरेटिव मॉडल करते हैं, इसका परीक्षण करने के लिए, लेखकों ने हिस्टविस नामक एक डेटासेट बनाया, जिसमें 30,000 छवियां शामिल हैं जो सौ प्रॉम्प्ट से उत्पन्न हुईं जो मानव गतिविधियों को चित्रित करती हैं, प्रत्येक को दस अलग-अलग समय अवधियों में प्रस्तुत किया गया है:

हिस्टविस डेटासेट का एक नमूना, जिसे लेखकों ने हगिंग फेस पर उपलब्ध कराया है। स्रोत: https://huggingface.co/datasets/latentcanon/HistVis
गतिविधियाँ, जैसे खाना पकाना, प्रार्थना या संगीत सुनना, उनकी सार्वभौमिकता के लिए चुनी गईं, और तटस्थ प्रारूप में वाक्यांशित की गईं ताकि मॉडल को किसी विशेष एस्थेटिक में錬錬 न किया जा सके। डेटासेट में समय अवधि सत्रहवीं शताब्दी से वर्तमान तक है, जिसमें बीसवीं शताब्दी के पांच व्यक्तिगत दशकों पर अतिरिक्त ध्यान केंद्रित किया गया है।
30,000 छवियां तीन व्यापक रूप से उपयोग किए जाने वाले ओपन-सोर्स विसरण मॉडलों का उपयोग करके उत्पन्न की गईं: स्टेबल डिफ्यूजन एक्सएल; स्टेबल डिफ्यूजन 3; और फ्लक्स.1। समय अवधि को एकमात्र परिवर्तनीय के रूप में अलग करके, शोधकर्ताओं ने इन प्रणालियों द्वारा दृश्य रूप से ऐतिहासिक संकेतों को कैसे एन्कोड या अनदेखा किया जाता है, इसका मूल्यांकन करने के लिए एक संरचित आधार बनाया:
दृश्य शैली प्रभुत्व
लेखक ने पहले जांच की कि क्या जनरेटिव मॉडल ऐतिहासिक अवधियों को चित्रित करने के लिए विशिष्ट दृश्य शैली को डिफ़ॉल्ट रूप से अपनाते हैं; क्योंकि ऐसा लगता था कि प्रॉम्प्ट में माध्यम या एस्थेटिक का कोई उल्लेख नहीं होने पर भी, मॉडल अक्सर विशिष्ट शताब्दियों के साथ विशिष्ट शैलियों को जोड़ते हैं:

प्रॉम्प्ट ‘एक व्यक्ति [ऐतिहासिक अवधि] में एक व्यक्ति के साथ नृत्य करते हुए’ (बाएं) और संशोधित प्रॉम्प्ट ‘एक फोटोरियलिस्टिक छवि [ऐतिहासिक अवधि] में एक व्यक्ति के साथ नृत्य करते हुए’ के लिए अनुमानित दृश्य शैली (दाएं) ‘मोनोक्रोम चित्र’ के साथ एक नकारात्मक प्रॉम्प्ट के रूप में।
इस प्रवृत्ति को मापने के लिए, लेखकों ने एक कन्वोल्यूशनल न्यूरल नेटवर्क (सीएनएन) को प्रशिक्षित किया ताकि हिस्टविस डेटासेट में प्रत्येक छवि को पांच श्रेणियों में से एक में वर्गीकृत किया जा सके: चित्रण; उत्कीर्णन; चित्र; पेंटिंग; या फोटोग्राफी। ये श्रेणियां समय अवधि के प्रति सामान्य पैटर्न को प्रतिबिंबित करने के लिए अभिप्रेत थीं जो संरचित तुलना का समर्थन करती हैं:
वर्गीकारक एक वीजीजी16 मॉडल पर आधारित था जो इमेजनेट पर पूर्व-प्रशिक्षित था और फाइन-ट्यून किया गया था 1,500 उदाहरणों के साथ प्रति वर्ग से एक विकीआर्ट-व्युत्पन्न डेटासेट से। चूंकि विकीआर्ट मोनोक्रोम और रंगीन फोटोग्राफी के बीच अंतर नहीं करता है, एक अलग रंगीन स्कोर का उपयोग कम संतृप्ति वाली छवियों को मोनोक्रोम के रूप में लेबल करने के लिए किया गया था।
प्रशिक्षित वर्गीकारक को फिर पूरे डेटासेट पर लागू किया गया, जिसके परिणाम यह दिखाते हैं कि तीनों मॉडल समय अवधि के अनुसार सुसंगत शैलीगत डिफ़ॉल्ट लागू करते हैं: एसडीएक्सएल 17वीं और 18वीं शताब्दी को उत्कीर्णन के साथ जोड़ता है, जबकि एसडी3 और फ्लक्स.1 चित्रकला की ओर झुकते हैं। बीसवीं शताब्दी के दशकों में, एसडी3 मोनोक्रोम फोटोग्राफी को पसंद करता है, जबकि एसडीएक्सएल अक्सर आधुनिक चित्रण लौटाता है।
इन प्राथमिकताओं को प्रॉम्प्ट समायोजन के बावजूद बनाए रखा गया, जो यह सुझाव देता है कि मॉडल शैली और ऐतिहासिक संदर्भ के बीच गहरे संबंधों को एन्कोड करते हैं:

प्रत्येक मॉडल और समय अवधि के लिए 1,000 नमूनों प्रति अवधि प्रति मॉडल के आधार पर जनरेट की गई छवियों की अनुमानित दृश्य शैली।
मॉडल और समय अवधि के लिए एक विशिष्ट दृश्य शैली से जुड़ने की ताकत को मापने के लिए, लेखकों ने एक मीट्रिक विकसित किया जिसे वे दृश्य शैली प्रभुत्व (वीएसडी) कहते हैं: प्रत्येक मॉडल और समय अवधि के लिए, वीएसडी सबसे आम शैली साझा करने वाले आउटपुट का अनुपात है:

मॉडलों में शैलीगत पूर्वाग्रहों के उदाहरण।
एक उच्च स्कोर यह दर्शाता है कि एक ही शैली उस अवधि के लिए आउटपुट को नियंत्रित करती है, जबकि एक कम स्कोर अधिक विविधता की ओर संकेत करता है: यह प्रत्येक मॉडल के दृश्य व्याख्या की सुसंगतता की तुलना करने की अनुमति देता है:

परिणाम तालिका ऊपर प्रत्येक मॉडल के लिए वीएसडी स्कोर दिखाती है ऐतिहासिक अवधियों में। 17वीं और 18वीं शताब्दी में, एसडीएक्सएल उत्कीर्णन का उत्पादन करता है जो उच्च सुसंगतता के साथ होता है, जबकि एसडी3 और फ्लक्स.1 चित्रकला की ओर झुकते हैं। 20वीं और 21वीं शताब्दी में, एसडी3 और फ्लक्स.1 फोटोग्राफी की ओर बढ़ते हैं, जबकि एसडीएक्सएल में अधिक विविधता होती है, लेकिन अक्सर चित्रण को डिफ़ॉल्ट रूप से चुनता है:
तीनों मॉडल 20वीं शताब्दी के शुरुआती दशकों में, विशेष रूप से 1910, 1930 और 1950 के दशक में, मोनोक्रोम छवियों के लिए एक मजबूत प्राथमिकता प्रदर्शित करते हैं।
इन पैटर्न को कम करने के लिए, लेखकों ने प्रॉम्प्ट इंजीनियरिंग का उपयोग किया, जिसमें फोटोरियलिज़म का स्पष्ट रूप से अनुरोध किया गया और नकारात्मक प्रॉम्प्ट का उपयोग करके मोनोक्रोम आउटपुट को प्रोत्साहित किया गया। कुछ मामलों में, प्रभुत्व स्कोर कम हो गए, और प्रमुख शैली बदल गई, जैसे कि 17वीं और 18वीं शताब्दी में मोनोक्रोम से चित्रकला में:
हालांकि, इन हस्तक्षेपों ने शायद ही कभी वास्तव में फोटोरियलिस्टिक छवियां उत्पन्न कीं, यह दर्शाता है कि मॉडलों के शैलीगत डिफ़ॉल्ट गहराई से निहित हैं:
ऐतिहासिक सुसंगतता
विश्लेषण की अगली पंक्ति ने ऐतिहासिक सुसंगतता पर गौर किया: क्या उत्पन्न छवियों में समय अवधि के लिए उपयुक्त नहीं होने वाली वस्तुएं शामिल हैं; इसके बजाय एक निश्चित सूची का उपयोग करने के लिए, लेखकों ने एक लचीले तरीके का विकास किया जो बड़े भाषा मॉडल (एलएलएम) और दृष्टि-भाषा मॉडल (वीएलएम) का लाभ उठाता है, जो ऐतिहासिक संदर्भ के आधार पर असंगत तत्वों का पता लगाने के लिए:
पता लगाने की विधि हिस्टविस डेटासेट के समान प्रारूप का अनुसरण करती है, जहां प्रत्येक प्रॉम्प्ट एक ऐतिहासिक अवधि के साथ मानव गतिविधि को जोड़ता है। प्रत्येक प्रॉम्प्ट के लिए, जीपीटी-4ओ ने एक सूची तैयार की जो उस समय अवधि में असंगत होने वाली वस्तुओं की सूची देती है; और प्रत्येक प्रस्तावित वस्तु के लिए, जीपीटी-4ओ ने एक हाँ-नहीं प्रश्न तैयार किया जो जांचता है कि क्या वह वस्तु उत्पन्न छवि में दिखाई देती है:
उदाहरण के लिए, प्रॉम्प्ट ’18वीं शताब्दी में संगीत सुनते हुए एक व्यक्ति’ के लिए, जीपीटी-4ओ आधुनिक ऑडियो डिवाइस को ऐतिहासिक रूप से असटीक के रूप में पहचान सकता है, और प्रश्न तैयार कर सकता है क्या व्यक्ति 18वीं शताब्दी में मौजूद नहीं होने वाले हेडफ़ोन या स्मार्टफ़ोन का उपयोग कर रहा है?
इन प्रश्नों को जीपीटी-4ओ को एक दृश्य प्रश्न-उत्तर सेटअप में वापस भेजा गया, जहां मॉडल ने छवि की समीक्षा की और प्रत्येक के लिए हाँ या नहीं का उत्तर दिया। यह पाइपलाइन ऐतिहासिक रूप से असंभव सामग्री का पता लगाने की अनुमति देती है बिना किसी पूर्व-निर्धारित टैक्सोनॉमी के आधुनिक वस्तुओं पर निर्भर:

दो-चरणीय पता लगाने की विधि द्वारा फ्लैग की गई उत्पन्न छवियों के उदाहरण, जो ऐतिहासिक रूप से असंगत तत्व दिखाते हैं: 18वीं शताब्दी में हेडफ़ोन; 19वीं शताब्दी में वैक्यूम क्लीनर; 1930 के दशक में लैपटॉप; और 1950 के दशक में स्मार्टफ़ोन।
ऐतिहासिक रूप से असंगत तत्वों की आवृत्ति और गंभीरता को मापने के लिए, लेखकों ने दो मीट्रिक विकसित किए: आवृत्ति ने मापा कि एक निश्चित वस्तु कितनी बार एक विशिष्ट समय अवधि और मॉडल के लिए छवियों में दिखाई देती है; और गंभीरता ने मापा कि जब यह सुझाव दिया गया था तब यह कितनी बार दिखाई दिया:
यदि एक आधुनिक फोन को दस बार फ्लैग किया गया था और यह दस उत्पन्न छवियों में दिखाई दिया, तो यह एक गंभीरता स्कोर 1.0 प्राप्त करता है। यदि यह केवल पांच में दिखाई दिया, तो गंभीरता स्कोर 0.5 था। ये स्कोर यह पहचानने में मदद करते हैं कि न केवल यह कि क्या ऐतिहासिक रूप से असंगत तत्व होते हैं, बल्कि वे मॉडल के आउटपुट में कितनी दृढ़ता से निहित हैं:

प्रत्येक मॉडल के लिए शीर्ष पंद्रह ऐतिहासिक रूप से असंगत तत्व, आवृत्ति के साथ x-अक्ष पर और गंभीरता के साथ y-अक्ष पर।
उपरोक्त हम प्रत्येक मॉडल के लिए शीर्ष पंद्रह ऐतिहासिक रूप से असंगत तत्व देखते हैं, जो आवृत्ति और गंभीरता दोनों द्वारा रैंक किए जाते हैं।
वस्त्र अक्सर दिखाई देते हैं लेकिन बिखरे हुए होते हैं, जबकि वस्तुएं जैसे ऑडियो डिवाइस और इस्त्री उपकरण कम बार दिखाई देते हैं, लेकिन उच्च सुसंगतता के साथ – पैटर्न जो सुझाव देते हैं कि मॉडल प्रॉम्प्ट में गतिविधि का अधिक जवाब देते हैं समय अवधि की तुलना में:
एसडी3 ने सबसे अधिक ऐतिहासिक रूप से असंगत तत्वों की दर दिखाई, विशेष रूप से 19वीं शताब्दी और 1930 के दशक की छवियों में, इसके बाद फ्लक्स.1 और एसडीएक्सएल:
पता लगाने की विधि को मानव निर्णय से कितनी अच्छी तरह मेल खाती है, इसका परीक्षण करने के लिए, लेखकों ने एसडी3 (सबसे अधिक ऐतिहासिक रूप से असंगत दर वाला मॉडल) से 1,800 यादृच्छिक रूप से नमूने छवियों के साथ एक उपयोगकर्ता अध्ययन चलाया, प्रत्येक छवि को तीन भीड़ कार्यकर्ताओं द्वारा रेट किया गया। विश्वसनीय प्रतिक्रियाओं को फिल्टर करने के बाद, 234 उपयोगकर्ताओं से 2,040 निर्णय शामिल किए गए थे, और विधि ने 72 प्रतिशत मामलों में बहुमत के मत से सहमति व्यक्त की:

मानव मूल्यांकन अध्ययन के लिए जीयूआई, कार्य निर्देश, सटीक और ऐतिहासिक रूप से असंगत छवियों के उदाहरण, और उत्पन्न आउटपुट में समय संबंधी असंगतताओं की पहचान के लिए हाँ-नहीं प्रश्न।
जनसांख्यिकी
अंतिम विश्लेषण ने मॉडल द्वारा समय के साथ जाति और लिंग की व्याख्या कैसे की जाती है, इस पर गौर किया:
हिस्टविस डेटासेट का उपयोग करते हुए, लेखकों ने मॉडल के आउटपुट की तुलना भाषा मॉडल द्वारा उत्पन्न आधारभूत अनुमानों से की, जो ऐतिहासिक संभावना का एक अस्पष्ट विचार प्रदान करते हैं, जो यह प्रकट करने में मदद करता है कि क्या मॉडल व्याख्याओं को इच्छित अवधि के अनुसार अनुकूलित करते हैं:
इन व्याख्याओं का मूल्यांकन करने के लिए, लेखकों ने एक पाइपलाइन बनाई जो मॉडल-उत्पन्न जनसांख्यिकी की तुलना समय और गतिविधि के लिए मॉडल की अपेक्षाओं से करती है: उन्होंने फेयरफेस वर्गीकारक का उपयोग किया, जो 100,000 से अधिक छवियों पर प्रशिक्षित रेसनेट34-आधारित उपकरण है, जो उत्पन्न आउटपुट में चेहरों को पुरुष या महिला के रूप में वर्गीकृत करने और जातीय श्रेणियों को ट्रैक करने की अनुमति देता है:

विभिन्न मॉडलों, समय अवधियों और गतिविधियों में जनसांख्यिकीय अधिशेष के साथ उत्पन्न छवियों के उदाहरण।
कम विश्वास वाले परिणामों को शोर को कम करने के लिए फिल्टर किया गया था, और भविष्यवाणियों को सभी छवियों पर औसतन किया गया जो एक विशिष्ट समय और गतिविधि से जुड़ी थीं। फेयरफेस पाठकों की विश्वसनीयता की जांच करने के लिए, 5,000 छवियों के नमूने पर डीपफेस पर आधारित एक दूसरी प्रणाली का उपयोग किया गया था। दो वर्गीकारकों ने पढ़ाई की स्थिरता का समर्थन करते हुए मजबूत समझौता दिखाया:
मॉडल के आउटपुट की तुलना ऐतिहासिक संभावना से करने के लिए, लेखकों ने जीपीटी-4ओ से प्रत्येक गतिविधि और समय अवधि के लिए अपेक्षित लिंग और जातीय वितरण का अनुमान लगाने के लिए कहा: ये अनुमान आधारभूत मानक के रूप में कार्य करते हैं, न कि मूल सत्य:
दो मीट्रिक का उपयोग किया गया था: अधीनता और अतिरिक्तता, जो मापते हैं कि मॉडल के आउटपुट एलएलएम की अपेक्षाओं से कितना विचलित होते हैं:
परिणामों से स्पष्ट पैटर्न उभरे: फ्लक्स.1 अक्सर पुरुषों को अधिक प्रतिनिधित्व करता है, यहां तक कि खाना पकाने जैसी स्थितियों में भी जहां महिलाओं की अपेक्षा की जाती है; एसडी3 और एसडीएक्सएल श्रम, शिक्षा और धर्म जैसी श्रेणियों में समान रुझान दिखाते हैं; सफेद चेहरे समग्र रूप से अपेक्षा से अधिक दिखाई देते हैं, हालांकि यह पूर्वाग्रह हाल की अवधियों में कम हो जाता है; और कुछ श्रेणियों में गैर-श्वेत प्रतिनिधित्व में अप्रत्याशित वृद्धि देखी जाती है, जो यह सुझाव देती है कि मॉडल का व्यवहार डेटासेट संबंधों को दर्शा सकता है, न कि ऐतिहासिक संदर्भ:

फ्लक्स.1 के आउटपुट में लिंग और जातीय अधिशेष और अधीनता, जीपीटी-4ओ जनसांख्यिकीय अनुमानों से पूर्ण अंतर के रूप में।
लेखक निष्कर्ष निकालते हैं:
‘हमारा विश्लेषण यह दर्शाता है कि [टेक्स्ट-टू-इमेज/टीटीआई] मॉडल ऐतिहासिक अवधियों की बजाय सीमित शैलीगत एन्कोडिंग पर भरोसा करते हैं। प्रत्येक युग एक विशिष्ट दृश्य शैली से जुड़ा हुआ है, जिसके परिणामस्वरूप इतिहास के एक-आयामी चित्रण होते हैं।
‘विशेष रूप से, फोटोरियलिस्टिक चित्रण लोगों की केवल 20वीं शताब्दी के बाद से दिखाई देते हैं, केवल फ्लक्स.1 और एसडी3 में दुर्लभ अपवादों के साथ, यह सुझाव देते हुए कि मॉडल सीखे गए संबंधों को मजबूती से बनाए रखते हैं और ऐतिहासिक संदर्भों के लिए लचीले ढंग से अनुकूलन नहीं करते हैं, यथार्थवाद को एक आधुनिक विशेषता के रूप में बनाए रखते हैं।
‘इसके अलावा, बार-बार दिखाई देने वाली ऐतिहासिक रूप से असंगत तत्व यह सुझाव देते हैं कि ऐतिहासिक अवधियां इन मॉडलों के लेटेंट स्पेस में साफ-साफ अलग नहीं हैं, क्योंकि आधुनिक कलाकृतियां अक्सर पूर्व-आधुनिक सेटिंग्स में उभरकर सामने आती हैं, जो शिक्षा और सांस्कृतिक विरासत संदर्भों में टीटीआई प्रणालियों की विश्वसनीयता को कमजोर करती है।’
निष्कर्ष
एक विसरण मॉडल के प्रशिक्षण के दौरान, नए अवधारणाएं साफ-साफ परिभाषित स्लॉट में नहीं बैठती हैं जो लेटेंट स्पेस में पहले से मौजूद हैं। इसके बजाय, वे उन अवधारणाओं के साथ जुड़े हुए क्लस्टर बनाते हैं जो प्रशिक्षण डेटा में अक्सर एक साथ दिखाई देती हैं। परिणाम एक ढीले-ढाले ढांचे की तरह होता है जहां अवधारणाएं उनकी आवृत्ति और सामान्य संदर्भ के साथ संबंध में मौजूद होती हैं, न कि साफ-साफ या सांख्यिकीय रूप से अलग:
यह इस बात का कारण है कि यह एक 2025-गुणवत्ता वाली फोटोरियलिस्टिक छवि को 19वीं शताब्दी से एक पात्र के रूप में उत्पन्न करना कठिन बनाता है; अधिकांश मामलों में, मॉडल फिल्म और टेलीविजन से दृश्य रूपांकनों पर भरोसा करेगा। जब वे अनुरोध से मेल नहीं खाते हैं, तो मेल खाने के लिए डेटा में बहुत कम होता है। इस अंतर को पाटने की संभावना है भविष्य के सुधार पर निर्भर करेगी जो ओवरलैपिंग अवधारणाओं को अलग करने में मदद करते हैं:
सोमवार, 26 मई, 2025 को पहली बार प्रकाशित


