
Anderson का एंगल
पारंपरिक CGI के लिए चेहरों के रेंडरर के रूप में GAN

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें

मुख्य बिंदुGAN अव्यक्त स्थान में पहचान को अभिव्यक्ति से अलग करना चेहरे के वीडियो संश्लेषण के लिए…
और देखें
- GAN अव्यक्त स्थान में पहचान को अभिव्यक्ति से अलग करना चेहरे के वीडियो संश्लेषण के लिए केंद्रीय अनसुलझी चुनौती बना हुआ है।
- SMPL और 3DMM जैसे पैरामीट्रिक CGI मॉडल का उपयोग GAN के अनियंत्रित अव्यक्त कोडों पर क्रम लगाने के लिए तेजी से किया जा रहा है।
- डिज़्नी का रेंडरिंग विद स्टाइल हाइब्रिड दृष्टिकोण पारंपरिक टेक्सचर मैप्स को GAN-जनित इमेजरी के साथ मिलाकर अजीब परिणाम उत्पन्न करता है।
राय जब जेनरेटिव एडवर्सेरियल नेटवर्क (GANs) ने पहली बार यह प्रदर्शित किया कि वे कैसे आश्चर्यजनक रूप से वास्तविक 3D चेहरे पुन: उत्पन्न कर सकते हैं, तो यह एक सोने की खान की तरह था जो GANs के अप्रयुक्त संभावनाओं को खोजने के लिए तैयार था, जो समय के साथ सुसंगत मानव-चेहरे वाले वीडियो बना सके।
किसी तरह, GAN के लेटेंट स्पेस में, ऐसा लगता था कि वहाँ एक छिपी हुई व्यवस्था और तर्क था – एक सेमेंटिक तर्क की योजना, जो लेटेंट कोड्स में दफन थी, जो एक GAN को एक ही चेहरे के विभिन्न दृश्यों और व्याख्याओं (जैसे कि अभिव्यक्ति परिवर्तन) को उत्पन्न करने में सक्षम बनाती थी – और इसके बाद एक समय के साथ सुसंगत और विश्वसनीय डीपफेक वीडियो तरीका प्रदान करती थी जो ऑटोएनकोडर को बहुत पीछे छोड़ देता।
उच्च-रिज़ॉल्यूशन आउटपुट मामूली होगा, ऑटोएनकोडर के निम्न-रिज़ॉल्यूशन वातावरण की तुलना में जिसमें जीपीयू प्रतिबंध डीपफेसलैब और फेसस्वैप को संचालित करने के लिए मजबूर करते हैं, जबकि एक ऑटोएनकोडर वर्कफ्लो में चेहरे का ‘स्वैप ज़ोन’ एक GAN का ‘निर्माण क्षेत्र’ बन जाएगा, जो कुछ इनपुट छवियों से सूचित किया जाएगा, या यहाँ तक कि एक ही छवि से।
चेहरे के ‘स्वैप’ और ‘होस्ट’ के बीच कोई बेमेलपन नहीं होगा, क्योंकि पूरी छवि शुरुआत से उत्पन्न की जाएगी, जिसमें बाल, जॉलाइन और चेहरे की रेखाओं के बाहरी सिरे शामिल होंगे, जो अक्सर ‘पारंपरिक’ ऑटोएनकोडर गहरे फेक के लिए एक चुनौती साबित होते हैं।
GAN फेसियल वीडियो शीतकालीन
जैसा कि यह निकला, यह इतना आसान नहीं था। अंततः, कारकों का पृथक्करण केंद्रीय मुद्दा साबित हुआ, और यह अभी भी प्राथमिक चुनौती है। कैसे एक विशिष्ट चेहरे की पहचान बनाए रखी जा सकती है, और उसके पोज़ या अभिव्यक्ति को बदला जा सकता है बिना हज़ारों संदर्भ छवियों का एक संग्रह को इकट्ठा किए जो एक तंत्रिका नेटवर्क को सिखाते हैं कि जब ये परिवर्तन किए जाते हैं तो क्या होता है, जैसा कि ऑटोएनकोडर प्रणाली इतनी मेहनत से करती हैं?
इसके बजाय, बाद के विचार GAN चेहरे के अभिनय और संश्लेषण अनुसंधान में यह था कि एक इनपुट पहचान पर शायद लक्ष्य-निर्देशित, सामान्य, टेम्पलेटेड परिवर्तनों के अधीन किया जा सकता है जो पहचान-विशिष्ट नहीं हैं। इसका एक उदाहरण यह होगा कि एक GAN चेहरे पर एक अभिव्यक्ति लागू करना जो उस व्यक्ति की किसी भी छवि में मौजूद नहीं था जिसे GAN जानता था।

2022 के पेपर टेंसर-आधारित भावना संपादन में स्टाइलजीएएन लेटेंट स्पेस, टेम्पलेटेड अभिव्यक्तियों को FFHQ डेटासेट से एक इनपुट चेहरे पर लागू किया जाता है। स्रोत: https://arxiv.org/pdf/2205.06102.pdf
यह स्पष्ट है कि एक ‘एक आकार फिट सभी’ दृष्टिकोण व्यक्तिगत चेहरे की अभिव्यक्तियों की विविधता को कवर नहीं कर सकता है। हमें आश्चर्य होता है कि क्या जैक निकोलसन या विलेम डैफो की तरह एक अनोखी मुस्कान को ऐसे ‘मीन एवरेज एक्सप्रेशन’ लेटेंट कोड्स के प्रभाव में विश्वासपात्र व्याख्या मिल सकती है।

यह आकर्षक लैटिन अजनबी कौन है? GAN अधिक यथार्थवादी और उच्च-रिज़ॉल्यूशन चेहरा बनाता है, लेकिन परिवर्तन अभिनेता की कई वास्तविक तस्वीरों पर आधारित नहीं होता, जैसा DeepFaceLab में होता है, जो ऐसी हजारों तस्वीरों पर व्यापक प्रशिक्षण करता है। परिणामस्वरूप समानता घटती है। यहाँ पीछे DeepFaceLab मॉडल को DeepFaceLive में आयात किया गया है, जो लोकप्रिय और विवादास्पद सॉफ्टवेयर का स्ट्रीमिंग कार्यान्वयन है। उदाहरण https://www.youtube.com/watch?v=9tr35y-yQRY (2022) और https://arxiv.org/pdf/2205.06102.pdf से हैं।
पिछले कुछ वर्षों में, कई जीएएन चेहरे के अभिव्यक्ति संपादकों को आगे बढ़ाया गया है, जिनमें से अधिकांश अज्ञात पहचान के साथ सौदा करते हैं, जहाँ परिवर्तनों की विश्वसनीयता को सामान्य पाठक के लिए जानना असंभव है, क्योंकि वे परिचित चेहरे नहीं हैं।

2020 की पेशकश कैस्केड-ईएफ-जीएएन में अज्ञात पहचान को परिवर्तित किया जाता है। स्रोत: https://arxiv.org/pdf/2003.05905.pdf
शायद जीएएन चेहरे के संपादक जिसने पिछले तीन वर्षों में सबसे अधिक रुचि (और उद्धरण) प्राप्त किए हैं, इंटरफेसजीएएन है, जो लेटेंट स्पेस में लेटेंट कोड्स को बदलने में सक्षम है जो पोज़ (कैमरा/चेहरे का कोण), अभिव्यक्ति, आयु, नस्ल, लिंग और अन्य आवश्यक गुणों से संबंधित हैं।
इंटरफेसजीएएन और इसी तरह के फ्रेमवर्क की 1980 के दशक की शैली की ‘मॉर्फिंग’ क्षमताएं मुख्य रूप से एक छवि को एक उपयुक्त लेटेंट कोड (जैसे ‘आयु’) के माध्यम से पुनः प्रोजेक्ट करने के रूप में परिवर्तन की दिशा में मार्ग को प्रदर्शित करने का एक तरीका है। समय की निरंतरता वाले वीडियो बनाने के मामले में ऐसे तरीके अब तक “प्रभावशाली आपदाएँ” रहे हैं।
यदि आप इसमें स्थिर रूप से बने रहने वाले बाल बनाने में कठिनाई जोड़ते हैं, और यह तथ्य कि लेटेंट कोड अन्वेषण/मैनिपुलेशन की तकनीक में कोई स्वाभाविक समय संबंधी दिशानिर्देश नहीं हैं (और यह जानना मुश्किल है कि ऐसे दिशानिर्देशों को एक फ्रेमवर्क में कैसे इंजेक्ट किया जाए जो स्थिर छवियों को उत्पन्न करने और वीडियो आउटपुट के लिए कोई स्वाभाविक प्रावधान नहीं है), तो यह तर्कसंगत होगा कि जीएएन चेहरे के वीडियो संश्लेषण के लिए पर्याप्त नहीं है।
अतः, बाद के प्रयासों ने क्रमिक सुधार दिखाए हैं कारकों का पृथक्करण में, जबकि अन्य ने सेमेंटिक सेगमेंटेशन जैसे कंप्यूटर विजन में अन्य सम्मेलनों को एक ‘मार्गदर्शन परत’ के रूप में जोड़ा है, जैसा कि 2021 के पेपर SemanticStyleGAN: Learning Compositional Generative Priors for Controllable Image Synthesis and Editing में।
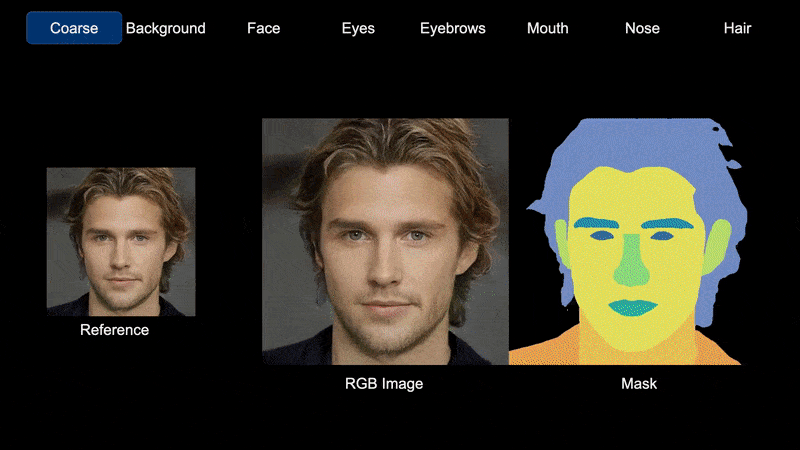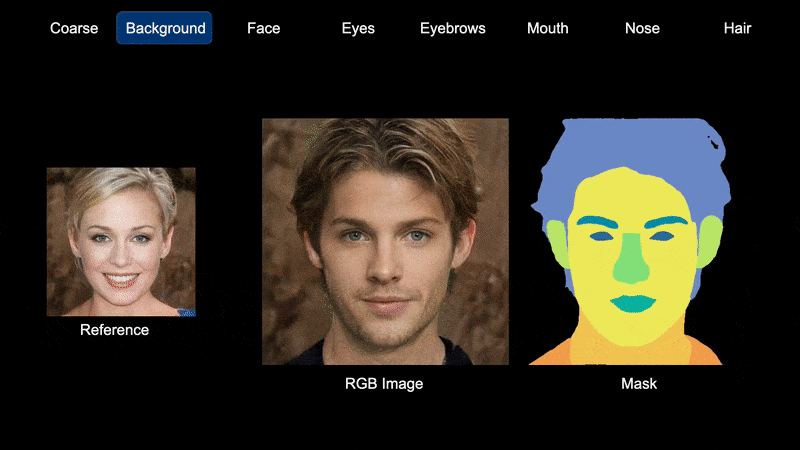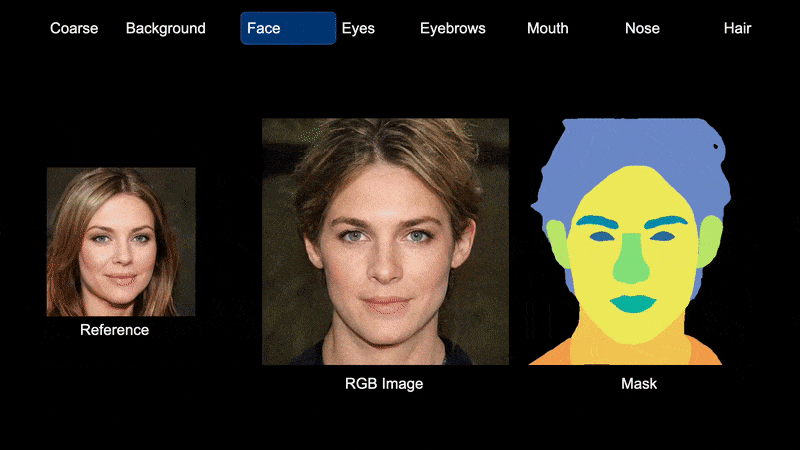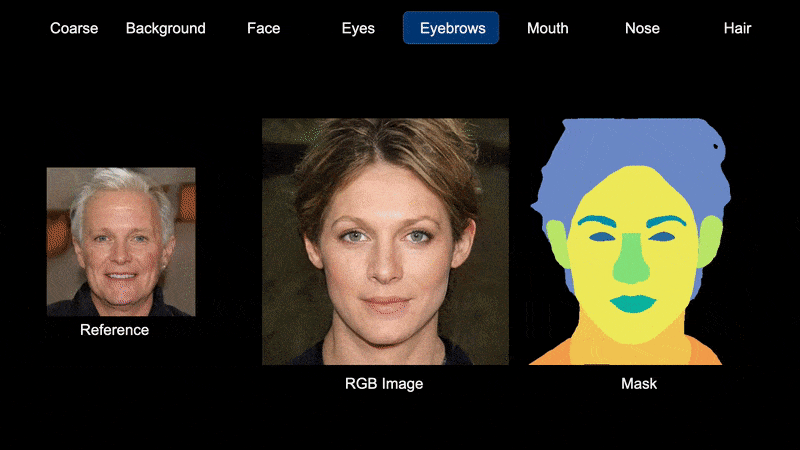
सेमेंटिक स्टाइलजीएएन में लेटेंट स्पेस इंस्ट्रूमेंटैलिटी के रूप में सेमेंटिक सेगमेंटेशन। स्रोत: https://semanticstylegan.github.io/
पैरामेट्रिक मार्गदर्शन
जीएएन चेहरे के संश्लेषण अनुसंधान समुदाय ‘पारंपरिक’ पैरामेट्रिक सीजीआई चेहरों का उपयोग करके जीएएन के लेटेंट स्पेस में आश्चर्यजनक लेकिन अव्यवस्थित लेटेंट कोड्स को मार्गदर्शन और क्रम में लाने की दिशा में बढ़ रहा है।
हालांकि पैरामेट्रिक चेहरे के प्रिमिटिव्स कंप्यूटर विजन अनुसंधान में बीस वर्षों से अधिक समय से एक मानक रहे हैं, इस दृष्टिकोण में हाल के वर्षों में रुचि बढ़ी है, स्किन्ड मल्टी-पर्सन लीनियर मॉडल (एसएमपीएल) सीजीआई प्रिमिटिव्स के बढ़ते उपयोग के साथ, जो मैक्स प्लैंक इंस्टीट्यूट और आईएलएम द्वारा अग्रणी रूप से विकसित किया गया था, और बाद में स्पार्स ट्रेंड आर्टिकुलेटेड ह्यूमन बॉडी रिग्रेसर (एसटीएआर) फ्रेमवर्क के साथ सुधारित हुआ।

एसएमपीएल (इस मामले में एसएमपीएल-एक्स नामक एक विविधता) एक सीजीआई पैरामेट्रिक मेश लगा सकता है जो एक छवि में प्रदर्शित मानव शरीर के पूरे पोज़ (अभिव्यक्तियों सहित) के अनुमानित मूल्य के साथ मेल खाता है, जिससे पैरामेट्रिक मेश को आयतन या धारणा-आधारित मार्गदर्शक बनाकर छवि पर नए संचालन किए जा सकते हैं। स्रोत: https://arxiv.org/pdf/1904.05866.pdf
इस लाइन में सबसे प्रसिद्ध विकास डिज़नी की 2019 की रेंडरिंग विद स्टाइल पहल है, जिसने पारंपरिक टेक्सचर-मैप्स के उपयोग को जीएएन-उत्पन्न छवियों के साथ मिलाया, जिससे बेहतर, ‘गहरे फेक-शैली’ के एनिमेटेड आउटपुट बनाने का प्रयास किया गया।

पुराना मिलता है नए के साथ, डिज़नी के हाइब्रिड दृष्टिकोण में जीएएन-उत्पन्न गहरे फेक। स्रोत: https://www.youtube.com/watch?v=TwpLqTmvqVk
डिज़नी दृष्टिकोण में पारंपरिक रूप से रेंडर किए गए सीजीआई फेसेट्स को एक स्टाइलजीएन2 नेटवर्क में लगाया जाता है ताकि मानव चेहरों को ‘समस्या क्षेत्रों’ में ‘इनपेंट’ किया जा सके, जहाँ वीडियो निर्माण के लिए समय के साथ सुसंगतता एक मुद्दा है – त्वचा की बनावट जैसे क्षेत्र।

रेंडरिंग विद स्टाइल वर्कफ्लो।
चूंकि इस प्रक्रिया को निर्देशित करने वाला पैरामेट्रिक सीजीआई सिर को उपयोगकर्ता के अनुसार बदला जा सकता है, इसलिए जीएएन-उत्पन्न चेहरा उन परिवर्तनों को प्रतिबिंबित करने में सक्षम है, जिसमें सिर के पोज़ और अभिव्यक्ति में परिवर्तन शामिल हैं।
हालांकि पारंपरिक सीजीआई की साधनता को जीएएन चेहरों की प्राकृतिक वास्तविकता के साथ मिलाने के लिए डिज़ाइन किया गया था, परिणाम अंत में दोनों की सबसे खराब दुनिया को प्रदर्शित करते हैं और अभी भी बाल की बनावट और यहां तक कि मूल विशेषता स्थिति को स्थिर रखने में विफल रहते हैं:
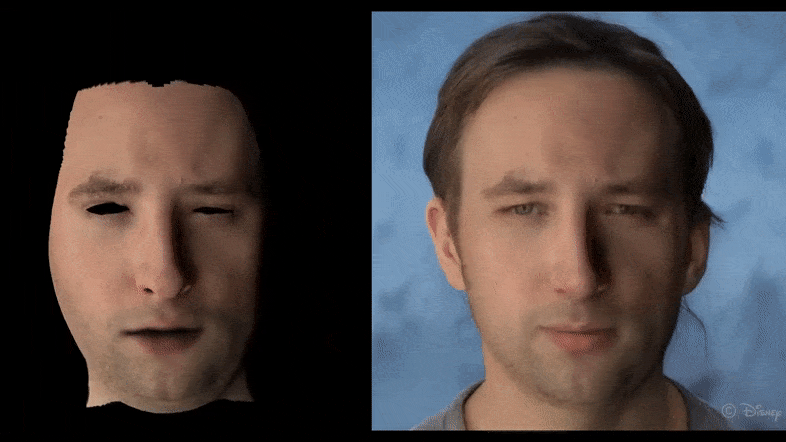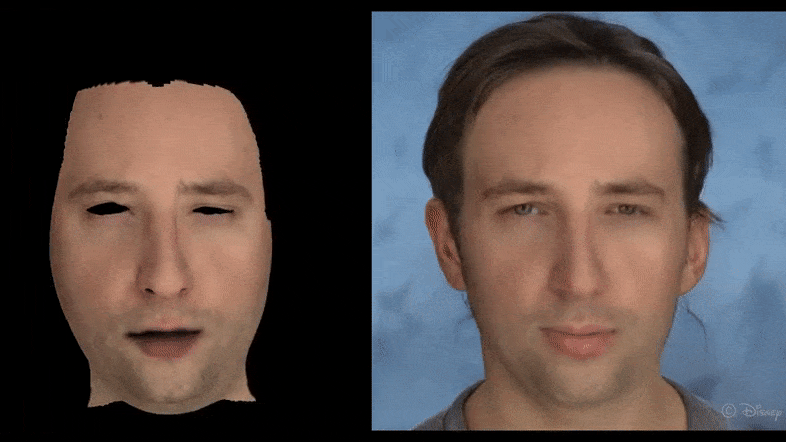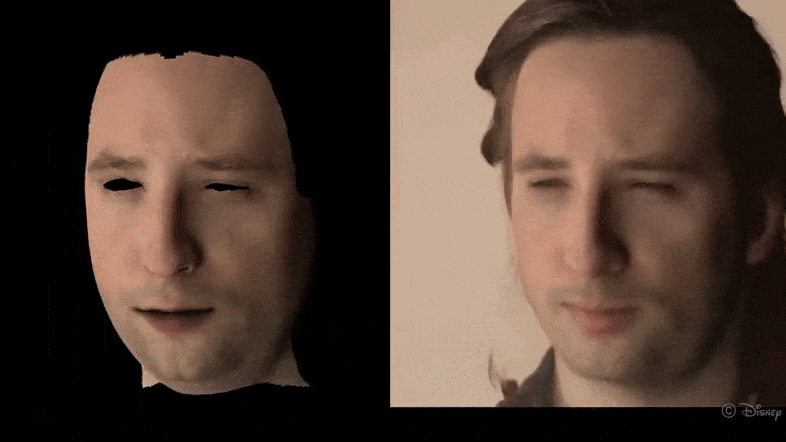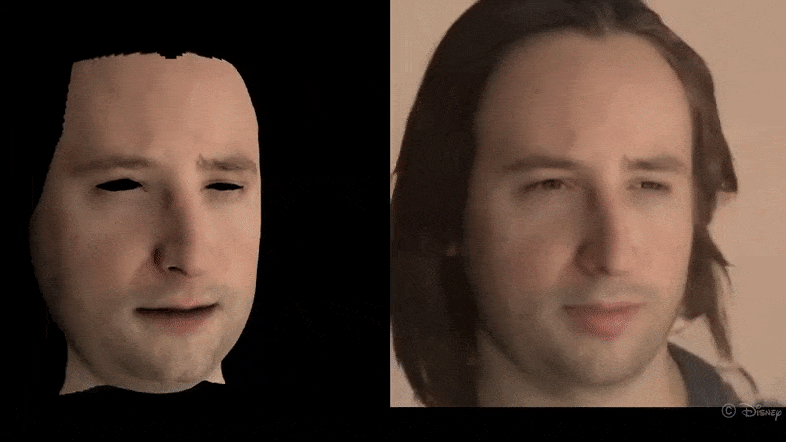
रेंडरिंग विद स्टाइल से एक नए प्रकार की अनकानी घाटी उत्पन्न होती है, हालांकि सिद्धांत अभी भी कुछ संभावना रखता है।
2020 का पेपर StyleRig: Rigging StyleGAN for 3D Control over Portrait Images एक लोकप्रिय दृष्टिकोण का पालन करता है, जिसमें त्रि-आयामी मॉर्फेबल फेस मॉडल (3डीएमएम) का उपयोग स्टाइलजीएन वातावरण में विशेषताओं को बदलने के लिए प्रॉक्सी के रूप में किया जाता है, इस मामले में एक नए रिगिंग नेटवर्क के माध्यम से जिसे रिगनेट कहा जाता है:

स्टाइलरिग में 3डीएमएम लेटेंट स्पेस व्याख्याओं के लिए प्रॉक्सी के रूप में कार्य करते हैं। स्रोत: https://arxiv.org/pdf/2004.00121.pdf
हालांकि, जैसा कि इन पहलों के साथ आम तौर पर होता है, परिणाम अब तक न्यूनतम पोज़ मैनिपुलेशन तक सीमित लगते हैं, और ‘अनजान’ अभिव्यक्ति या भावात्मक अवस्था के परिवर्तन।

स्टाइलरिग नियंत्रण के स्तर में सुधार करता है, हालांकि समय के साथ सुसंगत बाल एक अनसुलझा चुनौती बनी हुई है। स्रोत: https://www.youtube.com/watch?v=eaW_P85wQ9k
मित्सुबिशी रिसर्च के मोस्ट-जीएएन से समान आउटपुट प्राप्त किया जा सकता है, जो 2021 का एक पेपर है जो कारकों का पृथक्करण वास्तुकला के रूप में गैर-रेखीय 3डीएमएम का उपयोग करता है, लेकिन जो भी गतिशील और स्थिर गति को प्राप्त करने में संघर्ष करता है।
कारकों का पृथक्करण और मार्गदर्शन की दिशा में नवीनतम अनुसंधान वन-शॉट फेस रीनैक्टमेंट ऑन मेगापिक्सेल है, जो फिर से स्टाइलजीएन के लिए 3डीएमएम पैरामेट्रिक सिरों का उपयोग करता है:

वन-शॉट फेस रीनैक्टमेंट के MegaFR वर्कफ्लो में नेटवर्क, वास्तविक छवि को अव्यक्त निरूपण में वापस मैप करने के बाद, उसे रेंडर किए गए 3DMM मॉडल से लिए गए पैरामीटरों के साथ मिलाकर चेहरे का संश्लेषण करता है। स्रोत: https://arxiv.org/pdf/2205.13368.pdf
ओएसएफआर एक बढ़ती वर्ग के जीएएन चेहरे के संपादकों में शामिल है जो फोटोशॉप/एफ्टर इफेक्ट्स-शैली के रैखिक संपादन वर्कफ्लो विकसित करने का प्रयास करते हैं जहाँ उपयोगकर्ता एक वांछित छवि इनपुट कर सकता है जिस पर परिवर्तन लागू किए जा सकते हैं, न कि लेटेंट स्पेस में लेटेंट कोड्स की खोज करना जो एक पहचान से संबंधित हैं।
फिर से, पैरामेट्रिक अभिव्यक्तियाँ एक व्यापक और गैर-व्यक्तिगत तरीके से अभिव्यक्ति को इंजेक्ट करने का प्रतिनिधित्व करती हैं, जिससे अपने ढंग से अजीब लगने वाले परिवर्तन होते हैं, जो हमेशा सकारात्मक नहीं होते।

ओएसएफआर में इंजेक्ट की गई अभिव्यक्तियाँ।
जैसा कि पहले के काम में, ओएसएफआर एक छवि से लगभग मूल पोज़ का अनुमान लगा सकता है, और ‘फ्रंटलाइजेशन’ भी कर सकता है, जहाँ एक ऑफ-सेंटर पोज़ की गई छवि को एक मुगशॉट में अनुवादित किया जाता है:

ओएसएफआर में विस्तृत कार्यान्वयन में से एक में मूल (ऊपर) और अनुमानित मुगशॉट छवियाँ।
अभ्यास में, यह प्रकार का अनुमान न्यूरल रेडिएंस फील्ड (नेर्फ) के नीचे कुछ फोटोग्रामेट्री सिद्धांतों के समान है, लेकिन यहाँ ज्यामिति को एक ही फोटो द्वारा परिभाषित किया जाना चाहिए, न कि नेर्फ को 3-4 दृष्टिकोण प्रदान करने के लिए जो मानवों के साथ तंत्रिका 3डी दृश्यों की व्याख्या करने और बनाने में सक्षम बनाते हैं।
(हालांकि NeRF भी अपने आप में सब कुछ नहीं है, क्योंकि चेहरे के वीडियो संश्लेषण में उसे GAN की तुलना में लगभग पूरी तरह से अलग सेट की बाधाओं का सामना करना पड़ता है)
क्या जीएएन फेसियल वीडियो संश्लेषण में एक स्थान है?
एकल स्रोत छवि से गतिशील अभिव्यक्तियाँ और प्रशिक्षण-वितरण से बाहर के पोज़ प्राप्त करना जीएएन चेहरे के संश्लेषण अनुसंधान में वर्तमान में एक जादू जैसी दीवानगी है, मुख्य रूप से क्योंकि जीएएन वर्तमान में उच्च-रिज़ॉल्यूशन और उच्च-विश्वसनीयता वाले न्यूरल चेहरे का उत्पादन करने में सक्षम एकमात्र तरीका है: जबकि ऑटोएनकोडर गहरे फेक फ्रेमवर्क वास्तविक दुनिया के पोज़ और अभिव्यक्तियों के बहुत से प्रशिक्षण पर प्रशिक्षित हो सकते हैं, उन्हें वीआरएएम-प्रतिबंधित इनपुट/आउटपुट रिज़ॉल्यूशन पर संचालित करना होगा, और एक ‘होस्ट’ की आवश्यकता होती है; जबकि नेर्फ भी सीमित है, और – दोनों के विपरीत – वर्तमान में चेहरे की अभिव्यक्तियों को बदलने के लिए कोई स्थापित विधियाँ नहीं हैं, और सामान्य रूप से सीमित संपादन-क्षमता से ग्रस्त है।
ऐसा लगता है कि सटीक CGI/GAN चेहरा-संश्लेषण प्रणाली के लिए आगे बढ़ने का एकमात्र तरीका यह खोजना है कि कई तस्वीरों से बनी पहचान को लेटेंट स्पेस के भीतर कैसे संगठित किया जाए। तब किसी व्यक्ति की पहचान का लेटेंट कोड असंबंधित पोज़ पैरामीटरों के लिए पूरे स्पेस में भटकने के बजाय, परिवर्तनों के संदर्भ के रूप में उसी व्यक्ति की अपनी संबंधित वास्तविक तस्वीरों का उपयोग कर सकेगा।
यहां तक कि ऐसे मामले में, या यदि पूरा स्टाइलजीएन नेटवर्क एक ही पहचान वाले चेहरे के सेट (ऑटोएनकोडर का उपयोग करने वाले प्रशिक्षण सेट के समान) पर प्रशिक्षित किया गया था, तो अभी भी सेमेंटिक तर्क की कमी को सेमेंटिक सेगमेंटेशन या पैरामेट्रिक 3डीएमएम चेहरों जैसी सहायक प्रौद्योगिकियों द्वारा प्रदान किया जाना चाहिए, जो ऐसे दृश्य में कम से कम अधिक सामग्री के साथ काम करेंगे।


