Anderson का एंगल
सीन को समझने वाली AI इमेज मैटिंग

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
मुख्य बिंदुAI मैटिंग अब हरे स्क्रीन के बिना निष्कर्षण का मार्गदर्शन करने के लिए दृश्य विवरण का…
और देखें
- AI मैटिंग अब हरे स्क्रीन के बिना निष्कर्षण का मार्गदर्शन करने के लिए दृश्य विवरण का उपयोग करती है।
- सिस्टम बालों और पारदर्शी बनावट जैसे बारीक विवरणों को संरक्षित करके ट्राइमैप-मुक्त विधियों से बेहतर प्रदर्शन करता है।
- OPPO अनुसंधान संस्थान का SPG-IM महंगी मैन्युअल एनोटेशन को कम करने के लिए छवि कैप्शनिंग का लाभ उठाता है।
2003 DVD रिलीज़ के साथ जारी एक्स्ट्रा डॉक्यूमेंट्री में, जिसमें Alien3 (1992) शामिल है, विज़ुअल इफ़ेक्ट्स के दिग्गज रिचर्ड एडलंड ने फ़ोटोकेमिकल मैट एक्सट्रैक्शन की ‘सूमो रेसलिंग’ को भयावह रूप में याद किया, जो देर 1930 के दशक से लेकर देर 1980 के दशक तक विज़ुअल इफ़ेक्ट्स कार्य को हावी करता रहा। एडलंड ने प्रक्रिया की अनियमित प्रकृति को ‘सूमो रेसलिंग’ कहा, जो शुरुआती 1990 के दशक में डिजिटल नीला/हरा स्क्रीन तकनीकों से तुलना में था (और उन्होंने तब से इस रूपक को दोबारा अपनाया)।
पृष्ठभूमि से एक अग्रभूमि तत्व (जैसे व्यक्ति या अंतरिक्ष यान मॉडल) को निकालना, ताकि कट‑आउट छवि को पृष्ठभूमि प्लेट में सम्मिलित किया जा सके, मूल रूप से एक समान नीले या हरे पृष्ठभूमि के सामने अग्रभूमि वस्तु को फिल्माकर हासिल किया जाता था।
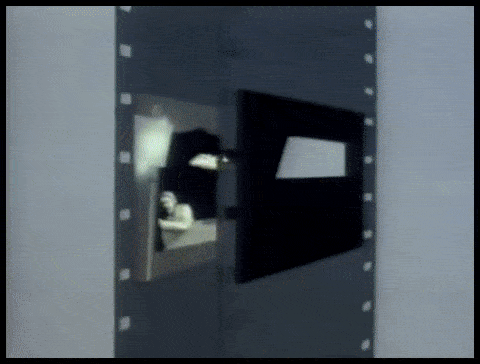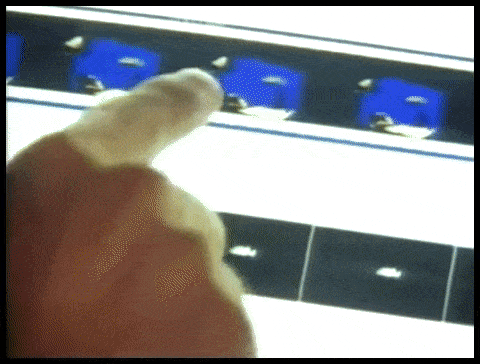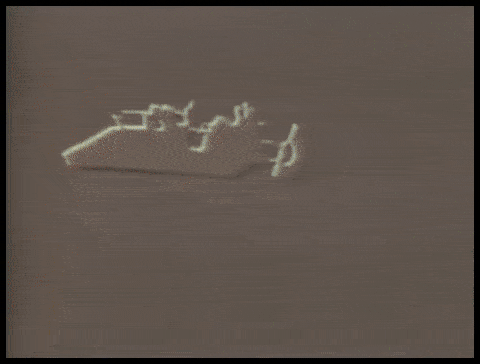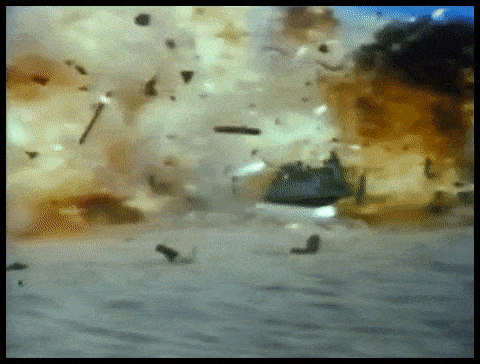
ILM द्वारा Return of the Jedi (1983) के एक VFX शॉट के लिए की गई श्रमसाध्य फोटोकेमिकल पृथक्करण प्रक्रियाएँ।
परिणामी फुटेज में, पृष्ठभूमि रंग को रासायनिक रूप से अलग किया जाता और फिर अग्रभूमि वस्तु (या व्यक्ति) को एक ऑप्टिकल प्रिंटर में पुनः प्रिंट करने के लिए टेम्प्लेट के रूप में उपयोग किया जाता, जिससे वह अन्यथा पारदर्शी फिल्म सेल में एक ‘फ़्लोटिंग’ वस्तु बन जाता।
इस प्रक्रिया को कलर सेपरेशन ओवरले (CSO) कहा जाता था – हालांकि यह शब्द अंततः 1970 और 1980 के दशक के कम बजट वाले टेलीविजन आउटपुट में कच्चे ‘Chromakey’ वीडियो इफ़ेक्ट्स से अधिक जुड़ गया, जो रासायनिक या डिजिटल तरीकों के बजाय एनालॉग द्वारा प्राप्त किए जाते थे।

ब्रिटिश बाल कार्यक्रम Blue Peter के लिए 1970 में कलर सेपरेशन ओवरले का प्रदर्शन। स्रोत: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
किसी भी स्थिति में, चाहे फ़िल्म हो या वीडियो तत्व, उसके बाद निकाली गई फुटेज को किसी भी अन्य फुटेज में सम्मिलित किया जा सकता था।
हालाँकि डिज़्नी की उल्लेखनीय रूप से महँगी और स्वामित्व वाली सोडियम-वाष्प प्रक्रिया (जो विशेष रूप से पीले रंग पर की गई थी, और अल्फ़्रेड हिचकॉक की 1963 हॉरर The Birds में भी उपयोग की गई) बेहतर परिभाषा और स्पष्ट मैट प्रदान करती थी, फिर भी फोटोकेमिकल एक्सट्रैक्शन कठिन और अविश्वसनीय बना रहा।

डिज़्नी की स्वामित्व वाली सोडियम-वाष्प पृथक्करण प्रक्रिया के लिए स्पेक्ट्रम के पीले हिस्से के निकट रंग वाली पृष्ठभूमि चाहिए थी। यहाँ Angela Lansbury, Bedknobs and Broomsticks (1971) के दृश्य-प्रभावों वाले अनुक्रम की शूटिंग के दौरान तारों से लटकी हैं। स्रोत
डिजिटल मैटिंग से परे
1990 के दशक में, डिजिटल क्रांति ने रसायनों को समाप्त कर दिया, लेकिन हरे स्क्रीन की आवश्यकता नहीं। अब यह संभव हो गया था कि फ़ोटोशॉप जैसे पिक्सेल‑एडिटिंग सॉफ़्टवेयर में उस रंग की सहनशीलता सीमा के भीतर पिक्सेल खोजकर हरे (या किसी भी रंग) पृष्ठभूमि को हटाया जा सके, और नई पीढ़ी के वीडियो‑कॉम्पोज़िटिंग सूट जो स्वचालित रूप से रंगीन पृष्ठभूमियों को की कर सकते थे। लगभग एक रात में, साठ साल की ऑप्टिकल प्रिंटिंग उद्योग इतिहास में लिख दी गई।
GPU‑सहायित कंप्यूटर विज़न अनुसंधान के पिछले दस वर्ष मैट एक्सट्रैक्शन को तीसरी युग में ले जा रहे हैं, शोधकर्ताओं को ऐसे सिस्टम विकसित करने की चुनौती दे रहे हैं जो हरे स्क्रीन की आवश्यकता के बिना उच्च‑गुणवत्ता वाले मैट निकाल सकें। केवल Arxiv पर, मशीन लर्निंग‑आधारित अग्रभूमि एक्सट्रैक्शन में नवाचारों से संबंधित पेपर साप्ताहिक रूप से प्रकाशित होते हैं।
हमें चित्र में रखना
AI एक्सट्रैक्शन में शैक्षणिक और उद्योगीय रुचि का यह केंद्र पहले ही उपभोक्ता क्षेत्र को प्रभावित कर चुका है: मोटे लेकिन काम करने योग्य कार्यान्वयन हम सभी को Zoom और Skype फ़िल्टरों के रूप में परिचित हैं, जो वीडियो कॉन्फ़्रेंस कॉल में हमारे लिविंग‑रूम पृष्ठभूमि को उष्णकटिबंधीय द्वीपों आदि से बदल सकते हैं।
हालाँकि, सबसे अच्छे मैट अभी भी हरे स्क्रीन की आवश्यकता रखते हैं, जैसा कि Zoom ने पिछले बुधवार बताया।

बाएँ: हरे पर्दे के सामने खड़ा पुरुष, जिसके बाल Zoom के वर्चुअल बैकग्राउंड फ़ीचर से अच्छी तरह अलग किए गए हैं। दाएँ: सामान्य घरेलू दृश्य के सामने महिला, जिसके बाल एल्गोरिदम से कम सटीकता के साथ और अधिक कंप्यूटिंग संसाधन लगाकर अलग किए गए हैं। स्रोत: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Zoom सपोर्ट प्लेटफ़ॉर्म से एक और पोस्ट चेतावनी देती है कि गैर‑हरे‑स्क्रीन एक्सट्रैक्शन के लिए कैप्चर डिवाइस में अधिक कंप्यूटिंग शक्ति की आवश्यकता होती है।
कट‑आउट की आवश्यकता
गुणवत्ता, पोर्टेबिलिटी और संसाधन अर्थव्यवस्था में सुधार, जो ‘इन द वाइल्ड’ मैट एक्सट्रैक्शन सिस्टम (अर्थात् हरे स्क्रीन की आवश्यकता के बिना लोगों को अलग करना) के लिए है, केवल वीडियो‑कॉन्फ़्रेंसिंग फ़िल्टरों से अधिक कई क्षेत्रों और प्रयोजनों के लिए प्रासंगिक हैं।
डेटासेट विकास के लिए, उन्नत चेहरे, पूर्ण‑सिर और पूर्ण‑शरीर पहचान यह सुनिश्चित करने की संभावना प्रदान करती है कि अनावश्यक पृष्ठभूमि तत्व मानव विषयों के कंप्यूटर विज़न मॉडलों में प्रशिक्षित न हों; अधिक सटीक अलगाव सेमांटिक सेगमेंटेशन तकनीकों को बहुत सुधार देगा, जो डोमेनों (जैसे ‘cat’, ‘person’, ‘boat’) को अलग करने और सम्मिलित करने के लिए डिज़ाइन की गई हैं, और VAE और ट्रांसफ़ॉर्मर-आधारित इमेज सिंथेसिस सिस्टम जैसे OpenAI के नए DALL‑E 2 को सुधारेंगे; और बेहतर एक्सट्रैक्शन एल्गोरिदम महंगे मैन्युअल रोटोस्कोपिंग की आवश्यकता को कम करेंगे, जो महंगे VFX पाइपलाइन में होती है।
वास्तव में, मल्टीमॉडल (आमतौर पर टेक्स्ट/इमेज) पद्धतियों का उदय, जहाँ ‘cat’ जैसे डोमेन को इमेज और संबंधित टेक्स्ट संदर्भ दोनों के रूप में एन्कोड किया जाता है, पहले ही इमेज प्रोसेसिंग में प्रवेश कर रहा है। एक हालिया उदाहरण Text2Live आर्किटेक्चर है, जो मल्टीमॉडल (टेक्स्ट/इमेज) प्रशिक्षण का उपयोग करके वीडियो बनाता है, जिसमें अनगिनत संभावनाओं में क्रिस्टल के हंस और काँच के जिराफ़ शामिल हैं।
सीन‑अवेयर AI मैटिंग
AI‑आधारित स्वचालित मैटिंग पर बहुत सारे शोध ने छवि या वीडियो फ्रेम के भीतर पिक्सेल‑आधारित समूहों की सीमा पहचान और मूल्यांकन पर ध्यान केंद्रित किया है। हालांकि, चीन से नया शोध एक एक्सट्रैक्शन पाइपलाइन प्रस्तुत करता है जो सीन के टेक्स्ट-आधारित विवरणों (एक मल्टीमॉडल दृष्टिकोण जो पिछले 3‑4 वर्षों में कंप्यूटर विज़न शोध क्षेत्र में लोकप्रिय हुआ है) का उपयोग करके विभेदन और मैट गुणवत्ता को सुधारता है, और कई तरीकों से पूर्व विधियों से बेहतर होने का दावा करता है।

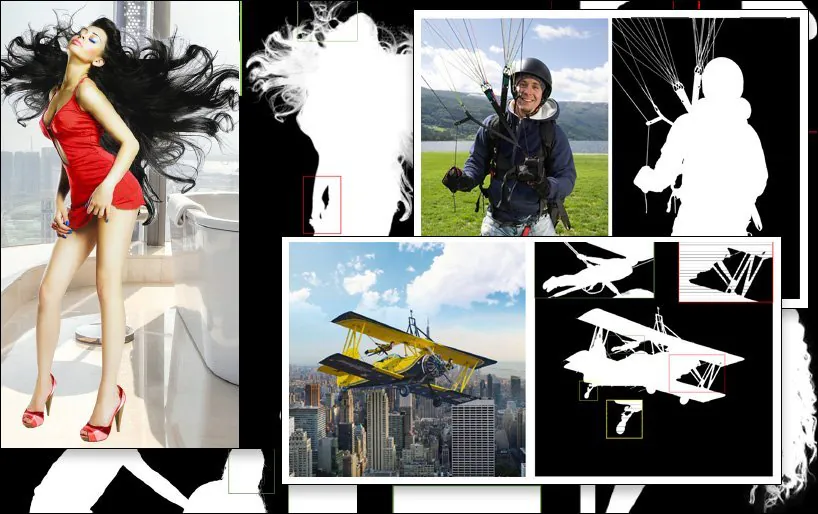
पुरानी प्रतिस्पर्धी विधियों की तुलना में SPG-IM से पृथक्करण का उदाहरण (अंतिम चित्र, नीचे दाएँ)। स्रोत: https://arxiv.org/pdf/2204.09276.pdf
एक्सट्रैक्शन अनुसंधान उप‑क्षेत्र के सामने चुनौती यह है कि ऐसे कार्य‑प्रवाह तैयार किए जाएँ जिनके लिए न्यूनतम मैन्युअल एनोटेशन और मानवीय हस्तक्षेप की आवश्यकता हो – आदर्श रूप में, कोई नहीं। लागत प्रभावों के अलावा, नए पेपर के शोधकर्ता देखते हैं कि विभिन्न संस्कृतियों में आउटसोर्स्ड क्राउडवर्कर्स द्वारा किए गए एनोटेशन और मैन्युअल सेगमेंटेशन छवियों को विभिन्न तरीकों से लेबल या विभाजित कर सकते हैं, जिससे असंगत और असंतोषजनक एल्गोरिदम उत्पन्न होते हैं।
इसका एक उदाहरण है कि ‘फ़ोरग्राउंड ऑब्जेक्ट’ को कैसे परिभाषित किया जाता है, इसकी व्यक्तिपरक व्याख्या:

नए पेपर से: पुरानी विधियाँ LFM और MODNet अग्रभूमि सामग्री को अलग-अलग तरह से परिभाषित करती हैं और उनकी प्रभावशीलता भी अलग है। नया SPG-IM दृश्य के संदर्भ से पास की सामग्री को बेहतर ढंग से अलग करता है। GT का अर्थ Ground Truth है—एक आदर्श संदर्भ परिणाम, जिसे अक्सर हाथ से या गैर-एल्गोरिदमिक विधियों से तैयार किया जाता है।
इसे संबोधित करने के लिए, शोधकर्ताओं ने Situational Perception Guided Image Matting (SPG‑IM) नामक दो‑स्तरीय पाइपलाइन विकसित की है। दो‑स्तरीय एन्कोडर/डिकोडर आर्किटेक्चर में Situational Perception Distillation (SPD) और Situational Perception Guided Matting (SPGM) शामिल हैं।

SPG-IM आर्किटेक्चर।
पहले, SPD दृश्य‑से‑पाठ फीचर ट्रांसफ़ॉर्मेशन को प्री‑ट्रेन करता है, जिससे उनकी संबंधित छवियों के अनुरूप कैप्शन उत्पन्न होते हैं। इसके बाद, पाइपलाइन को एक नवीन सैलिएंसी प्रेडिक्शन तकनीक से जोड़कर फ़ोरग्राउंड मास्क भविष्यवाणी सक्षम की जाती है।
फिर SPGM पहले मॉड्यूल में प्राप्त किए गए जनरेटेड मास्क और कच्चे RGB इमेज इनपुट के आधार पर अनुमानित अल्फ़ा मैट आउटपुट करता है।
उद्देश्य सीन‑अवेयर परसेप्शन गाइडेंस है, जिसमें सिस्टम को छवि के घटकों की संदर्भात्मक समझ होती है, जिससे वह उदाहरण के तौर पर जटिल बालों को पृष्ठभूमि से निकालने की चुनौती को उस विशिष्ट कार्य की ज्ञात विशेषताओं के विरुद्ध फ्रेम कर सके।

नीचे के उदाहरण में SPG-IM समझता है कि डोरियाँ पैराशूट का अभिन्न हिस्सा हैं, जबकि MODNet इन विवरणों को बनाए रखने और अलग करने में विफल रहता है। ऊपर के उदाहरण में भी MODNet खेल के उपकरण की पूरी संरचना को मनमाने ढंग से खो देता है।
नया पेपर शीर्षक Situational Perception Guided Image Matting रखता है, और यह OPPO रिसर्च इंस्टीट्यूट, PicUp.ai, और Xmotors के शोधकर्ताओं द्वारा लिखा गया है।
बुद्धिमान स्वचालित मैट्स
SPG‑IM एक Adaptive Focal Transformation (AFT) रीफ़ाइनमेंट नेटवर्क भी प्रदान करता है जो स्थानीय विवरण और वैश्विक संदर्भ को अलग‑अलग प्रोसेस कर सकता है, जिससे ‘बुद्धिमान मैट्स’ को सक्षम बनाता है।

दृश्य के संदर्भ को समझना—यहाँ घोड़े के साथ लड़की—पुरानी विधियों की तुलना में अग्रभूमि को अलग करना आसान बना सकता है।
पेपर में कहा गया है:
“हम मानते हैं कि चित्र से पाठ बनाने वाले कार्य, जैसे चित्रों के कैप्शन लिखना, से प्राप्त दृश्य प्रतिनिधित्व अधिक व्यापक अर्थ-संबंधी संकेतों पर केंद्रित होते हैं—(क) वस्तुओं के आपसी संबंधों और (ख) वस्तुओं तथा उनके आसपास के वातावरण के संबंधों पर। इससे ऐसे विवरण बनाए जा सकते हैं जो समग्र जानकारी और स्थानीय बारीकियाँ, दोनों समेटें। इसके अलावा, इमेज मैटिंग के लिए महँगे पिक्सेल-स्तरीय एनोटेशन की तुलना में पाठ लेबल बहुत कम लागत पर बड़ी संख्या में एकत्र किए जा सकते हैं।”
आर्किटेक्चर की SPD शाखा को University of Michigan के VirTex ट्रांसफ़ॉर्मर‑आधारित टेक्स्टुअल डिकोडर के साथ संयुक्त रूप से प्री‑ट्रेन किया गया है, जो अर्थ‑सघन कैप्शन से दृश्य प्रतिनिधित्व सीखता है।

VirTex चित्र-कैप्शन युग्मों से ConvNet और ट्रांसफ़ॉर्मर को संयुक्त रूप से प्रशिक्षित करता है तथा सीखी गई जानकारी को ऑब्जेक्ट डिटेक्शन जैसे आगे के कंप्यूटर विज़न कार्यों में इस्तेमाल करता है। स्रोत: https://arxiv.org/pdf/2006.06666.pdf
अन्य परीक्षणों और एब्लेशन अध्ययनों के साथ, शोधकर्ताओं ने SPG-IM की तुलना अत्याधुनिक ट्रिमैप-आधारित विधियों से की: Deep Image Matting (DIM), IndexNet, Context-Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA और Semantic Image Matting (SIM)।
परीक्षण में शामिल अन्य पुराने फ्रेमवर्क में ट्रिमैप के बिना काम करने वाली विधियाँ LFM, HAttMatting और MODNet थीं। निष्पक्ष तुलना के लिए परीक्षण विधियों को उनकी अलग-अलग कार्यप्रणालियों के अनुसार ढाला गया। जहाँ कोड उपलब्ध नहीं था, शोधकर्ताओं ने पेपर में बताए गए आर्किटेक्चर से तकनीक को दोबारा बनाया।
नए पेपर में कहा गया है:
“हमारा SPG-IM सभी प्रतिस्पर्धी ट्रिमैप-रहित विधियों ([LFM], [HAttMatting] और [MODNet]) से बड़े अंतर से बेहतर प्रदर्शन करता है। साथ ही हमारा मॉडल सार्वजनिक डेटासेट (Composition-1K, Distinction-646 और Human-2K) तथा हमारे Multi-Object-1K बेंचमार्क पर सभी चार मापदंडों के अनुसार अत्याधुनिक (SOTA) ट्रिमैप-आधारित और मास्क-निर्देशित विधियों से भी उल्लेखनीय रूप से बेहतर है।”
पेपर आगे कहता है:
“स्पष्ट रूप से देखा जा सकता है कि हमारी विधि ट्रिमैप के मार्गदर्शन के बिना बारीक विवरण (जैसे बालों के सिरे, पारदर्शी बनावट और किनारे) सुरक्षित रखती है। इसके अलावा, अन्य प्रतिस्पर्धी ट्रिमैप-रहित मॉडलों की तुलना में हमारा SPG-IM अधिक समग्र अर्थगत पूर्णता बनाए रख सकता है।”


पहली बार प्रकाशित 24 अप्रैल 2022।