
Anderson का एंगल
एडोब रिसर्च ने विशेषताओं को अलग रखते हुए GAN से चेहरे के संपादन को आगे बढ़ाया

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
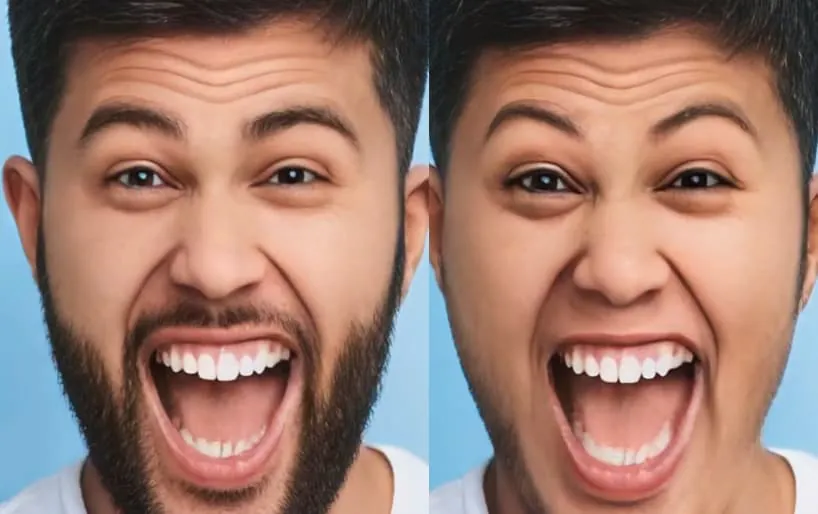
मुख्य बिंदुएडोब का लेटेंट-टू-लेटेंट मैपर पुनर्प्रशिक्षण के बिना 35 चेहरे की विशेषताओं को संपादित…
और देखें
- एडोब का लेटेंट-टू-लेटेंट मैपर पुनर्प्रशिक्षण के बिना 35 चेहरे की विशेषताओं को संपादित करते हुए पहचान को स्थिर रखता है।
- यह प्रणाली विशेषता परिवर्तनों के दौरान पहचान में गिरावट को रोकने के लिए फेसनेट को एक विभेदक के रूप में उपयोग करती है।
- इंटरफेसजीएएन जैसे प्रतिद्वंद्वी ढांचे उम्र को लिंग या चश्मे से उलझा देते हैं, लेकिन एडोब का दृष्टिकोण इन दुष्प्रभावों से बचता है।
यह समझना मुश्किल नहीं है कि विशेषताओं का आपस में उलझाव इमेज सिंथेसिस में एक समस्या क्यों है, क्योंकि यह अक्सर जीवन के अन्य क्षेत्रों में एक समस्या है; उदाहरण के लिए, बर्गर से अचार निकालने की तुलना में करी से हल्दी निकालना कहीं अधिक कठिन है, और एक कप कॉफी से उसकी मिठास हटाना लगभग असंभव है। कुछ चीजें बस बंडल में आती हैं।
इसी तरह, विशेषताओं का आपस में उलझाव एक रुकावट है जो इमेज सिंथेसिस आर्किटेक्चर के लिए है जो वास्तव में अलग-अलग विशेषताओं और अवधारणाओं को अलग करना चाहेगा जब वे मशीन लर्निंग का उपयोग करके चेहरे (या कुत्ते, नाव, या किसी अन्य डोमेन) बनाने या संपादित करने के लिए करते हैं।
यदि आप आयु, लिंग, बालों का रंग, त्वचा का रंग, भावना, और इस तरह की धाराओं को अलग कर सकते हैं, तो आपके पास वास्तव में एक फ्रेमवर्क की शुरुआत होगी जो चेहरे की छवियों को वास्तव में ग्रैन्युलर स्तर पर बना सकता है और संपादित कर सकता है, बिना अवांछित ‘यात्रियों’ को इन रूपांतरणों में खींचे।

अधिकतम विशेषताओं का आपस में उलझाव (बाएं), आप केवल एक सीखे हुए जीएएन नेटवर्क की छवि को दूसरे व्यक्ति की छवि में बदल सकते हैं।
यह वास्तव में नवीनतम एआई कंप्यूटर विजन प्रौद्योगिकी का उपयोग करके कुछ हासिल करने के लिए है जो तीस साल पहले दूसरे तरीकों से हल किया गया था।
कुछ अलगाव के साथ (‘मध्यम अलगाव’ ऊपर की छवि में), यह संभव है कि शैली-आधारित परिवर्तन जैसे बालों का रंग, अभिव्यक्ति, सौंदर्य उत्पाद, और सीमित सिर घुमाव, आदि किए जा सकते हैं।

स्रोत: FEAT: Face Editing with Attention, फरवरी 2022, https://arxiv.org/pdf/2202.02713.pdf
पिछले दो वर्षों में, कई प्रयास किए गए हैं जो इंटरैक्टिव फेस-एडिटिंग वातावरण बनाने के लिए हैं जो उपयोगकर्ता को स्लाइडर्स और अन्य पारंपरिक यूआई इंटरैक्शन के साथ चेहरे की विशेषताओं को बदलने की अनुमति देते हैं, जबकि लक्ष्य चेहरे की मूल विशेषताओं को संरक्षित करते हुए जोड़ या परिवर्तन करते हैं। हालांकि, यह जीएएन के लेटेंट स्पेस में अंतर्निहित विशेषता/शैली विशेषताओं का आपस में उलझाव के कारण एक चुनौती साबित हुई है।
उदाहरण के लिए, चश्मा विशेषता अक्सर बूढ़ा विशेषता के साथ जुड़ी हुई है, जिसका अर्थ है कि चश्मा जोड़ने से चेहरे को ‘बूढ़ा’ बना सकता है, जबकि चेहरे को बूढ़ा बनाने से चश्मा जोड़ सकता है, उच्च-स्तरीय विशेषताओं के अलगाव की डिग्री पर निर्भर करता है (देखें ‘परीक्षण’ नीचे के लिए उदाहरण)।
अधिकांश उल्लेखनीय रूप से, यह लगभग असंभव रहा है कि बालों का रंग और अन्य बालों के पहलुओं को बदलने के लिए बिना बालों के धागे और व्यवस्था को पुनः गणना किए, जो एक ‘सिज़लिंग’, संक्रमणकालीन प्रभाव देता है।

स्रोत: InterFaceGAN Demo (CVPR 2020), https://www.youtube.com/watch?v=uoftpl3Bj6w
लेटेंट-टू-लेटेंट जीएएन ट्रैवर्सल
एडोब (ADBE ) के नेतृत्व में WACV 2022 के लिए प्रस्तुत नया शोधपत्र इन बुनियादी समस्याओं के लिए नया तरीका पेश करता है। इसका शीर्षक है Latent to Latent: A Learned Mapper for Identity Preserving Editing of Multiple Face Attributes in StyleGAN-generated Images।
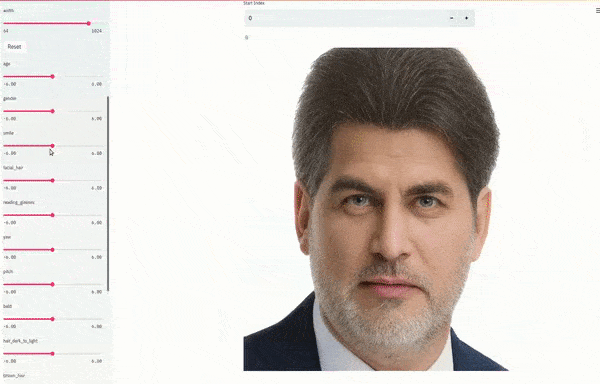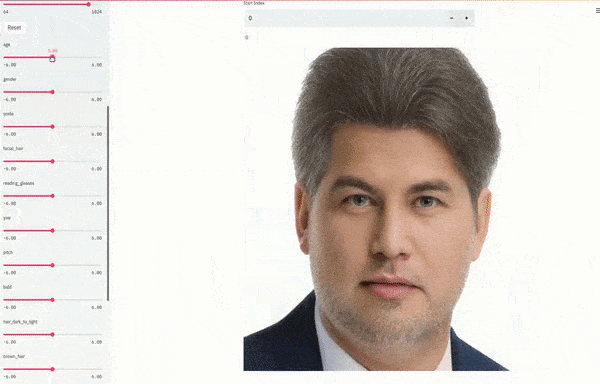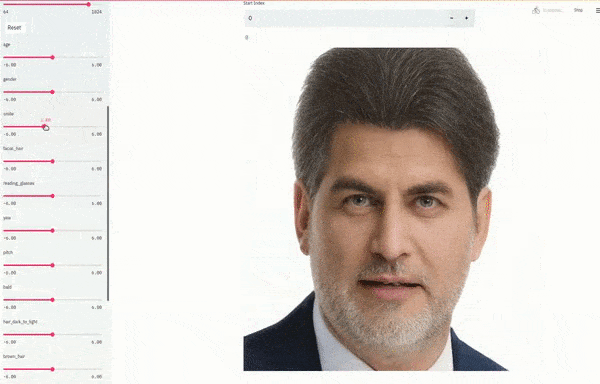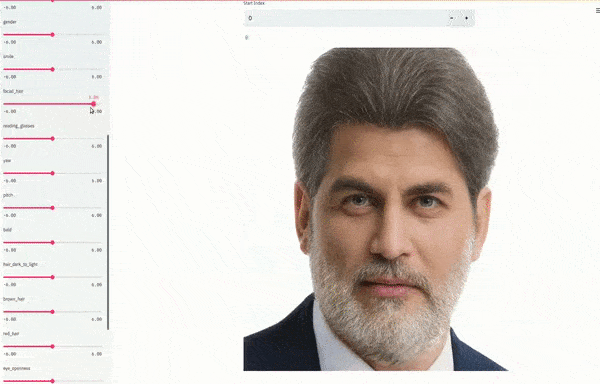
शोधपत्र Latent to Latent: A Learned Mapper for Identity Preserving Editing of Multiple Face Attributes in StyleGAN-generated Images से सहायक सामग्री। यहाँ हम देखते हैं कि सीखे हुए चेहरे में आधार विशेषताएं अनसंबंधित परिवर्तनों में नहीं खींची जाती हैं। लेख के अंत में वीडियो एम्बेड के लिए बेहतर विवरण और रिज़ॉल्यूशन के लिए देखें। स्रोत: https://www.youtube.com/watch?v=rf_61llRH0Q
पेपर एडोब एप्लाइड साइंटिस्ट सियावाश खोदादादेह द्वारा नेतृत्व किया जाता है, साथ ही चार अन्य एडोब शोधकर्ताओं और यूनिवर्सिटी ऑफ सेंट्रल फ्लोरिडा के कंप्यूटर विज्ञान विभाग के एक शोधकर्ता के साथ।
टुकड़ा यह है कि यह क्यों दिलचस्प है क्योंकि एडोब इस स्थान में कुछ समय से काम कर रहा है, और यह कल्पना करना लुभावना है कि यह कार्यक्षमता अगले कुछ वर्षों में एक क्रिएटिव सूट परियोजना में प्रवेश कर सकती है; लेकिन मुख्य रूप से क्योंकि परियोजना के लिए बनाई गई आर्किटेक्चर एक अलग दृष्टिकोण लेती है जीएएन फेस एडिटर में दृश्य अखंडता को बनाए रखने के लिए जबकि परिवर्तन लागू किए जा रहे हैं।
लेखक घोषणा करते हैं:
‘[हम] एक न्यूरल नेटवर्क को प्रशिक्षित करते हैं जो एक लेटेंट-टू-लेटेंट परिवर्तन करता है जो परिवर्तित विशेषता के साथ छवि के लिए संबंधित लेटेंट एन्कोडिंग को ढूंढता है। जैसा कि तकनीक एक-शॉट है, यह एक रैखिक या गैर-रैखिक ट्रेजेक्टरी के परिवर्तन के धीरे-धीरे परिवर्तन पर निर्भर नहीं करता है।
‘पूरे जेनरेशन पाइपलाइन पर नेटवर्क को एंड-टू-एंड प्रशिक्षित करके, सिस्टम ऑफ-द-शेल्फ जेनरेटर आर्किटेक्चर के लेटेंट स्पेस को अनुकूलित कर सकता है। संरक्षण गुण, जैसे कि व्यक्ति की पहचान को बनाए रखना, प्रशिक्षण हानि के रूप में एन्कोड किया जा सकता है।
‘एक बार लेटेंट-टू-लेटेंट नेटवर्क को प्रशिक्षित किया गया, तो इसे मनमानी छवियों के लिए पुनः प्रशिक्षित किए बिना पुनः उपयोग किया जा सकता है।
यह आखिरी बात यह है कि प्रस्तावित आर्किटेक्चर अंतिम उपयोगकर्ता के साथ एक तैयार अवस्था में आता है। यह अभी भी स्थानीय संसाधनों पर एक न्यूरल नेटवर्क चलाने की आवश्यकता है, लेकिन नई छवियों को ‘ड्रॉप इन’ किया जा सकता है और तुरंत परिवर्तन के लिए तैयार हो सकता है, क्योंकि फ्रेमवर्क पर्याप्त रूप से डिकपल है ताकि आगे के छवि-विशिष्ट प्रशिक्षण की आवश्यकता न हो।
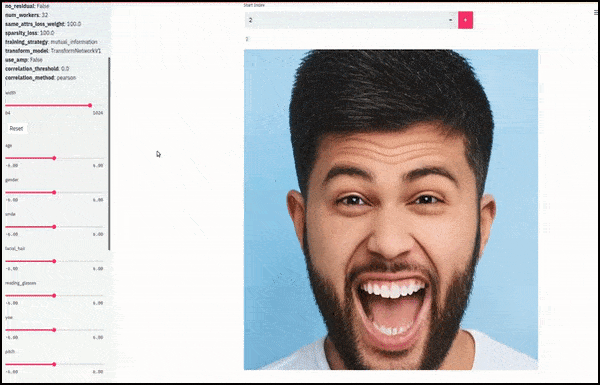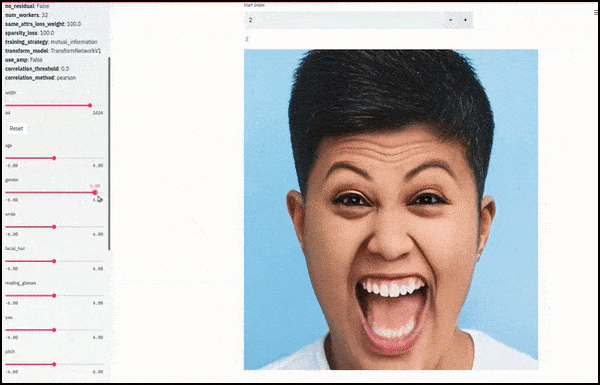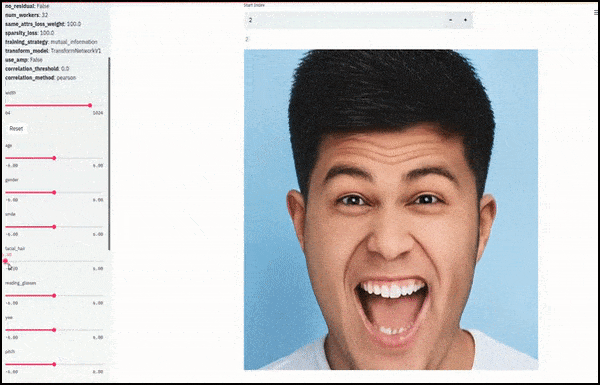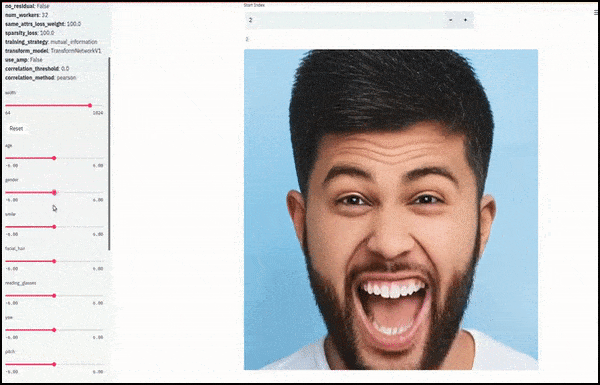
लिंग और चेहरे के बाल बदले जाते हैं क्योंकि स्लाइडर्स मनमानी पथों को लेटेंट स्पेस में प्लॉट करते हैं, केवल ‘अंतिम बिंदुओं के बीच आगे-पीछे जाने’ के बजाय। लेख के अंत में वीडियो एम्बेड के लिए अधिक परिवर्तनों के लिए बेहतर रिज़ॉल्यूशन पर देखें।
काम में मुख्य उपलब्धियों में से एक नेटवर्क की क्षमता है ‘फ्रीज’ पहचान लेटेंट स्पेस में केवल लक्ष्य वेक्टर में विशेषता को बदलकर, और पहचान को बदलने वाले पहचान को संरक्षित करने के लिए ‘सुधार शर्त’ प्रदान करता है।
मूल रूप से, प्रस्तावित नेटवर्क एक व्यापक आर्किटेक्चर में निहित है जो सभी प्रसंस्कृत तत्वों को निर्देशित करता है, जो पूर्व-प्रशिक्षित घटकों से गुजरते हैं जिनके जमे हुए वजन होते हैं जो परिवर्तनों पर अवांछित पार्श्व प्रभाव नहीं पैदा करेंगे।
चूंकि प्रशिक्षण प्रक्रिया ट्रिपलेट पर निर्भर करती है जो एक बीज छवि (जीएएन इनवर्सन के तहत) या एक मौजूदा प्रारंभिक लेटेंट एन्कोडिंग द्वारा उत्पन्न की जा सकती है, पूरी प्रशिक्षण प्रक्रिया अनसुपरवाइज़्ड यानी बिना प्रत्यक्ष पर्यवेक्षण के है, जिसमें सामान्य श्रृंखला के लेबलिंग और क्यूरेशन सिस्टम के कार्यों को पहले से आर्किटेक्चर में समाहित किया जाता है। वास्तव में, नया सिस्टम ऑफ-द-शेल्फ विशेषता रिग्रेसर्स का उपयोग करता है:
‘[हमारे] नेटवर्क द्वारा स्वतंत्र रूप से नियंत्रित की जा सकने वाली विशेषताओं की संख्या केवल पहचानकर्ता मॉडलों की क्षमताओं से सीमित है – यदि आपके पास किसी विशेषता के लिए पहचानकर्ता मॉडल है, तो हम इसे मनमानी चेहरों पर जोड़ सकते हैं। हमारे प्रयोगों में, हमने 35 अलग-अलग चेहरे की विशेषताओं को समायोजित करने के लिए लेटेंट-टू-लेटेंट नेटवर्क को प्रशिक्षित किया, किसी भी पिछले दृष्टिकोण से अधिक।
सिस्टम में एक अतिरिक्त सुरक्षा है जो अवांछित ‘साइड-इफेक्ट’ परिवर्तनों के खिलाफ है: किसी विशेषता में बदलाव के अनुरोध की अनुपस्थिति में, लेटेंट-टू-लेटेंट नेटवर्क एक लेटेंट वेक्टर को स्वयं में मैप करेगा, लक्ष्य पहचान की स्थिर निरंतरता को और बढ़ाता है।
चेहरे की पहचान
पिछले कुछ वर्षों में जीएएन और एनकोडर/डिकोडर-आधारित फेस एडिटर्स के साथ एक बार-बार आने वाला मुद्दा यह है कि लागू परिवर्तन अक्सर समानता को खराब करते हैं। इसे लड़ने के लिए, एडोब परियोजना में एक एम्बेडेड चेहरे की पहचान नेटवर्क का उपयोग किया जाता है जिसे फेसनेट कहा जाता है एक विभेदक के रूप में।

परियोजना की संरचना में FaceNet को शामिल किए जाने के लिए नीचे मध्य-बायाँ हिस्सा देखें। स्रोत: लेटेंट टू लेटेंट: एक सीखा हुआ मैपर StyleGAN से बनी छवियों में चेहरे की कई विशेषताओं का पहचान सुरक्षित रखते हुए संपादन, ओपनएक्सेस।
(एक व्यक्तिगत नोट पर, यह मानक चेहरे की पहचान और यहां तक कि भावना पहचान प्रणालियों को जनरेटिव नेटवर्क में एकीकरण की ओर एक प्रोत्साहित करने वाला कदम लगता है, संभवतः वर्तमान डीपफेक आर्किटेक्चर की अंधे पिक्सेल-टू-पिक्सेल मैपिंग को पार करने का सबसे अच्छा तरीका हो सकता है, क्योंकि मौजूदा प्रणालियाँ चेहरे की अभिव्यक्ति की सटीकता और चेहरे बनाने से जुड़े अन्य महत्वपूर्ण पहलुओं की कीमत पर इस मैपिंग पर निर्भर करती हैं।)
लेटेंट स्पेस में सभी क्षेत्रों तक पहुंच
फ्रेमवर्क की एक और प्रभावशाली विशेषता यह है कि यह मनमानी परिवर्तनों के बीच लेटेंट स्पेस में यात्रा करने में सक्षम है, उपयोगकर्ता की मर्जी से। कई पिछले सिस्टम जो अन्वेषण इंटरफेस प्रदान करते थे, अक्सर उपयोगकर्ता को मूल रूप से ‘स्क्रबिंग’ के बीच तय किए गए फीचर परिवर्तन टाइमलाइन के साथ छोड़ देते थे – प्रभावशाली, लेकिन अक्सर काफी रैखिक या निर्धारित अनुभव।
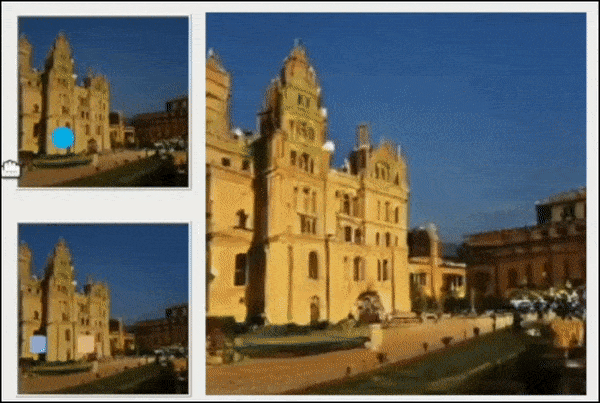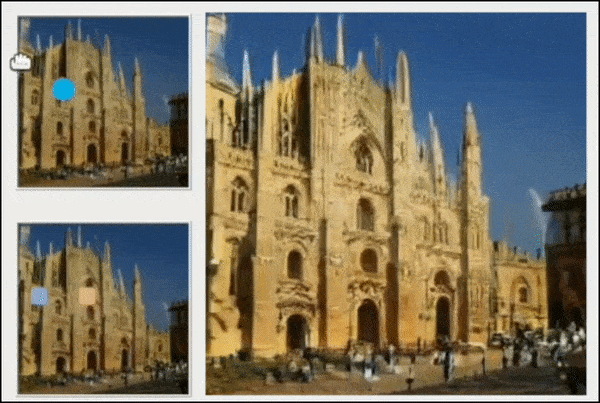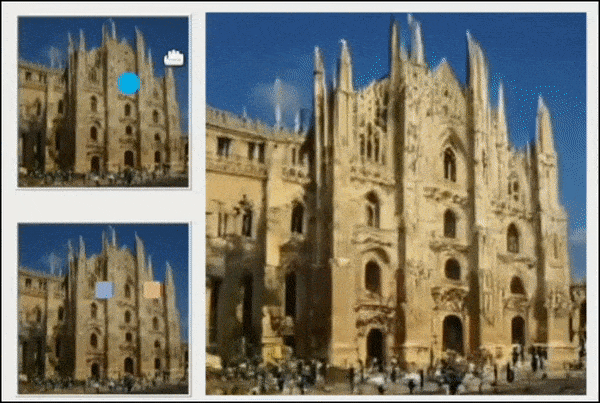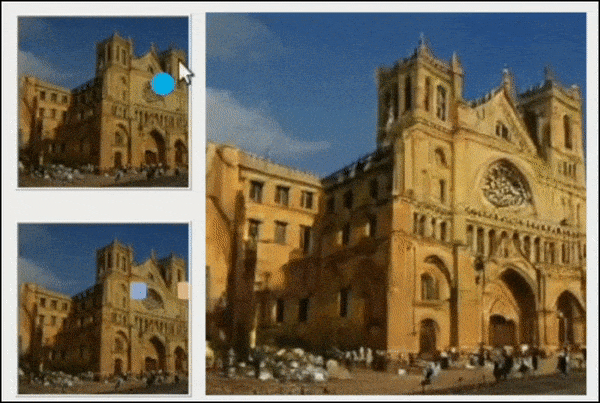
शोधपत्र Improving GAN Equilibrium by Raising Spatial Awareness से: यहाँ उपयोगकर्ता दो लेटेंट स्पेस स्थानों के बीच संभावित परिवर्तन बिंदुओं की एक श्रृंखला के माध्यम से स्क्रब करता है, लेकिन पूर्व-प्रशिक्षित स्थानों के भीतर लेटेंट स्पेस में। इस सामग्री पर आधारित अन्य प्रकार के परिवर्तन लागू करने के लिए, पुनर्गठन और/या पुनः प्रशिक्षण आवश्यक है। स्रोत: https://genforce.github.io/eqgan/
इसके अलावा पूरी तरह से नए उपयोगकर्ता छवियों के प्रति संवेदनशील होने के, उपयोगकर्ता भी परिवर्तन प्रक्रिया के दौरान संरक्षित किए जाने वाले तत्वों को ‘फ्रीज’ कर सकता है। इस तरह, उपयोगकर्ता सुनिश्चित कर सकता है कि (उदाहरण के लिए) पृष्ठभूमि नहीं बदलती है, या आंखें खुली या बंद रहती हैं।
डेटा
विशेषता प्रतिगमन नेटवर्क को तीन डेटासेट पर प्रशिक्षित किया गया था: एफएफएचक्यू, सेलेबएएमास्क-एचक्यू, और एक स्थानीय, जीएएन से बना डेटासेट जो स्टाइलजीएन-वी2 के जेड स्पेस से 400,000 वेक्टर का नमूना लेता है।
बाहरी-वितरण (OOD) छवियों को दूर किया गया था, और विशेषताओं को माइक्रोसॉफ्ट के फेस एपीआई का उपयोग करके निकाला गया था, जिसके परिणामस्वरूप छवि-सेट 90/10 में विभाजित किया गया था, जिससे 721,218 प्रशिक्षण छवियों और 72,172 परीक्षण छवियों की तुलना करने के लिए छोड़ दिया गया था।
परीक्षण
हालांकि प्रयोगात्मक नेटवर्क को शुरू में 35 संभावित परिवर्तनों को समायोजित करने के लिए कॉन्फ़िगर किया गया था, उन्हें तुलनात्मक फ्रेमवर्क इंटरफेसजीएन, जीएनस्पेस, और स्टाइलफ्लो के खिलाफ तुलनात्मक परीक्षण करने के लिए आठ में कम कर दिया गया था।
चुने गए आठ विशेषताएं आयु, गंजापन, दाढ़ी, अभिव्यक्ति, लिंग, चश्मा, पिच, और याव थीं। यह आवश्यक था कि प्रतिस्पर्धी फ्रेमवर्क को कुछ विशेषताओं के लिए फिर से तैयार किया जाए जो मूल वितरण में प्रावधान नहीं किए गए थे, जैसे कि इंटरफेसजीएन में गंजापन और दाढ़ी जोड़ना।
जैसा कि अपेक्षित था, प्रतिद्वंद्वी आर्किटेक्चर में अधिक विशेषताओं का आपस में उलझाव हुआ। उदाहरण के लिए, एक परीक्षण में, इंटरफेसजीएन और स्टाइलफ्लो दोनों ने आयु लागू करने के लिए विषय के लिंग को बदल दिया:

दो प्रतिस्पर्धी फ्रेमवर्क ने ‘आयु’ परिवर्तन में लिंग परिवर्तन को रोल किया, साथ ही उपयोगकर्ता के सीधे अनुरोध के बिना बालों का रंग भी बदल दिया।
इसके अलावा, दो प्रतिद्वंद्वियों ने पाया कि चश्मा और आयु अविभाज्य पहलू हैं:

चश्मा और बालों का रंग परिवर्तन मुफ्त में!
यह शोध के लिए एक समान जीत नहीं है: जैसा कि लेख के अंत में एम्बेडेड वीडियो में देखा जा सकता है, फ्रेमवर्क विविध कोणों (याव) को अनुमानित करने में सबसे कम प्रभावी है, जबकि जीएनस्पेस आयु और चश्मा के लिए एक बेहतर सामान्य परिणाम देता है। लेटेंट-टू-लेटेंट फ्रेमवर्क ने पिच (सिर का कोण) जोड़ने के संबंध में जीएनस्पेस और स्टाइलफ्लो के बराबर परिणाम प्राप्त किए।

परिणाम एमटीसीएनएन चेहरे का पता लगाने वाले के एक कैलिब्रेशन पर आधारित हैं। कम परिणाम बेहतर हैं।
अधिक विवरण और बेहतर रिज़ॉल्यूशन के लिए, लेख के अंत में वीडियो नीचे देखें।
पहली बार 16 फरवरी 2022 को प्रकाशित।





