
Anderson का एंगल
एक मशीन लर्निंग सिस्टम जो आपके पढ़ने के दौरान एक लेख को पुनः लिखता है

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
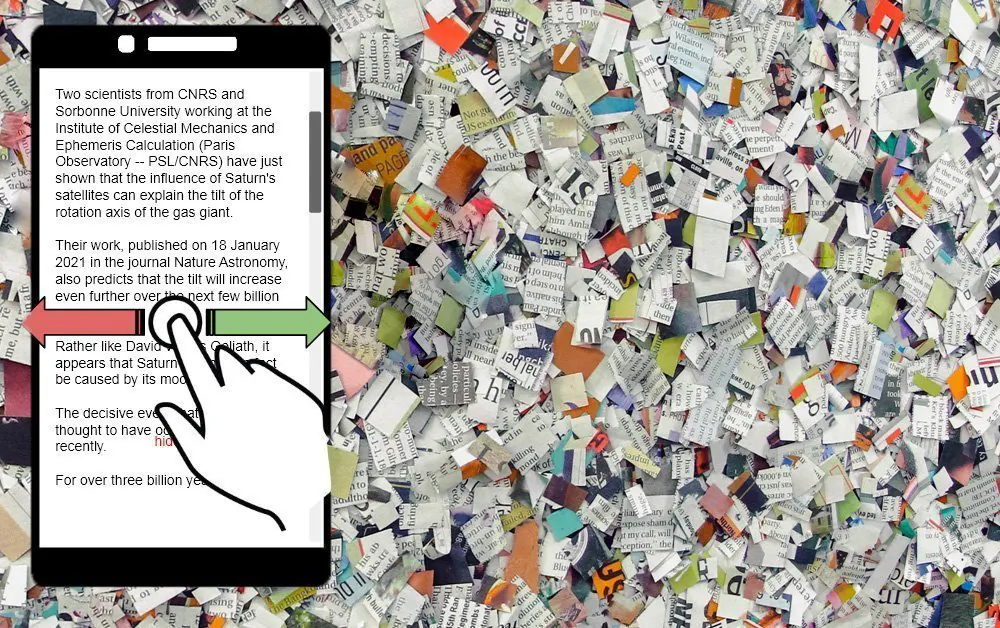
कनाडा से नए शोध में एक तरीका प्रस्तावित किया गया है जो स्वचालित रूप से एक लेख को पुनः लिखता है जब आप इसे पढ़ते हैं, जो टिंडर-शैली के ‘स्वाइपिंग’ या पाठक के विभिन्न प्रकार की सामग्री के साथ बातचीत के निष्क्रिय अवलोकन पर आधारित है।
सिस्टम, जिसे होन एएस यू रीड (एचएआरई) नाम दिया गया है, ओन्टारियो, कनाडा के वेस्टर्न यूनिवर्सिटी से एक पेपर में प्रस्तुत किया गया है, जिसके साथ संबंधित पाइथन कोड गिटहब पर है।
परियोजना का केंद्रीय विचार यह है कि एक लेख विभिन्न प्रकार की सामग्री हो सकती है, जो शीर्षक से लेकर विस्तृत विवरण तक विकसित होती है। लेख के बाद के हिस्सों में विभिन्न प्रकार की सहायक सामग्री, उपयोग के मामले, या समाचार के परिणामों के बारे में अनुमान या अनुमान शामिल हो सकते हैं।
एचएआरई के तहत, यदि आपको उस प्रकार की सामग्री पसंद नहीं है, तो आप प्रत्येक अनुच्छेद के लिए मतदान कर सकते हैं और सिस्टम आपकी पसंद को सीखता है, ताकि जब आप नीचे स्क्रॉल करें, तो आपके द्वारा ‘डाउनवोट’ की गई सामग्री के समान सामग्री पहले ही हटा दी जाती है या पुनः लिखी जाती है। यदि आप सिस्टम को प्रशिक्षित करने में सक्रिय रूप से भाग नहीं लेना चाहते हैं, तो एचएआरई आपके निष्क्रिय बातचीत को देखकर आपके विकल्पों का अनुमान लगा सकता है।
टिंडर-शैली वोटिंग असंतोषजनक वाक्यों के लिए
नीचे दी गई छवि में, हम एचएआरई के लिए तीन संभावित प्रकार के अनुमानित वर्गीकरण देखते हैं, जो उपयोगकर्ता के स्पष्ट या निहित व्यवहार पर आधारित हैं। पहले मामले में (बाएं), उपयोगकर्ता सक्रिय रूप से ‘बाएं स्वाइप’ (या दाएं) करता है, जो एक टिंडर-शैली के मतदान इशारे में सामग्री की सामग्री, शैली, जटिलता या स्वर के प्रति अनुमोदन या असंतोष व्यक्त करता है।

स्रोत: https://arxiv.org/pdf/2105.02923.pdf
दूसरे मामले में (केंद्र), सिस्टम उपयोगकर्ता की रुचि के एक माप के रूप में ड्वेल-टाइम का उपयोग करता है, जो स्क्रॉल पॉज़ की स्थिति और अवधि पर आधारित है।
तीसरे मामले में (दाएं), एचएआरई स्मार्टफोन कैमरे का उपयोग दृश्य दस्तावेजों के अनुच्छेदों में दृष्टि स्थिति और ड्वेल-टाइम का अनुमान लगाने के लिए करता है।
शोधकर्ताओं का दावा है कि किसी भी अनुच्छेद पर बढ़ी हुई ड्वेल समय उपयोगकर्ता की रुचि में वृद्धि को इंगित कर सकता है, हालांकि तार्किक रूप से यह मामला नहीं हो सकता है जहां दृश्य पाठ को आत्मसात करने की कोशिश कर रहा है जो जटिल या खराब लिखा हुआ हो सकता है।

उपयोगकर्ता प्रतिक्रिया प्रभावी रूप से संपादित करती है, पुनः लिखती है या देखे जाने वाले लेख के हिस्सों को पूरी तरह से मिटा देती है।
उपयोगकर्ता की पसंद के अनुसार सामग्री को पूर्व-प्रोसेस करना
लेख उपयोगकर्ता के अनुभव को एक प्रति-लेख आधार पर संबोधित करता है, लेकिन स्पष्ट रूप से उपयोगकर्ता की ऐतिहासिक बातचीत दस्तावेजों के साथ भविष्य के पढ़ने के अनुभवों के लिए अनुकूलन की अनुमति देती है, निरंतर रूप से सामग्री के प्रकार को पहचानती है और नए लेखों में टेम्पलेटेड उपयोगकर्ता पसंद को लागू करती है, ताकि उपयोगकर्ता को कम से कम ‘अवांछित’ सामग्री दिखाई दे।
एचएआरई को एक सारांशक एल्गोरिदम के रूप में वर्णित किया गया है, जो देखे जाने वाले सामग्री को पहले से ही शैली या संक्षिप्तता में पुनः लिखने की अनुमति देता है; लेकिन लेख यह स्पष्ट करता है कि यह उपयोगकर्ता प्रतिक्रिया के आधार पर सामग्री को पहले से हटा सकता है।
परीक्षण के उद्देश्य से, सिस्टम ने यूके के डेली मेल अखबार से 11,222 लेखों का एक कॉर्पस का उपयोग किया, और टेलीग्राम चैट ऐप पर एक परीक्षण तैनाती के माध्यम से इसका मूल्यांकन किया गया। दस पराग्राफ से कम वाले लेखों को परीक्षण उद्देश्यों के लिए त्याग दिया गया था।

टेलीग्राम एचएआरई ऐप उपयोगकर्ताओं के साथ एक परीक्षण चरण में।
शोधकर्ताओं की विधि लेखों में के-मीन्स क्लस्टरिंग का उपयोग करती है एसबीईआरटी वाक्य एम्बेडिंग के साथ, जिसमें पहले से ही यादृच्छिक वजन होते हैं।
विभिन्न एल्गोरिदम और दृष्टिकोणों के बीच, एचएआरई में तीन तुलना मॉडल हैं, जिनमें से पहला (ओआरएसीईलीजीआरईईडीवाई) के पास पहले से उपयोगकर्ता पसंद की जानकारी है, जो यह इंगित करता है कि एल्गोरिदम लोड पर लेखों को पूर्व-प्रोसेस कर सकता है, न कि इंटरैक्टिव रूप से।
अन्य मॉडल, ओआरएसीईलएसओआरटीईडी और ओआरएसीईलयूनिफ़ॉर्म, क्रमशः रुचि स्तर या यादृच्छिक रूप से पूरे लेख में वाक्यों का चयन करते हैं।
सामग्री हटाना और पुनः लेखन
अचंभा की बात है, ओआरएसीईलयूनिफ़ॉर्म ने नियंत्रण सेट को पार किया, हालांकि इसके पास पहले से उपयोगकर्ता हितों तक पहुंच नहीं है। शोधकर्ताओं का दावा है कि यह इसलिए है क्योंकि यह पूरे लेख के साथ एक ही स्वीप में सौदा करता है, ‘केवल सबसे दिलचस्प वाक्यों’ का चयन करता है। शोधकर्ताओं को स्वीकार करते हैं कि यह उपलब्ध सामग्री को केवल उन वाक्यों तक सीमित कर सकता है जो सबसे महत्वपूर्ण अवधारणा से संबंधित हैं, जो तार्किक रूप से अवधारणा के मूल्यांकन या मूल्यांकन से संबंधित अन्य पाठ को हटा सकती है।
एचएआरई में उपयोग किए जाने वाले निकालने वाले सारांशक लेक्सरैंक, संबेसिक, और टेक्स्ट्रैंक हैं।
एचएआरई का 13 स्वयंसेवकों पर 70 परीक्षणों और विभिन्न एल्गोरिदम दृष्टिकोणों के साथ परीक्षण किया गया था, और यह 1.3 मिलीसेकंड और 100 मिलीसेकंड के बीच उपदंश (पुनः लिखित/निकाली गई पाठ) को अद्यतन करने में सक्षम था, जो परीक्षण मॉडल पर निर्भर करता था। परिणामों से पता चला कि जिन मॉडलों ने अधिकांश पाठ हटा दिया, वे अच्छा प्रदर्शन नहीं कर पाए, मुख्य रूप से क्योंकि इससे शेष पाठ की सुसंगतता प्रभावित हो सकती है।
डायनामिक लेख पुनः लेखन के नैतिक परिणाम
शोधकर्ता इस प्रकार की प्रौद्योगिकियों के आसपास नैतिक चिंताओं को स्वीकार करते हैं:
‘एचएआरई कार्य भविष्य के उपयोगकर्ता-सामना करने वाले अनुप्रयोगों के डिजाइन के लिए है। डिजाइन द्वारा, इन अनुप्रयोगों में एक दिए गए लेख से उपयोगकर्ता को क्या पढ़ना है इसे नियंत्रित करने की क्षमता है। यह संभव है कि जब इसे पर्याप्त देखभाल के साथ तैनात किया जाता है, तो ये उपकरण स्वचालित समाचार फीड, खोज परिणामों और ऑनलाइन समुदायों द्वारा पहले से ही उत्पादित “इको चैंबर” प्रभाव को बढ़ा सकते हैं। ‘
हालांकि, वे यह भी ध्यान देते हैं कि ऐसी प्रणाली का उपयोग भविष्य के अनुप्रयोगों में इको चैंबर प्रभाव को कम करने के लिए किया जा सकता है जो शायद मूल रूप से लेख में मौजूद नहीं हो सकते हैं। वे देखते हैं: ‘इस कारक के वजन को एक आकर्षक पढ़ने के अनुभव और विचारों की विविधता के संपर्क को प्रदान करने के लिए समायोजित किया जा सकता है। ‘
ऐसी प्रणाली से लाभान्वित होने वाले व्यक्तियों में, शोधकर्ताओं के अनुसार, जो पाठक जानकारी में समय बचाना चाहते हैं और सामग्री प्रकाशक हैं।


