Fondamentaux de l’IA
Qu’est‑ce que l’apprentissage par renforcement ?

 Ajouter Unite.AI à vos sources préférées sur Google
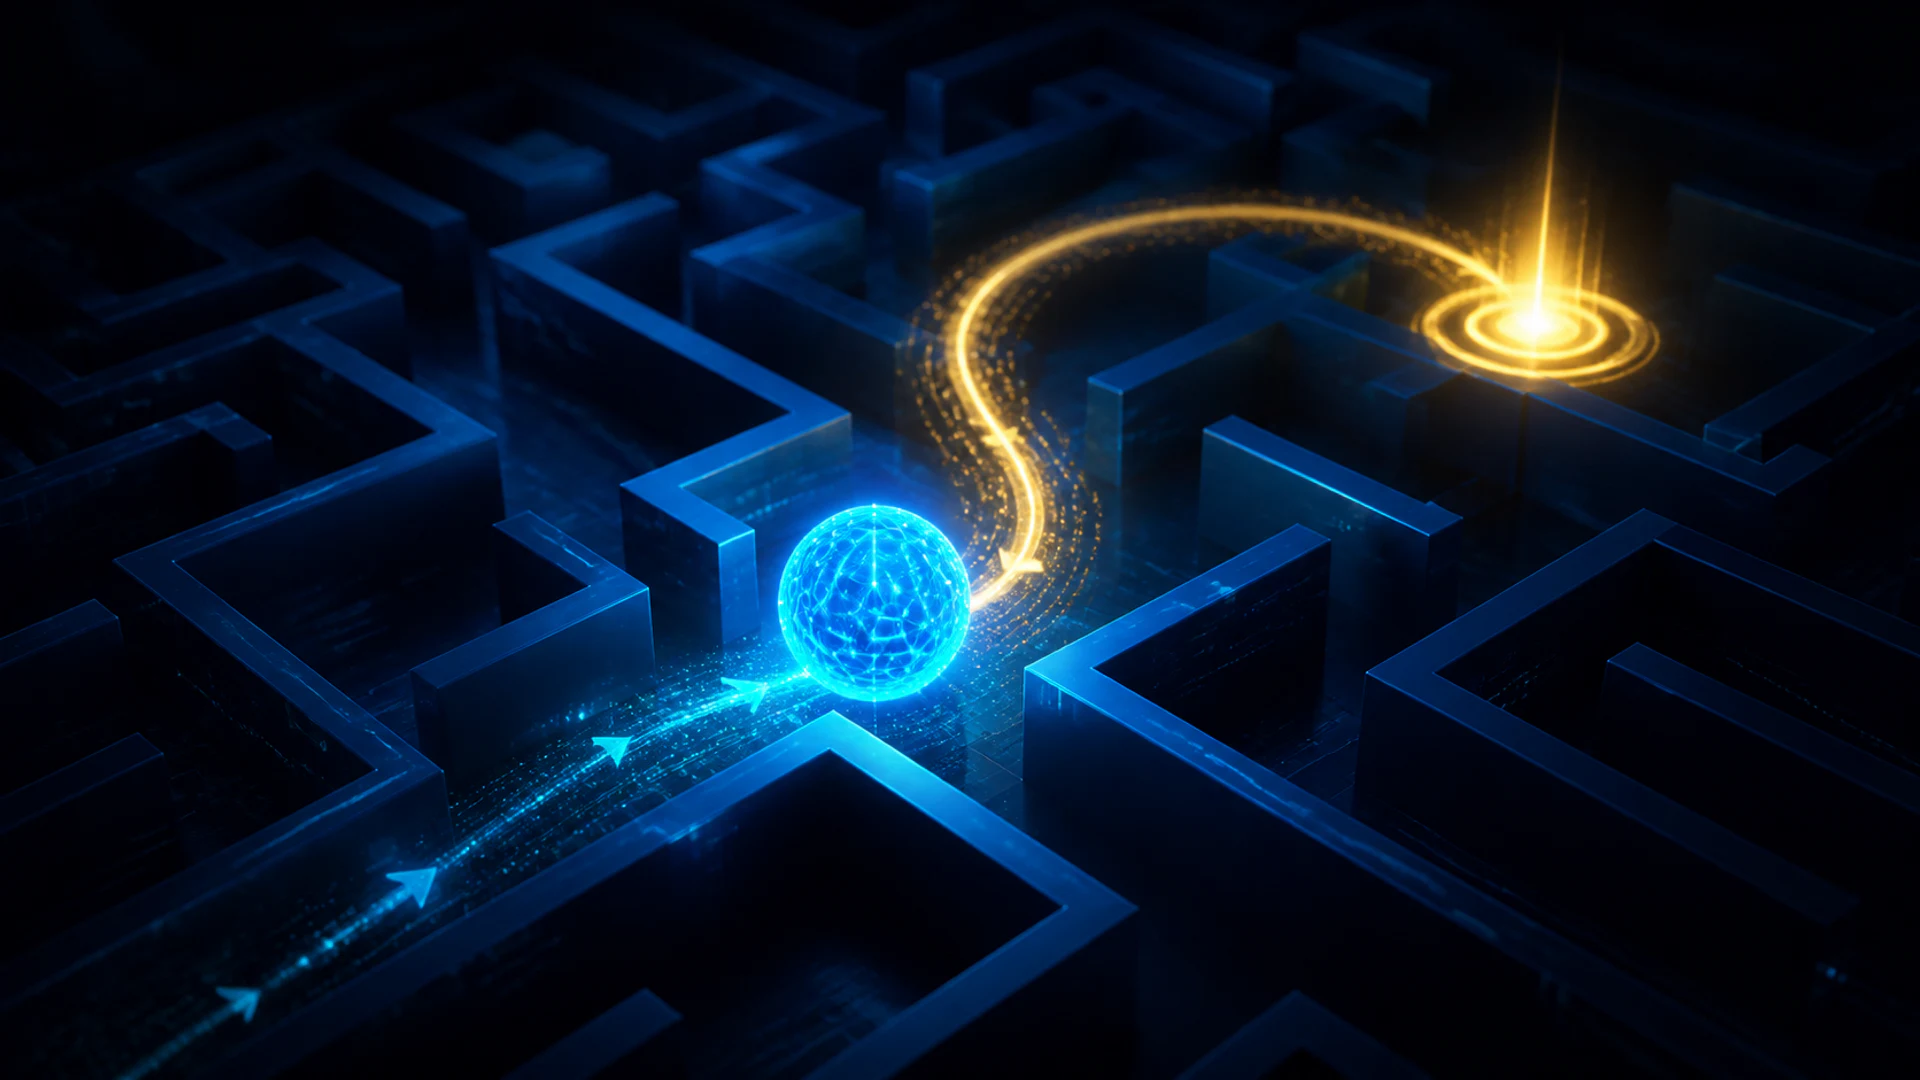
Apprentissage par renforcement (RL) est un cadre d’apprentissage automatique dans lequel un agent apprend comment agir en interagissant avec un environnement. Après chaque action, l’environnement change et peut renvoyer une récompense. L’objectif de l’agent est d’apprendre une politique qui maximise la récompense cumulative attendue, pas seulement la récompense de son prochain mouvement.
Le RL est utilisé lorsque les décisions se déroulent dans le temps et qu’une action influence ce qui se passe ensuite. Il diffère conceptuellement de l’apprentissage supervisé, où un jeu de données fournit une réponse cible pour chaque exemple d’entraînement.
Points clés
- Un problème de RL comprend un agent, un environnement, des états, des actions, des récompenses et une politique.
- Le renforcement positif et négatif augmentent tous deux le comportement ; la punition le diminue.
- L’agent doit équilibrer l’exploration d’actions inconnues et l’exploitation d’actions déjà connues comme efficaces.
- Les méthodes basées sur la valeur, basées sur la politique, acteur‑critique, basées sur le modèle et hors ligne résolvent différents contextes de RL.
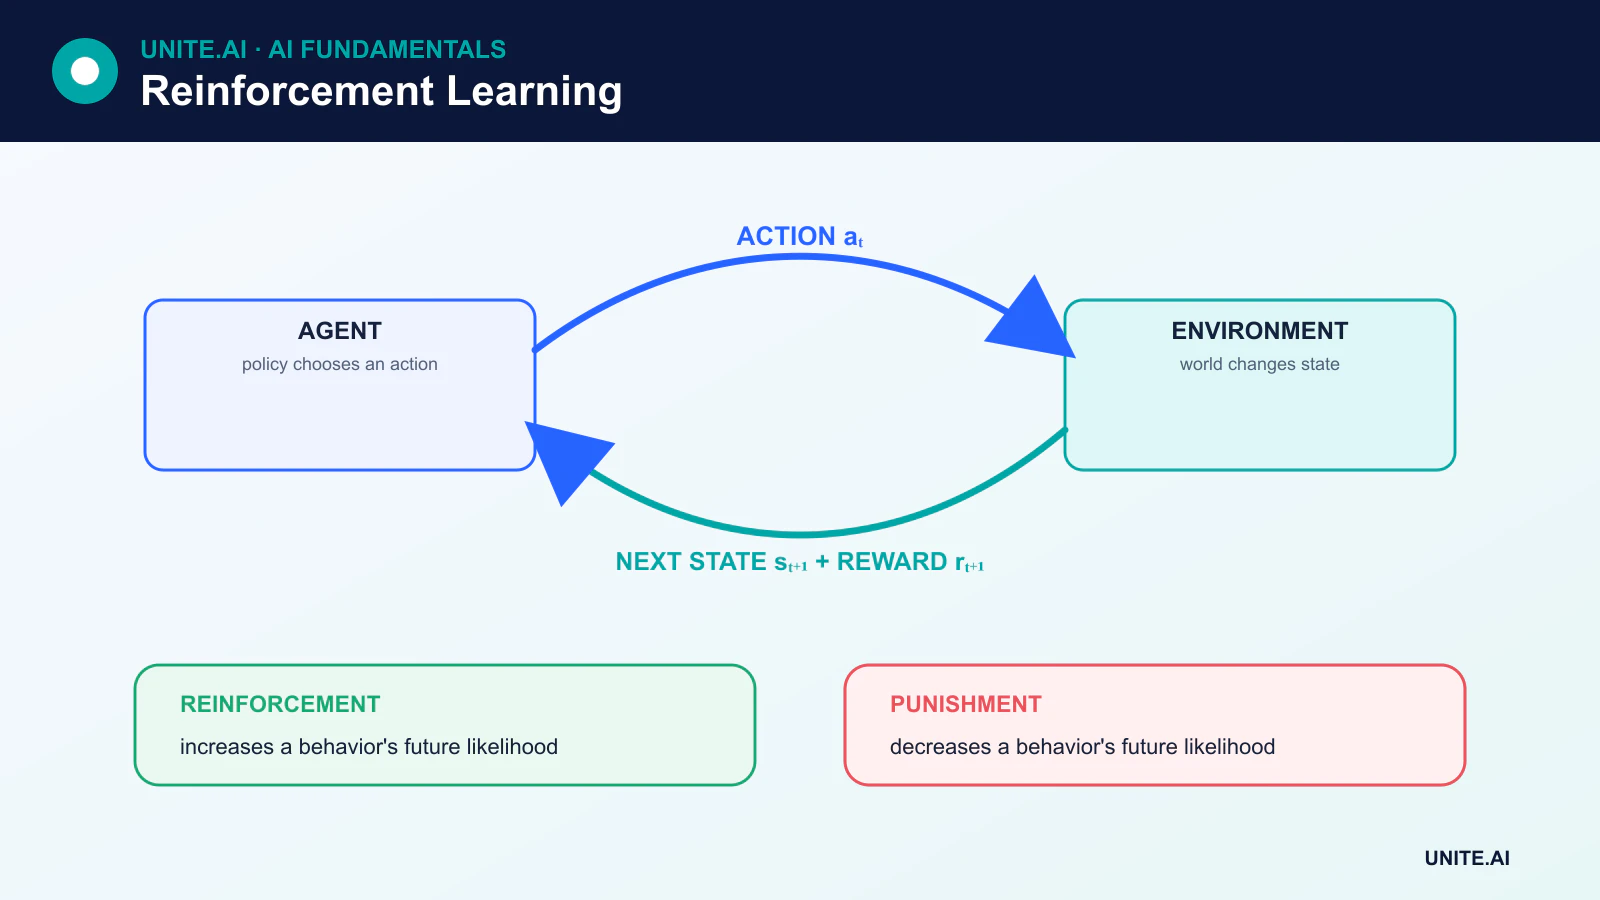
Les composantes de l’apprentissage par renforcement
De nombreux problèmes de RL sont modélisés comme un Processus de décision de Markov (MDP). Un MDP comprend:
- État: informations décrivant la situation actuelle.
- Action: un choix disponible pour l’agent.
- Transition: comment l’état change après une action.
- Récompense: retour immédiat produit par une transition.
- Politique: la stratégie de l’agent pour sélectionner les actions.
- Facteur d’actualisation: l’importance accordée aux récompenses futures par rapport aux récompenses immédiates.
Un état n’a pas besoin de révéler tout ce qui concerne le monde. Lorsque des informations importantes sont cachées, le problème peut être partiellement observable et l’agent peut nécessiter une mémoire ou un état de croyance.
Le renforcement n’est pas identique à la punition
La terminologie provient de la psychologie comportementale. Le renforcement positif ajoute une conséquence qui rend un comportement plus probable. Le renforcement négatif élimine une condition désagréable et rend également un comportement plus probable. Une pénalité destinée à rendre une action moins probable est une punition, pas un renforcement négatif.
En apprentissage automatique, les praticiens parlent plus souvent directement de récompenses positives, de récompenses négatives, de coûts et de pénalités. La question essentielle est la façon dont ces signaux façonnent le retour que l’agent cherche à maximiser.
Retour, valeur et attribution du crédit
Une récompense décrit une transition. Le retour combine les récompenses dans le temps, en appliquant généralement un facteur d’actualisation aux récompenses qui arrivent plus loin dans le futur. Une fonction de valeur d’état estime le retour attendu à partir d’un état, tandis qu’une fonction de valeur d’action estime le retour attendu après avoir pris une action particulière dans cet état.
Cela crée le problème d’attribution du crédit : si un résultat utile apparaît beaucoup plus tard, quelles actions antérieures méritent le crédit ? Les algorithmes de RL diffèrent dans la manière dont ils estiment cette relation.
Apprentissage Monte Carlo et différence temporelle
Les méthodes Monte Carlo apprennent à partir de retours échantillonnés complets, généralement après la fin d’un épisode. Les méthodes de différence temporelle (TD) mettent à jour une estimation avant le résultat final en combinant la récompense observée avec une estimation de ce qui vient ensuite. L’apprentissage TD s’appuie donc sur ses estimations de valeur actuelles.
Aucune des deux familles n’est universellement supérieure. Les cibles Monte Carlo sont non biaisées sous la politique échantillonnée mais peuvent présenter une forte variance et nécessitent la complétion d’un épisode. Les méthodes TD peuvent apprendre en ligne et à partir de tâches continues, mais leurs cibles bootstrappées introduisent un biais.
Exploration versus exploitation
L’exploration recueille des informations en essayant des actions dont la valeur est incertaine. L’exploitation sélectionne l’action que l’on croit actuellement offrir le meilleur retour. Un agent qui n’explore jamais peut se contenter d’une stratégie médiocre ; un agent qui n’exploite jamais ne profite pas de ce qu’il a appris.
Les stratégies simples comprennent la sélection d’actions epsilon‑greedy, l’exploration basée sur la confiance, les bonus d’entropie et les méthodes de récompense intrinsèque. Dans les contextes où la sécurité est cruciale, une exploration sans restriction peut être inacceptable, ainsi la simulation, les contraintes, les données hors ligne ou la supervision humaine deviennent importantes.
Principales approches d’apprentissage par renforcement
Méthodes basées sur la valeur
Le Q‑learning et les algorithmes associés apprennent les valeurs d’action et dérivent une politique en sélectionnant les actions à haute valeur. L’apprentissage profond par renforcement utilise des réseaux de neurones pour approximer les fonctions de valeur ou les politiques lorsque les espaces d’état sont trop grands pour une table.
Méthodes de gradient de politique
Les méthodes de gradient de politique ajustent directement une politique paramétrée afin d’améliorer le retour attendu. Elles sont utiles pour des actions continues et des politiques stochastiques, mais peuvent produire des estimations de gradient à haute variance.
Méthodes acteur‑critique
Un acteur choisit les actions tandis qu’un critique estime la valeur et fournit un signal d’apprentissage. Cela combine l’optimisation directe de la politique avec l’estimation de la valeur.
RL basé sur le modèle et sans modèle
Les systèmes basés sur le modèle apprennent ou utilisent un modèle des transitions et des récompenses afin de pouvoir planifier. Les systèmes sans modèle apprennent les valeurs ou les politiques sans modéliser explicitement l’environnement. Les méthodes basées sur le modèle peuvent exploiter l’expérience efficacement, mais les erreurs du modèle appris peuvent induire en erreur la planification.
Apprentissage par renforcement hors ligne
Le RL hors ligne apprend à partir d’un jeu de données fixe plutôt que de collecter de nouvelles interactions pendant l’entraînement. Il peut réduire le coût ou le risque d’exploration, mais l’agent doit éviter de surévaluer les actions mal représentées dans les données.
RLHF et préférences humaines
L’apprentissage par renforcement à partir de retours humains (RLHF) utilise des données de préférence pour entraîner un signal de récompense ou optimiser directement une politique. Il a été utilisé pour aligner le comportement des modèles de langage avec les jugements humains. L’optimisation des préférences n’est pas une garantie de vérité ou de sécurité : les résultats dépendent de qui a fourni les retours, de ce qui leur a été demandé d’évaluer, et de la manière dont l’objectif a été conçu.
Limites
Le RL peut nécessiter un nombre énorme d’interactions, se comporter de manière instable pendant l’entraînement et exploiter des raccourcis non intentionnels dans une fonction de récompense. L’évaluation est difficile car les résultats peuvent varier selon les graines aléatoires et les détails de l’environnement. Les bonnes pratiques incluent plusieurs exécutions, des références transparentes, des objectifs contraints, des tests hors distribution et une surveillance contre le piratage de récompense.
Concevoir un problème de RL: état, action, récompense et horizon
L’apprentissage par renforcement modélise des décisions séquentielles. L’environnement produit une observation, l’agent sélectionne une action selon une politique, et une transition génère une récompense ainsi qu’une observation suivante. Un processus de décision de Markov suppose que l’état contient les informations nécessaires pour prédire les futures transitions et récompenses ; la partialité d’observabilité nécessite une mémoire, un état de croyance ou des représentations récurrentes. L’actualisation contrôle le poids des résultats différés, tandis que les tâches épisodiques et continues exigent des définitions de retour différentes. Une mauvaise conception d’état ou d’action peut rendre un objectif solvable impossible à apprendre.
La conception de la récompense spécifie le comportement de façon indirecte et constitue une source majeure d’échec. Un proxy peut être exploité : un agent récompensé pour la vitesse peut négliger la sécurité, tandis qu’un agent récompensé uniquement à la fin d’une tâche peut recevoir un signal d’apprentissage trop faible. Ajoutez des contraintes et des règles de terminaison basées sur des exigences réelles, testez la sensibilité de la récompense et inspectez les trajectoires pour détecter des stratégies non prévues. Les méthodes d’exploration équilibrent la collecte d’informations avec l’exploitation des connaissances actuelles. Les données hors politique peuvent améliorer l’efficacité d’échantillonnage, mais un décalage entre la politique de comportement et la politique cible nécessite des algorithmes conçus à cet effet.
Évaluation, simulation et déploiement sûr
Les méthodes basées sur la valeur estiment le retour attendu pour les états ou les actions ; les méthodes de gradient de politique optimisent une politique paramétrée ; les méthodes acteur‑critique apprennent les deux. Le RL basé sur le modèle apprend ou utilise la dynamique de transition pour planifier. La famille appropriée dépend du type d’action, des données, de la fidélité du simulateur, de l’horizon et des exigences de stabilité. Comparez avec des références heuristiques, supervisées et de théorie du contrôle. Évaluez le retour moyen et le pire cas, les violations de contraintes, l’efficacité d’échantillonnage, la robustesse aux changements d’environnement et la variance selon les graines plutôt que de choisir une exécution avec la meilleure courbe d’apprentissage.
L’exploration en ligne peut être inacceptable dans les domaines de la santé, de la finance, de la robotique et des infrastructures. Entraînez-vous en simulation ou avec des données enregistrées lorsque cela est possible, quantifiez l’écart simulateur‑réalité, et utilisez l’évaluation hors politique avec précaution car les actions non vues manquent de support. Le déploiement doit limiter les actions, le taux, les ressources et la zone d’opération ; inclure une approbation humaine pour les choix conséquents ; et fournir un contrôleur ou un arrêt d’urgence sûr. Surveillez la récompense en parallèle des résultats réels, car un agent peut améliorer son score tout en nuisant à l’objectif visé. Revalidez après des changements d’environnement, de politique ou de récompense.
Exemple pratique: contrôle énergétique avec apprentissage par renforcement
Un opérateur de bâtiment modélise la température, l’occupation, la météo, l’état des équipements et le prix de l’électricité, les actions étant limitées à des ajustements de consigne sûrs. La récompense combine le confort, l’énergie, les charges de demande et les contraintes d’équipement, mais les violations réelles du confort sont évaluées séparément afin que l’optimisation de la récompense ne puisse masquer les dommages. Le contrôle historique et le contrôle prédictif basé sur modèle fournissent des références. L’entraînement utilise un simulateur calibré avec météo aléatoire, bruit des capteurs et efficacité des équipements.
Avant d’influencer le bâtiment, la politique s’exécute sur des observations en temps réel sans agir. Les ingénieurs inspectent les trajectoires, les marges de contrainte et le comportement pendant les vacances, les vagues de chaleur, les pannes et les capteurs manquants. Le déploiement limite le taux et la portée des actions et conserve le contrôleur de sécurité existant. Un humain peut intervenir à tout moment. La surveillance compare l’énergie et le confort avec des périodes correspondantes, enregistre les interventions et revient en arrière si les violations, les cycles inattendus ou les écarts de modèle dépassent les seuils définis.
Preuves de mise en œuvre et état de préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs prévus, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une référence reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un examinateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la publication, les exceptions, les changements, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez un repli sûr et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, la santé des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, un apprentissage des incidents, des procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Références principales