Fondamentaux de l’IA
Qu’est‑ce que le méta‑apprentissage ?

 Ajouter Unite.AI à vos sources préférées sur Google
Meta-learning entraîne un système sur une distribution de tâches afin qu’il puisse s’adapter à une nouvelle tâche liée en utilisant des données ou une capacité de calcul limitées. On le résume souvent par « apprendre à apprendre », mais l’objectif technique est plus précis: optimiser l’apprenant de sorte que l’expérience acquise sur des tâches antérieures améliore l’adaptation à une tâche ultérieure.
Le méta‑apprentissage chevauche le few-shot learning et le transfer learning, mais les termes ne sont pas interchangeables. Few-shot décrit la quantité de données cibles ; le transfert décrit la réutilisation ; le méta‑apprentissage rend explicitement l’adaptation entre tâches partie intégrante de l’entraînement.
Points clés
- Le méta‑entraînement utilise de nombreuses tâches, pas seulement de nombreux exemples indépendants.
- Un épisode N‑way K‑shot contient N classes et K exemples d’assistance étiquetés par classe.
- Les méthodes basées sur le gradient, sur la métrique, sur la mémoire et les optimiseurs appris s’adaptent de manières différentes.
- Les performances dépendent fortement de la ressemblance entre les tâches de méta‑entraînement et la tâche cible.
Tâches, ensembles de soutien et ensembles de requête
Un jeu de données de méta‑apprentissage est organisé en tâches. Dans la classification few‑shot, un épisode peut être 5‑way 1‑shot : cinq classes, un exemple d’assistance étiqueté par classe, et des exemples de requête supplémentaires utilisés pour évaluer l’adaptation. Une tâche 5‑way 5‑shot possède cinq exemples d’assistance pour chacune des cinq classes — et non pas cinq exemples au total.
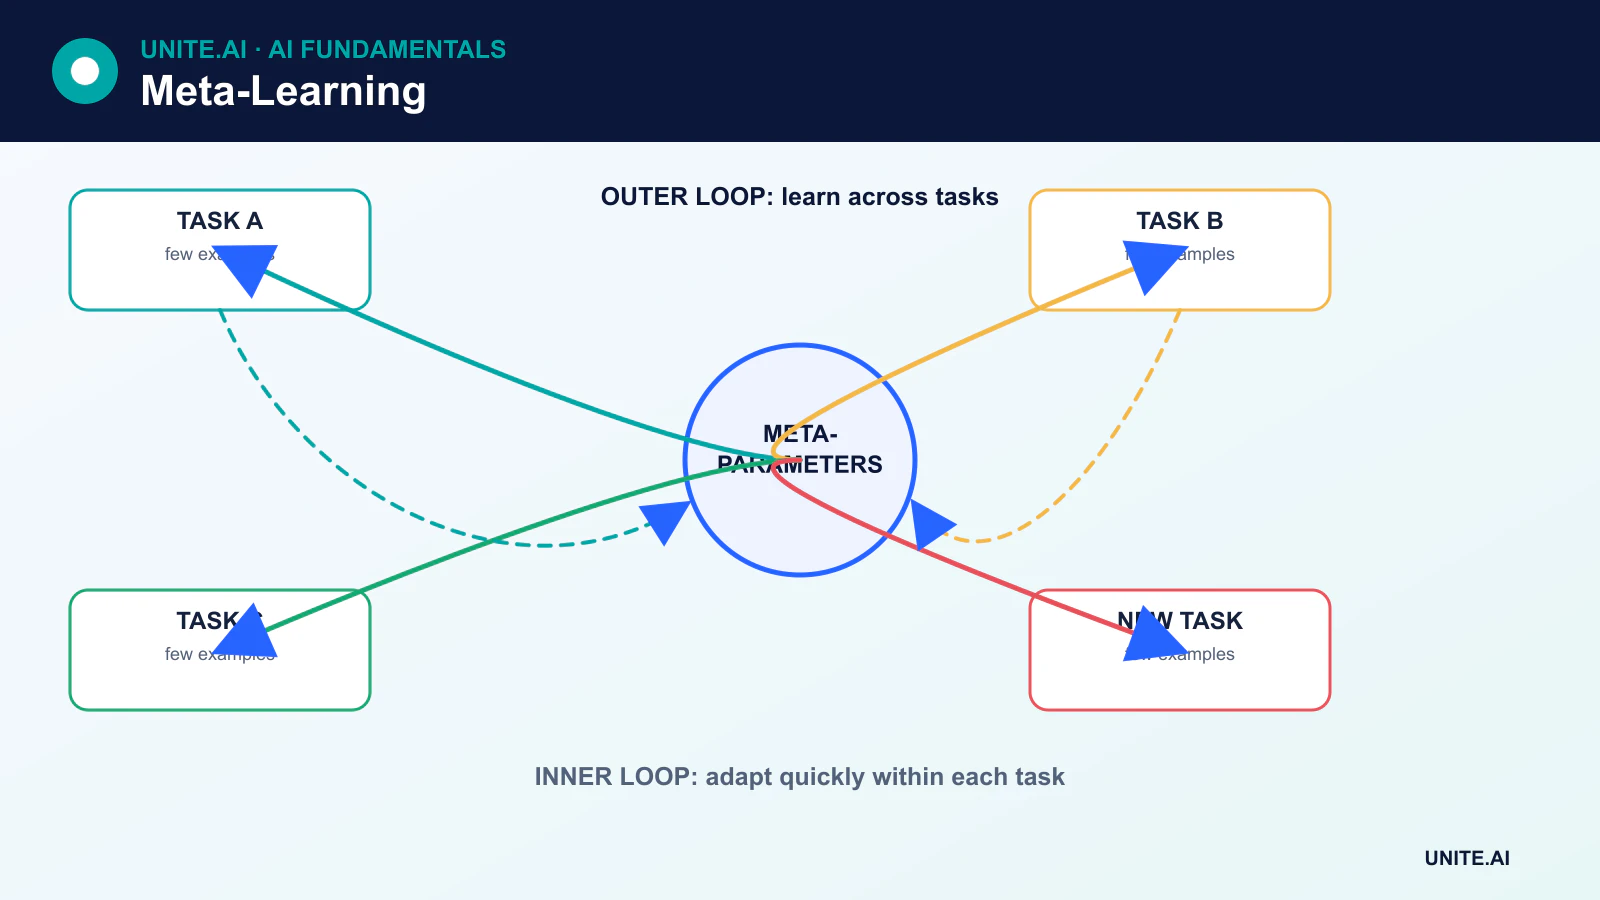
Pendant le méta‑entraînement, l’apprenant s’adapte de façon répétée sur un ensemble de soutien et est évalué sur un ensemble de requête. L’objectif externe améliore les performances futures sur les requêtes à travers les tâches. La méta‑validation ajuste les choix sur des tâches séparées, et le méta‑test évalue des tâches ou des classes réellement inédites.
Méta‑apprentissage basé sur le gradient
Le Model‑Agnostic Meta‑Learning (MAML) apprend une initialisation à partir de laquelle un petit nombre d’étapes de gradient produit de bonnes performances sur une nouvelle tâche. La boucle interne adapte les paramètres du modèle à l’aide des données de soutien. La boucle externe met à jour l’initialisation partagée en utilisant la perte de requête sur les tâches échantillonnées.
MAML n’est pas limité à la classification ; il peut être appliqué à la régression et à l’apprentissage par renforcement lorsque le modèle et la tâche sont différentiables. Reptile propose une approche du premier ordre plus simple qui déplace les paramètres vers des solutions adaptées à la tâche sans calculer le méta‑gradient complet de MAML.
Méta‑apprentissage basé sur la métrique
Les méthodes basées sur la métrique apprennent un espace d’incorporation dans lequel les exemples d’une même classe sont proches et les classes différentes sont séparées. Un réseau prototypique moyenne les incorporations de soutien pour former un prototype par classe, puis classe les requêtes en fonction de la distance à ces prototypes.
Les réseaux de type Matching et Siamese utilisent des mécanismes de similarité associés. Ces méthodes ne se contentent pas de vérifier si un modèle « atteint une métrique cible » ; la distance ou la représentation apprise fait partie intégrante de la procédure de prédiction.
Méthodes basées sur la mémoire et optimiseurs appris
Les systèmes basés sur la mémoire utilisent un état récurrent ou basé sur l’attention pour stocker des informations sur la tâche en cours. Les optimiseurs appris prennent les gradients ou les signaux d’entraînement comme entrées et apprennent comment mettre à jour un autre modèle. Ces méthodes peuvent découvrir des règles d’adaptation, mais elles ajoutent des paramètres, du calcul et un niveau supplémentaire de risque de sur‑apprentissage.
Méta‑apprentissage et apprentissage en contexte
Les grands transformers peuvent adapter leur sortie à partir d’exemples fournis dans une invite sans mettre à jour les poids. Cela s’appelle l’apprentissage en contexte. Il ressemble au comportement du méta‑apprentissage, et les données d’entraînement peuvent encourager l’inférence de tâche, mais un apprenant en contexte n’est pas automatiquement entraîné avec un objectif méta‑apprentissage épisodique classique.
Où le méta‑apprentissage est utile
Parmi les applications potentielles figurent la personnalisation, la robotique, la reconnaissance à faibles ressources, les tâches scientifiques avec peu de mesures, et l’adaptation rapide à de nouveaux environnements. Le méta‑apprentissage est le plus attractif lorsque de nombreuses tâches sources liées sont disponibles mais que les données de la tâche cible sont rares.
Limites
Le méta‑apprentissage peut être coûteux en calcul car l’entraînement imbrique l’adaptation dans l’optimisation. Les résultats sont sensibles à la construction des tâches, aux fuites entre soutien et requête, à l’architecture et au décalage de domaine. Un modèle entraîné sur des tâches étroites et homogènes peut s’adapter mal en dehors de cette distribution.
Les comparaisons devraient inclure les approches classiques de transfert d’apprentissage et les références multitâches. Une représentation pré‑entraînée solide suivie d’un affinement standard peut être plus simple et plus efficace qu’un algorithme de méta‑apprentissage dédié.
Tâches, adaptation et structure d’optimisation interne‑externe
Le méta‑apprentissage s’entraîne sur une distribution de tâches afin qu’un apprenant puisse s’adapter à une nouvelle tâche avec des données ou des mises à jour limitées. Chaque épisode échantillonne une tâche, divise les exemples en un ensemble de soutien utilisé pour l’adaptation et un ensemble de requête utilisé pour l’évaluation, et met à jour les connaissances partagées à travers les épisodes. Les méthodes basées sur la métrique apprennent un espace d’incorporation et une règle de comparaison ; les méthodes basées sur l’optimisation apprennent l’initialisation ou le comportement de mise à jour ; les méthodes basées sur la mémoire et le modèle conditionnent sur les exemples de tâche. La distribution des tâches constitue les véritables données d’entraînement et doit ressembler aux futurs problèmes d’adaptation.
Dans le méta‑apprentissage modèle‑agnostique, une boucle interne adapte les paramètres sur les exemples de soutien et une boucle externe optimise les performances sur les exemples de requête après adaptation. Les gradients d’ordre supérieur peuvent être coûteux ; les approximations du premier ordre échangent fidélité contre coût. Les réseaux prototypiques représentent chaque classe par un centroïde de l’ensemble de soutien et classifient par distance. Ces méthodes supposent que la géométrie des classes, les étapes d’adaptation et la construction des épisodes reflètent le déploiement. Une méthode peut sembler apprendre rapidement tout en exploitant des étiquettes fixes, des artefacts d’acquisition ou un chevauchement entre jeux de données sources.
Évaluation, références et limites du monde réel
Séparer les tâches d’entraînement, de validation et de test — pas seulement les exemples — afin de mesurer l’adaptation à des tâches réellement inédites. Rapporter la précision ou la perte en fonction du nombre de shots et des étapes d’adaptation, les intervalles de confiance à travers les tâches, le calcul, la mémoire et la sensibilité à la composition de l’ensemble de soutien. Comparer avec le transfert d’apprentissage, le fine‑tuning d’un modèle pré‑entraîné, les plus proches voisins, et un modèle entraîné conjointement sur toutes les données sources. De nombreux gains apparents du méta‑apprentissage diminuent lorsque les références reçoivent des architectures, augmentations et réglages équivalents.
Les déploiements réels nécessitent un moyen de reconnaître lorsqu’une nouvelle tâche se situe en dehors de la distribution de méta‑entraînement. Des exemples de soutien pauvres ou mal étiquetés peuvent entraîner un échec rapide et confiant. Limiter l’ampleur des mises à jour, valider les modèles adaptés, conserver une solution de secours et protéger les données d’adaptation contre le poisonnement. Suivre le modèle de base, l’échantillonneur de tâches, les graines d’épisode et le code d’adaptation. Le méta‑apprentissage est utile pour des familles récurrentes de problèmes à petite donnée, mais il ne crée pas une capacité d’apprentissage générale à partir d’exemples arbitraires et ne supprime pas le besoin d’évaluations spécifiques au domaine.
Exemple pratique: adaptation few‑shot entre machines
Un fabricant considère chaque type de machine comme une tâche et méta‑entraîne une représentation d’anomalie sur de nombreuses machines avec des résultats de maintenance vérifiés. Les machines de test sont entièrement exclues de l’entraînement des tâches. Pour une nouvelle machine, un petit ensemble de soutien couvre les modes de fonctionnement normaux plutôt que des minutes de données arbitraires. Le méta‑apprentissage est comparé à un encodeur pré‑entraîné gelé, aux plus proches voisins et au fine‑tuning ordinaire en utilisant les mêmes exemples de soutien et la même capacité de calcul.
L’évaluation répète de nombreuses sélections de soutien et rapporte le rappel d’événements, les fausses alarmes, le temps d’adaptation et la variance. Le système s’abstient lorsque l’ensemble de capteurs ou la dynamique de la nouvelle machine se situent en dehors de la distribution des tâches. Les mises à jour d’adaptation sont limitées et examinées avant d’influencer la maintenance. Les étiquettes de soutien et l’identité de la machine sont protégées contre le poisonnement, et chaque modèle adapté conserve sa version de base et ses exemples. Une adaptation rapide n’est acceptée que si elle surpasse de façon constante le transfert plus simple dans un décalage de tâche réaliste.
Preuves d’implémentation et disponibilité opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définir les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établir une ligne de base reproductible et un jeu d’évaluation versionné avant l’ajustement. Tester les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, le décalage de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurer la qualité des tâches conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Consigner chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuer l’autorité pour la mise en production, les exceptions, les modifications, le retour en arrière et la mise hors service. Utiliser un déploiement progressif, conserver une solution de secours sûre et vérifier la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définir les seuils d’alerte et le responsable de la réponse, puis examiner les preuves du monde réel après le déploiement plutôt que de supposer que les performances hors ligne persisteront. Réévaluer chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, un apprentissage des incidents, des procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Questions fréquemment posées
Le prompting few‑shot est‑il du méta‑apprentissage ?
Le prompting few‑shot est une technique d’adaptation en contexte. Il peut afficher un comportement associé à l’apprentissage à travers les tâches, mais il n’est pas automatiquement entraîné avec des épisodes de soutien/requête ou une boucle méta‑optimisation explicite.
Quel est le principal risque du méta‑apprentissage ?
Un décalage entre les tâches de méta‑entraînement et la tâche cible peut faire paraître l’adaptation rapide très performante dans un benchmark, mais échouer en production. Les découpages de tâches et la provenance des sources doivent être audités avec autant de rigueur que les découpages train/test classiques.
Références principales