
Fondamentaux de l’IA
Qu’est‑ce qu’un KNN (K‑Nearest Neighbors) ?

 Ajouter Unite.AI à vos sources préférées sur Google
K‑nearest neighbors (KNN) prédit un résultat à partir des exemples d’entraînement étiquetés les plus proches d’un point de requête. Pour la classification, les voisins votent pour la classe. Pour la régression, leurs valeurs cibles sont moyennées ou combinées d’une autre façon.
KNN est une méthode basée sur les instances, non généralisante: l’ajustement consiste principalement à stocker les exemples d’entraînement et un index de recherche optionnel. Cela n’élimine pas la nécessité de divisions entraînement, validation et test. L’évaluation sur des données réservées est essentielle pour choisir k, la métrique de distance, le traitement des caractéristiques et la règle de vote.
Points clés
- KNN prédit localement ; il ne divise pas d’abord le jeu de données en clusters.
- Le redimensionnement des caractéristiques est crucial car la distance définit quels exemples comptent comme voisins.
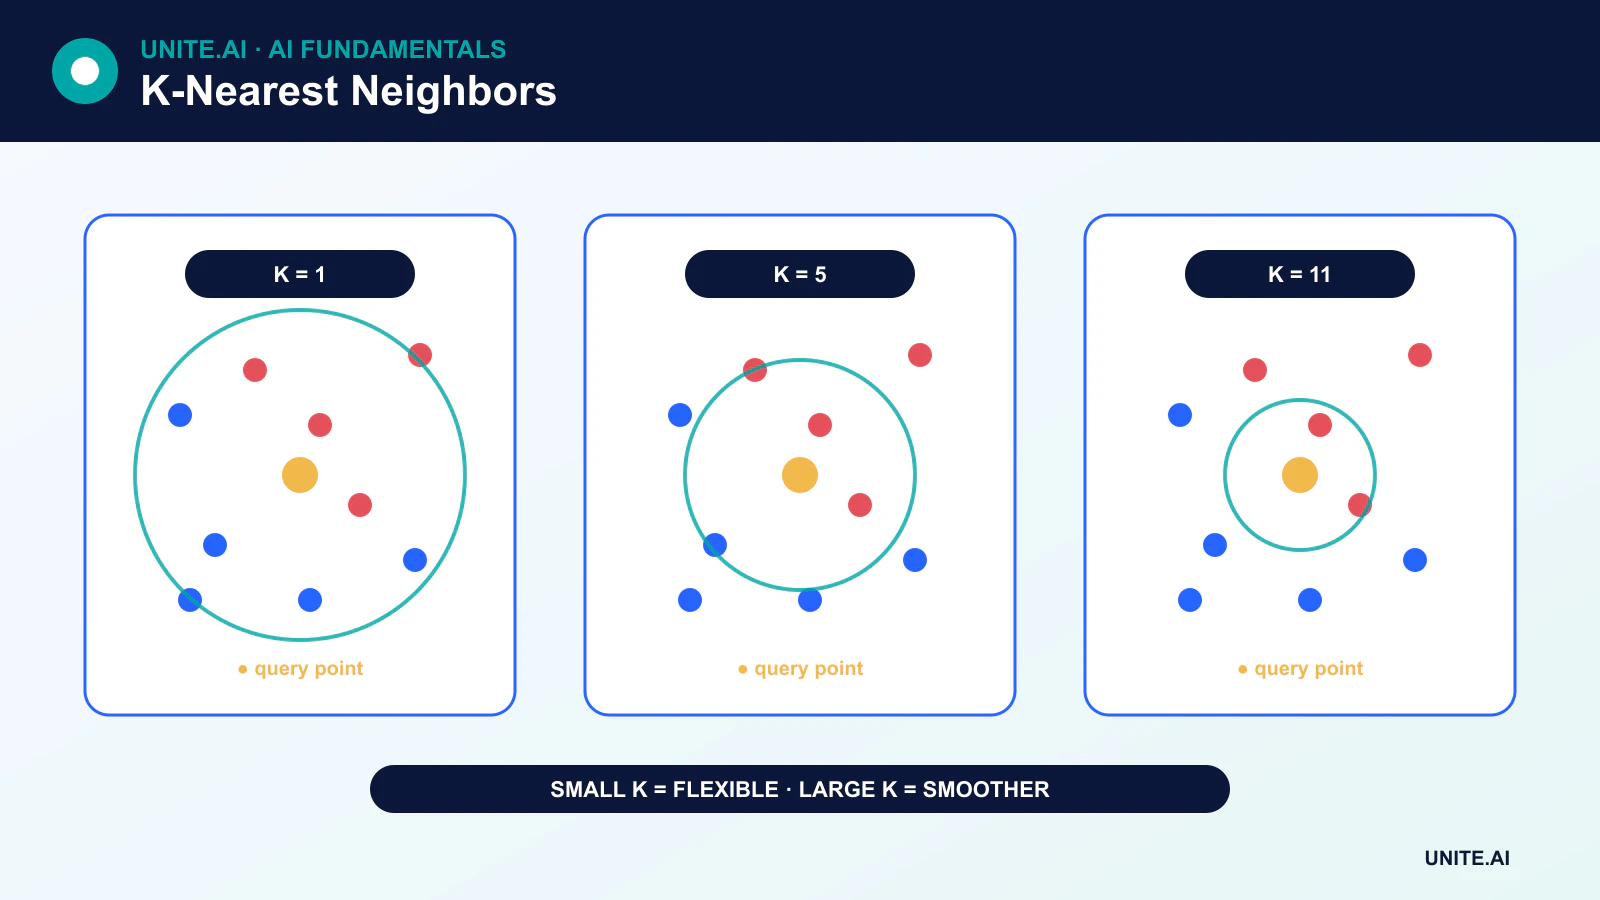
- Un petit k peut être bruyant, tandis qu’un grand k peut lisser la structure locale.
- Les hautes dimensions, les caractéristiques non pertinentes, le déséquilibre des classes et la recherche lente peuvent limiter les performances.
Comment fonctionne la classification KNN
- Représenter la requête et les exemples d’entraînement dans le même espace de caractéristiques.
- Calculer la distance entre la requête et les exemples d’entraînement.
- Sélectionner les k exemples les plus proches.
- Prédire la classe majoritaire ou utiliser un vote pondéré par la distance.
Le vote pondéré accorde plus d’influence aux voisins les plus proches. Les égalités nécessitent une règle documentée, et des voisins à distance égale avec des étiquettes différentes peuvent rendre les résultats dépendants de l’ordre ou des détails d’implémentation.
Régression KNN
Pour la régression, la prédiction est généralement la moyenne des cibles voisines. Le pondération par la distance peut réduire l’influence des observations plus éloignées. La médiane ou une agrégation robuste peut être utile lorsque les cibles locales contiennent des valeurs aberrantes.
Métriques de distance
La distance euclidienne est courante pour les caractéristiques continues, la distance de Manhattan somme les différences absolues, et la distance cosinus se concentre sur la direction plutôt que sur la magnitude. D’autres métriques s’appliquent aux données binaires, catégorielles, géographiques, séquentielles ou aux embeddings appris.
Qualifier KNN de « non paramétrique » signifie qu’il ne suppose pas de forme fonctionnelle fixe de dimension finie pour la frontière de décision. Il suppose toutefois que la représentation et la métrique choisies rendent les points proches pertinents les uns pour les autres.
Pourquoi l’échelle est importante
Si une caractéristique varie de 0 à 1 et une autre de 0 à 100 000, la distance euclidienne ordinaire sera dominée par la seconde caractéristique. La standardisation, la normalisation ou des transformations spécifiques au domaine doivent être ajustées sur la partition d’entraînement et appliquées aux données de validation, de test et de production.
Les caractéristiques non pertinentes déforment également les voisinages. La sélection de caractéristiques, la réduction de dimension ou les représentations apprises peuvent aider, mais chaque choix doit être validé sans fuite de données.
Choisir k
Avec k = 1, le modèle peut suivre le bruit et les exemples mal étiquetés. À mesure que k augmente, les prédictions deviennent plus lisses et moins sensibles à un point unique. Si k devient trop grand, les classes ou régions lointaines dominent et le modèle sous‑ajuste.
Choisissez k par validation croisée sur les données d’entraînement. Pour la classification binaire, un k impair réduit mais n’élimine pas les égalités. Les poids de classe, les découpages stratifiés, le choix du seuil et les métriques appropriées sont importants lorsque les classes sont déséquilibrées.
La malédiction de la dimensionnalité
Dans les espaces de haute dimension, les distances peuvent devenir moins informatives car les exemples sont rares et les distances les plus proches et les plus lointaines deviennent relativement similaires. KNN peut nécessiter d’énormes quantités de données pour maintenir des voisinages locaux significatifs. C’est ce que l’on appelle la malédiction de la dimensionnalité.
La réduction de dimensionnalité ou des embeddings spécifiques à la tâche peuvent aider, mais la géométrie d’un embedding doit être validée pour la notion de similarité visée.
Performance de recherche
Une requête par force brute compare le nouveau point avec chaque exemple stocké. Les arbres KD et les ball trees accélèrent certaines recherches exactes, bien que leurs avantages diminuent en haute dimension. Les index de voisins approximatifs échangent une petite perte de rappel contre d’importants gains de vitesse et de mémoire. Cette idée sous-tend également la recherche de similarité vectorielle.
Points forts et limites
KNN est simple, prend en charge des frontières de décision irrégulières et fournit une explication intuitive basée sur des exemples. Il peut également nécessiter une mémoire importante, exposer des exemples d’entraînement sensibles, prédire lentement et se comporter mal lorsque la distance n’est pas pertinente. C’est une base utile — mais pas une méthode qui est très précise par défaut sur la plupart des problèmes.
Distance, voisinages et comportement des hyperparamètres
K‑nearest neighbors stocke les exemples d’entraînement et prédit à partir des k plus proches selon une distance choisie. La classification utilise un vote majoritaire ou pondéré par la distance ; la régression moyenne les cibles des voisins. L’échelle est essentielle car une caractéristique à grande amplitude peut dominer la distance euclidienne. Les données catégorielles, clairsemées, séquentielles ou géographiques peuvent nécessiter des distances de Hamming, cosinus, d’édition, de grand cercle ou apprises. La métrique constitue une hypothèse de modélisation de la similarité et doit être validée par rapport à la signification réelle des cas proches.
Un petit k crée des frontières flexibles, à haute variance, et une sensibilité au bruit ; un grand k lisse les prédictions et peut effacer la structure des minorités. Un k impair évite seulement certaines égalités binaires et n’est pas une règle générale. Choisissez k, la distance, le pondération, l’ensemble de caractéristiques et le prétraitement dans le cadre de la validation croisée. Le déséquilibre des classes peut faire en sorte que le vote majoritaire local ignore les issues rares, il faut donc inspecter le rappel par classe et la composition du voisinage. Les distances en haute dimension tendent à se concentrer, et les caractéristiques non pertinentes détériorent les voisinages ; la sélection, la réduction de dimension ou les embeddings appris peuvent aider.
Indexation, incertitude et exploitation en production
L’inférence naïve compare une requête avec chaque point d’entraînement. Les arbres KD et les ball trees aident dans les basses dimensions appropriées ; les index de voisins approximatifs échangent l’exactitude contre la vitesse et l’échelle. Mesurez le rappel de la recherche de voisins séparément de la qualité prédictive. La mémoire comprend les caractéristiques stockées, les étiquettes et les structures d’index. Les mises à jour sont conceptuellement simples mais peuvent nécessiter la reconstruction d’index, la cohérence des versions et la propagation des suppressions. Protégez les exemples d’entraînement sensibles car le renvoi de voisins ou de distances peut exposer des enregistrements.
KNN peut mettre en avant des exemples qui rendent une prédiction compréhensible, mais la proximité n’est ni une cause ni une garantie d’équité. Fournissez la distance, la marge de vote et une règle d’abstention lorsque les voisinages sont rares ou conflictuels. Surveillez la distance de requête, les étiquettes des voisins, la dérive des caractéristiques, la latence et les résultats confirmés. Gardez les versions de prétraitement et d’index synchronisées, et testez les résultats exacts versus approximatifs après chaque modification. KNN est une base locale efficace et une méthode de récupération lorsque la distance a du sens ; il rencontre des difficultés lorsque la similarité ne peut être représentée par les caractéristiques disponibles.
Exemple pratique : KNN pour la substitution de produits
Un détaillant représente les produits avec des attributs numériques standardisés, une compatibilité catégorique et un embedding texte appris, puis définit une distance pondérée évaluée par les responsables merchandising. K et les poids sont sélectionnés à l’aide de lancements de produits ultérieurs, et non de lignes d’articles aléatoires. L’évaluation vérifie le rappel des substituts pertinents, les recommandations incompatibles, la distance, la couverture des catégories et les résultats pour les articles rares. Une base de popularité montre si la similarité locale apporte de la valeur.
Un index approximatif est comparé aux voisins exacts en termes de rappel et de latence. Les requêtes sans article compatible proche ne renvoient aucune suggestion plutôt qu’un voisin forcé. Les suppressions de produits et les corrections d’attributs se propagent à l’index via des mises à jour versionnées. La surveillance suit les distributions de distance, les résultats vides, les substitutions et les résultats commerciaux sans confondre les ventes avec la véritable compatibilité. Les termes sensibles des fournisseurs sont exclus des explications, et les exemples renvoyés restent une preuve de similarité — et non une affirmation que les produits sont équivalents.
Preuves d’implémentation et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un examinateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise à jour, les exceptions, les modifications, les retours en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sûre et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, l’apprentissage des incidents, les procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
KNN possède-t‑il une phase d’entraînement ?
Il nécessite peu d’ajustement de paramètres, mais il possède tout de même un processus de développement: le prétraitement est appris à partir des données d’entraînement, un index peut être construit, et k, la métrique, les poids et les caractéristiques sont sélectionnés lors de la validation.
KNN est‑il identique à K‑means ?
Non. KNN est principalement une méthode de prédiction locale supervisée. K‑means est un algorithme de regroupement non supervisé dans lequel K représente le nombre de centres de clusters.
Références principales












