
Fondamentaux de l’IA
Qu’est-ce que les opérations informatiques (ITOps) ?

 Ajouter Unite.AI à vos sources préférées sur Google
IT operations (ITOps) désigne le travail de gestion des services technologiques dont dépend une organisation. Il englobe le calcul, les réseaux, l’identité, les points de terminaison, les plateformes cloud, les bases de données, le stockage, les sauvegardes et les processus opérationnels qui assurent la disponibilité, la sécurité et la prise en charge de ces composants.
Les ITOps modernes ne se limitent pas à un centre d’opérations réseau surveillant des tableaux de bord. Les équipes gèrent de plus en plus une infrastructure définie par logiciel, des services de plateforme, l’automatisation et une responsabilité distribuée tout en conservant la responsabilité des incidents, de la capacité, de la continuité et des niveaux de service.
Points clés
- ITOps gère les services et leurs dépendances dans les environnements sur site, cloud et périphérie.
- L’observabilité, la configuration et l’inventaire fournissent le contexte nécessaire pour interpréter les pannes.
- La gestion des incidents restaure le service ; la gestion des problèmes traite les causes récurrentes ou systémiques.
- ITOps chevauche ITSM, SRE, DevOps, SecOps et AIOps mais n’est identique à aucun d’eux.
Services, actifs et configuration
Les opérations commencent par connaître les services existants, leurs propriétaires, les utilisateurs qui en dépendent et l’infrastructure qui les prend en charge. L’inventaire des actifs répertorie les composants ; la gestion de la configuration enregistre les relations pertinentes et l’état contrôlé.
Un inventaire qui n’est jamais réconcilié devient trompeur. Automatisez la découverte lorsqu’elle est utile, identifiez les sources autoritaires et consignez la confiance ou la fraîcheur au lieu de prétendre que chaque carte de dépendance est complète.
Observabilité et objectifs de service
Les métriques quantifient le comportement, les journaux enregistrent les événements et les traces suivent le travail à travers les services. Les contrôles synthétiques peuvent tester un parcours utilisateur. Une observabilité utile commence par des questions et des objectifs de service, puis collecte les signaux nécessaires pour y répondre.
Les alertes doivent identifier les conditions nécessitant une action rapide. Des seuils sans impact utilisateur génèrent du bruit, tandis qu’un manque de contexte de dépendance ralentit le diagnostic. AIOps peut aider à la corrélation, mais il a besoin de télémétrie fiable et de retours opérationnels.
Gestion des incidents, des problèmes et des changements
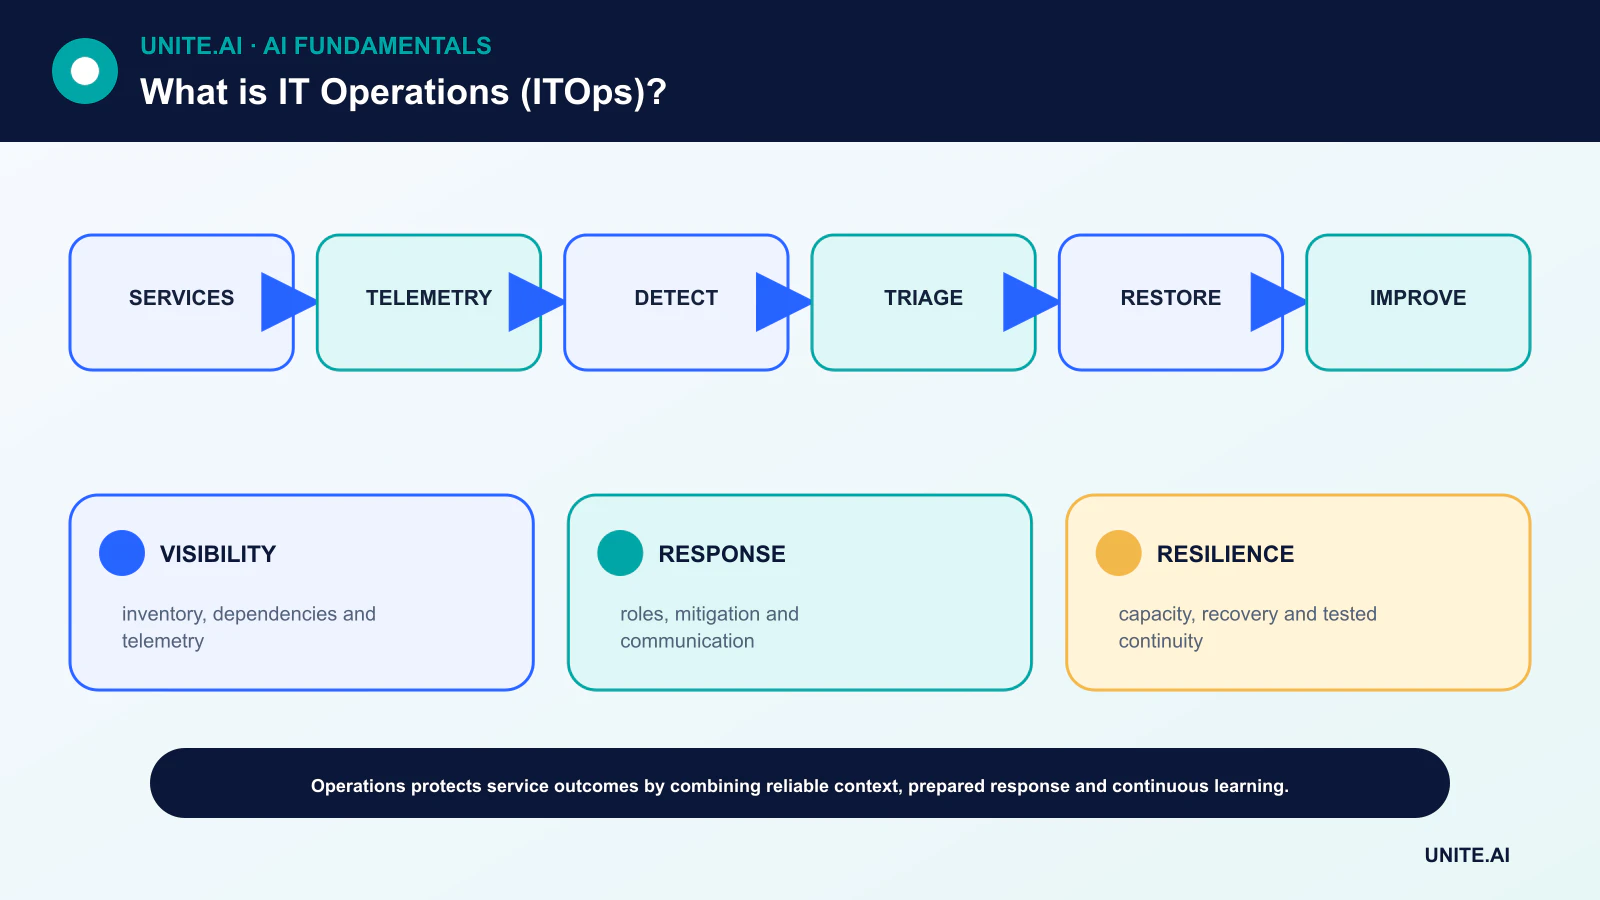
La gestion des incidents coordonne la détection, le triage, l’atténuation, la communication et la récupération. Des rôles clairs réduisent la confusion sous pression. Une solution de contournement temporaire peut restaurer le service tandis qu’une enquête ultérieure sur le problème traite les causes plus profondes.
La gestion des changements évalue et consigne les risques sans transformer chaque modification en file d’attente. Les changements standards, automatisés et à faible risque peuvent suivre des chemins préapprouvés ; les changements à fort impact nécessitent des preuves plus solides, une planification et une préparation du retour en arrière.
Capacité, résilience et continuité
Les équipes prévoient la demande de ressources, éliminent les goulets d’étranglement et testent le comportement sous charge. Les sauvegardes ne sont utiles que lorsque la restauration est testée. La redondance n’aide que lorsque les modes de défaillance sont indépendants et que le basculement fonctionne réellement.
La continuité des activités définit les priorités, le temps de récupération et la perte de données acceptable. Les dépendances à l’identité, au DNS, aux plans de contrôle du cloud et aux fournisseurs doivent être incluses dans les exercices plutôt que supposées disponibles.
ITOps, ITSM, SRE et DevOps
La gestion des services informatiques fournit des processus pour aligner les services sur les besoins de l’organisation. L’ingénierie de fiabilité des sites applique le génie logiciel aux opérations et utilise des objectifs de niveau de service et des budgets d’erreur. DevOps réunit les retours du développement et des opérations.
SecOps se concentre sur les menaces et les réponses, tandis qu’ITOps assure la santé globale des services. Les organigrammes diffèrent ; l’exigence importante est une propriété explicite et des preuves partagées entre ces disciplines.
Le modèle opérationnel ITOps
Les opérations informatiques maintiennent les services technologiques de l’organisation disponibles, performants, sécurisés et récupérables. Le périmètre comprend généralement les points de terminaison, l’identité, les réseaux, les serveurs, le cloud, le stockage, la collaboration, les bases de données, la surveillance, le service d’assistance, les sauvegardes et les services fournisseurs. Les ITOps modernes couvrent l’infrastructure détenue et les plateformes gérées, de sorte que la responsabilité doit être explicite même lorsque l’opération est externalisée. Un inventaire de configuration ou de services relie les composants techniques aux propriétaires, aux utilisateurs, aux dépendances, à la classification des données et à la criticité métier.
La gestion des services organise les incidents, les demandes, les problèmes, les changements, les actifs, les connaissances et les niveaux de service. La gestion des incidents restaure le service ; la gestion des problèmes enquête sur les causes récurrentes ; la mise en œuvre des changements évalue et coordonne le risque. Considérer chaque changement comme une approbation lente crée des contournements, tandis que l’automatisation non gouvernée engendre des défaillances incontrôlées. Les changements standards à faible risque peuvent être préautorisés et automatisés ; les changements à haut risque nécessitent des preuves, une communication, un retour en arrière et une planification en fonction de l’impact.
Fiabilité, capacité et continuité
La surveillance doit suivre les services orientés utilisateur et leurs dépendances, pas seulement le nombre d’appareils. Définissez les objectifs de disponibilité, de latence, de capacité, de fraîcheur et de support avec les responsables métier. Alertez sur les symptômes exploitables et la consommation du budget d’erreur ; enrichissez les événements avec la propriété et les changements récents. Les modèles de planification de capacité prennent en compte la demande, la saturation, les licences et les délais. L’élasticité du cloud réduit le délai de provisionnement mais n’élimine pas les quotas, les limites régionales ou le contrôle des coûts.
La continuité des activités nécessite des sauvegardes testées, la restauration, la récupération d’identité, des alternatives réseau, des contacts fournisseurs et des procédures manuelles. Définissez les objectifs de temps de récupération et de point de récupération par service. Une sauvegarde n’est pas une preuve de récupération tant qu’elle n’est pas restaurée et validée. Entraînez les scénarios de ransomware, de perte de région, de certificats expirés, de panne d’identité et de défaillance d’un fournisseur. Suivez la configuration et l’infrastructure en tant que code lorsque cela est possible afin que la récupération soit reproductible.
Sécurité, automatisation et métriques
Utilisez le principe du moindre privilège, la gestion des correctifs et des vulnérabilités, les contrôles des points de terminaison, la segmentation réseau, la journalisation et la réponse aux incidents. Automatisez les tâches répétitives avec idempotence, limites, approbations et audit. Mesurez la disponibilité du service, la récurrence des incidents, la satisfaction des demandes, les échecs de changement, la récupération, l’exposition aux correctifs, la capacité, le coût et la satisfaction des utilisateurs — pas seulement la clôture des tickets. ITOps réussit lorsque la technologie soutient le travail de manière prévisible et peut récupérer d’une défaillance, et non lorsque l’infrastructure semble occupée ou que les tableaux de bord affichent davantage d’indicateurs verts.
Exemple pratique : récupération d’un service de collaboration
Une entreprise définit un objectif de temps de récupération de quatre heures et un objectif de point de récupération d’une heure pour une plateforme de collaboration. Elle inventorie l’identité, le DNS, le réseau, les données, les clés, la configuration, les intégrations et les dépendances fournisseurs. Un exercice de récupération suppose que la région principale et le compte administrateur sont indisponibles. Les opérateurs activent une identité d’urgence protégée de façon indépendante, restaurent la configuration du service et les données dans une région isolée, puis valident les autorisations, les messages, les intégrations et l’accès client. Les responsables métier vérifient le service restauré à l’aide de parcours utilisateurs réalistes plutôt qu’en se fiant uniquement aux contrôles de santé de l’infrastructure.
L’exercice consigne la perte de données réelle, le temps écoulé, les étapes manuelles, les contacts échoués et les dépendances cachées. Une sauvegarde qui restaure les fichiers mais pas les clés de chiffrement ou la politique d’identité est jugée incomplète. Les actions correctives sont assignées à des propriétaires avec des dates, et le guide d’exécution est mis à jour et retesté. Des modèles de surveillance et de communication sont inclus. L’organisation mesure les preuves de récupération plutôt que le succès du job de sauvegarde, en reconnaissant que des ITOps fiables doivent restaurer le service dont les utilisateurs ont besoin dans des conditions de panne réalistes.
Preuves de mise en œuvre et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement opérationnel, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base de référence reproductible et un ensemble d’évaluations versionnées avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendance, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité des tâches conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Consignez chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise en production, les exceptions, les changements, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de repli sûre et vérifiez la surveillance avec des pannes intentionnellement injectées. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, la santé des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et un responsable de réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage des incidents, de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
Quel est l’objectif principal d’ITOps ?
Fournir et restaurer des services technologiques fiables dans le respect des contraintes de sécurité, de performance, de continuité et de coûts convenues.
L’infrastructure cloud est‑elle entièrement gérée par le fournisseur ?
Non. Les fournisseurs gèrent des parties de la plateforme sous‑jacente, tandis que les clients restent responsables de la configuration, de l’identité, des données, des charges de travail, de la surveillance et de nombreuses décisions liées aux niveaux de service.
Références principales












