
Fondamentaux de l’IA
Qu’est‑ce que l’automatisation des incidents ? Flux de travail, garde‑fous et cas d’utilisation

 Ajouter Unite.AI à vos sources préférées sur Google
L’automatisation des incidents utilise des logiciels pour détecter, enrichir, acheminer, coordonner et parfois remédier aux incidents opérationnels ou de sécurité. Elle relie les signaux de surveillance aux runbooks, à la gestion des tickets, à la communication, aux contrôles d’accès et aux actions de récupération, de sorte que les intervenants passent moins de temps à copier des données et plus de temps à prendre des décisions.
L’automatisation n’est pas la suppression de la responsabilité humaine. Un programme sûr distingue les étapes déterministes à faible risque des actions pouvant affecter les clients ou la production, puis applique des approbations, des identifiants limités, des traces d’audit, des délais d’attente et des retours en arrière en fonction de l’impact.
Points clés
- Automatisez la collecte d’évidences répétable avant d’essayer une remédiation autonome.
- Utilisez la gravité, la confiance, le rayon d’impact et la réversibilité pour choisir le niveau d’approbation.
- Traitez chaque runbook comme du code de production versionné, avec des tests et un propriétaire.
- Mesurez la détection, la prise de connaissance, la récupération, la récurrence et l’impact utilisateur — pas seulement le volume d’alertes.
Du signal à la réponse coordonnée
Un flux de travail peut dédupliquer les alertes, joindre les déploiements et journaux récents, identifier le propriétaire du service, ouvrir un enregistrement d’incident, alerter l’équipe de garde, créer un canal de communication et démarrer une chronologie. Ces étapes réduisent la charge cognitive sans poser automatiquement un diagnostic risqué.
La corrélation doit préserver les preuves. Si une plateforme regroupe les symptômes de façon trop agressive, elle peut masquer des incidents simultanés. Reliez l’automatisation à la propriété des opérations IT et conservez les signaux bruts dont les intervenants pourraient avoir besoin.
Choisir les actions selon le risque
Les requêtes en lecture seule, les instantanés et les basculements de trafic réversibles sont généralement plus faciles à automatiser que la suppression de données, la rotation d’identifiants étendus ou la modification d’un schéma de production. Définissez les préconditions, un délai d’exécution, les postconditions et un retour en arrière pour chaque action.
Utilisez des identités de service au principe du moindre privilège et séparez l’autorisation du moteur de flux de travail. Les étapes à fort impact doivent nécessiter un approbateur identifié. Si AIOps propose une cause ou une solution, les intervenants ont toujours besoin de preuves à l’appui et d’un moyen sûr de la rejeter.
Construire des runbooks fiables
Un runbook doit déclarer les entrées, les dépendances, le propriétaire, le périmètre, le comportement en cas d’échec et les preuves générées. Testez-le en préproduction et lors de journées d’entraînement. Les étapes idempotentes sont précieuses car les réessayer ne crée pas de dommages supplémentaires.
Versionnez et révisez l’automatisation comme tout autre logiciel. Surveillez l’expiration des identifiants, les changements d’API, les limites de débit, les exécutions partielles et les couplages cachés entre services. Les procédures manuelles restent nécessaires lorsque la plateforme d’automatisation elle‑même est indisponible.
Apprendre après la récupération
L’automatisation doit conserver un enregistrement horodaté des signaux, décisions, actions, approbations et résultats. Un examen sans blâme peut alors séparer les conditions systémiques contributives du déclencheur final et transformer les leçons en améliorations testées.
Les mesures utiles incluent le temps moyen de prise de connaissance et de restauration, le pourcentage d’étapes sûres automatisées, le taux d’échecs d’actions, les incidents récurrents et l’impact client. Reliez les constats à la planification DevOps plutôt que d’optimiser le nombre de tickets clôturés.
Types d’automatisation des incidents
L’automatisation des événements normalise et enrichit les signaux entrants. L’automatisation de la coordination crée un enregistrement d’incident, alerte les propriétaires, ouvre des canaux de communication et publie des mises à jour de statut. L’automatisation diagnostique exécute des requêtes en lecture seule ou capture des instantanés. L’automatisation de la remédiation modifie l’état du système, tandis que l’automatisation de la récupération vérifie la santé du service et ferme les mesures d’atténuation temporaires.
Ces catégories ne doivent pas partager un même niveau de confiance par défaut. L’enrichissement peut souvent s’exécuter automatiquement ; un basculement de production peut nécessiter des vérifications de confiance et un approbateur ; la restauration de données nécessite généralement un commandant d’incident et le propriétaire de l’application. Le contrôle doit suivre l’impact potentiel, et non la façon dont l’étape est implémentée (règle ou modèle d’apprentissage automatique).
Les incidents de sécurité ajoutent des exigences de préservation des preuves. L’automatisation doit éviter de modifier un hôte compromis avant la capture des données volatiles, d’exposer des indicateurs sensibles dans des canaux publics, ou de mettre en quarantaine une infrastructure partagée sans comprendre le rayon d’impact. Les runbooks opérationnels et forensiques peuvent se chevaucher, mais leur ordre peut différer.
Conception du flux de travail et plan de contrôle
Modélisez le runbook comme des états explicites avec des préconditions et des résultats finaux. Chaque action doit signaler son démarrage, sa réussite, son échec, son expiration ou son omission, ainsi qu’un identifiant d’exécution immuable. Un orchestrateur central peut coordonner les étapes, mais les services en aval doivent appliquer leur propre autorisation et valider les entrées de façon indépendante.
Utilisez des identifiants à portée limitée et à courte durée de vie et restreignez les chemins réseau depuis le moteur d’automatisation. Séparez les exécutants de développement, de test et de production. Les secrets ne doivent pas apparaître dans les transcriptions de chat ou les journaux. Pour les actions à fort impact, exigez une approbation à deux personnes ou un rôle d’urgence dont l’utilisation crée immédiatement une trace de révision.
Concevez pour les échecs partiels. Un ticket peut être créé tandis que l’alerte échoue ; un basculement de trafic peut réussir dans une région et expirer dans une autre. Les actions compensatoires, les tâches de réconciliation et une responsabilité claire empêchent le flux de travail de déclarer un succès simplement parce que le processus d’orchestration s’est terminé.
Exemples, tests et maturité
Un cas d’utilisation mature initial est l’épuisement des connexions à une base de données : collecter les métriques du pool, les déploiements récents, les requêtes lentes et les informations du propriétaire ; ouvrir un incident ; proposer une mise à l’échelle ou une action de trafic réversible ; exiger une approbation ; puis vérifier le taux d’erreur et la latence. Le même schéma peut servir à l’expiration de certificats, à la pression disque, aux jobs échoués ou à une activité de compte suspecte.
Testez les runbooks à l’aide de tests unitaires, d’API simulées, d’incidents en préproduction, de journées d’entraînement et d’exercices contrôlés en production. Injectez des données obsolètes, des refus d’autorisation, des dépendances lentes, des événements dupliqués et des incidents conflictuels. Confirmez que les nouvelles tentatives sont sûres et que les intervenants peuvent prendre le contrôle manuel sans combattre l’automatisation.
La maturité progresse de la notification, à l’enrichissement, aux actions guidées, puis à l’auto‑remédiation limitée. L’avancement doit dépendre des preuves : diagnostic stable, faible taux d’échecs d’actions, retour en arrière vérifié et bénéfice utilisateur clair. La clôture autonome doit rester rare tant que le système ne peut pas prouver la récupération et conserver suffisamment de preuves pour un apprentissage ultérieur.
Exemple détaillé: automatisation d’un incident de service en production
Considérez une API de paiement dont le taux d’erreur augmente après un déploiement. La surveillance émet une alerte structurée contenant le service, l’environnement, la région, la version, le budget d’erreur et le lien du runbook. L’automatisation l’enrichit avec le registre de changement, l’état des dépendances, les journaux récents et la propriété, puis regroupe les alertes dupliquées en un incident. Une politique déterministe peut suspendre immédiatement tout nouveau déploiement ; un retour en arrière doit nécessiter des preuves que la nouvelle version est la cause et que le rollback est sûr.
Le flux de travail désigne un commandant d’incident, ouvre des canaux de communication, consigne une chronologie et propose des étapes de diagnostic. La remédiation automatisée débute par des actions réversibles à faible risque, comme le basculement du trafic vers une instance saine. Chaque action nécessite une autorisation, des limites de concurrence, un délai d’attente, des post‑conditions vérifiées et un retour en arrière. Des résumés génératifs peuvent aider les intervenants, mais la télémétrie et les commandes sources restent visibles afin que l’équipe puisse contester un récit erroné.
Mesurez le temps de détection, de prise de connaissance, d’atténuation et de récupération ; le volume d’alertes ; la suppression des duplicatas ; le succès de la remédiation ; la récurrence ; et les dommages causés par l’automatisation. Organisez des journées d’entraînement pour les identifiants expirés, les régions partielles, les alertes trompeuses et les retours en arrière échoués. Après la récupération, conservez la chronologie factuelle, identifiez les conditions techniques et organisationnelles contributives, mettez à jour les runbooks et les tests, et suivez le travail correctif jusqu’à son achèvement plutôt que de considérer une atténuation rapide comme la fin du travail de fiabilité.
Liste de contrôle de mise en œuvre pratique
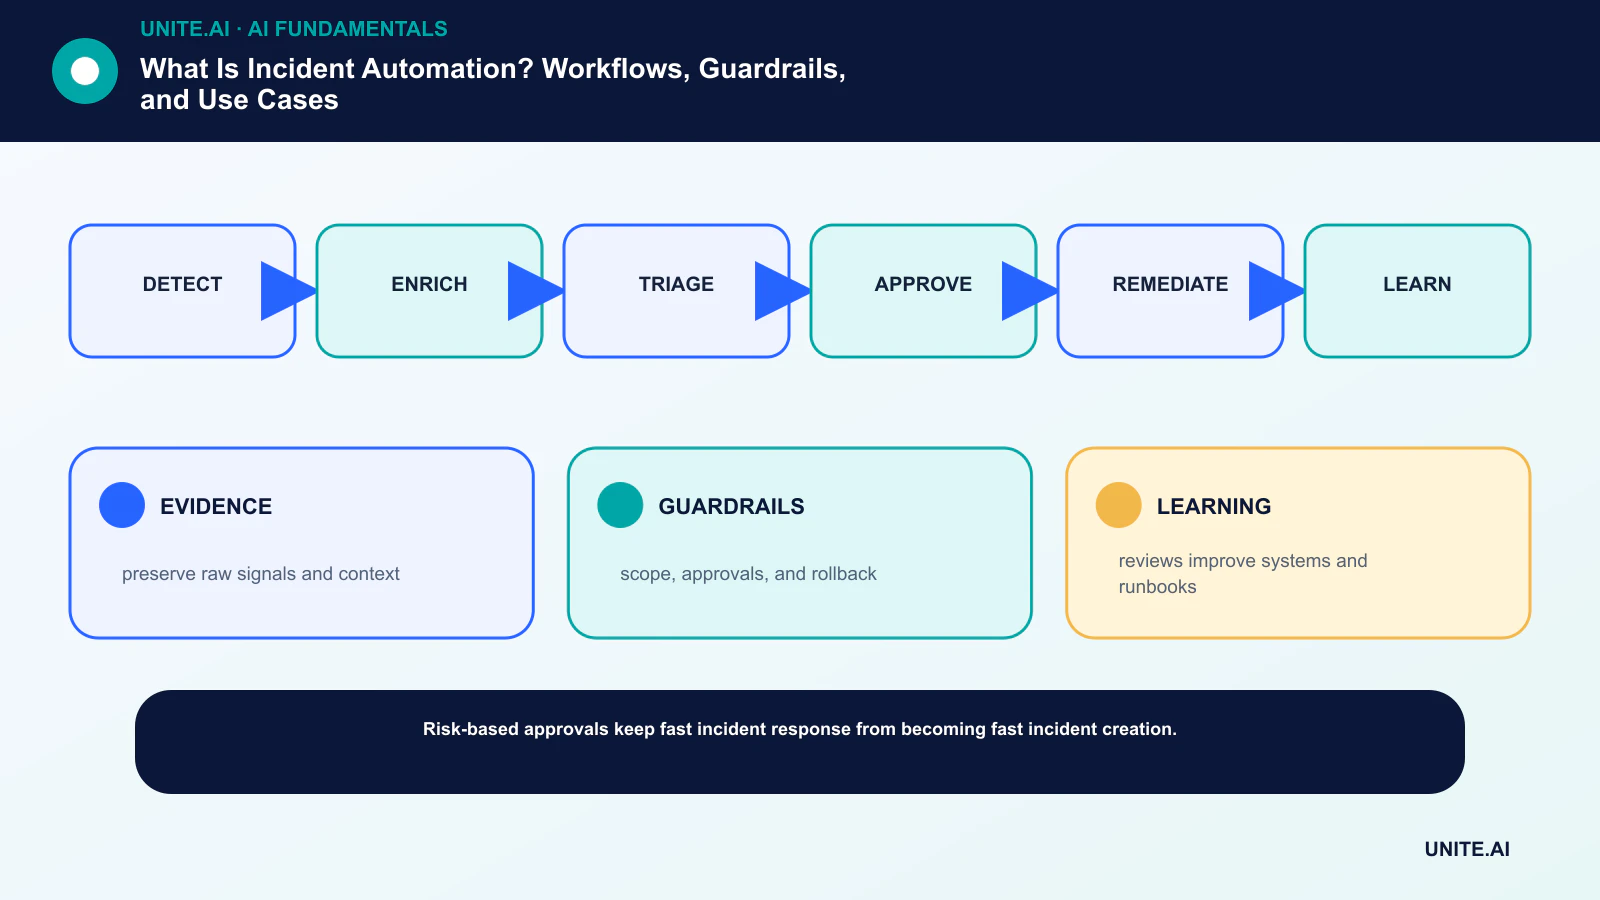
Transformez le concept en un flux de travail limité et testable : détecter → enrichir → trier → approuver → remédier → apprendre. Désignez un propriétaire responsable, documentez les données et dépendances, établissez une base simple, définissez les critères d’acceptation et d’arrêt, testez des échecs représentatifs et définissez la surveillance, le retour en arrière et la révision avant d’élargir le périmètre. Enregistrez les versions et les hypothèses afin qu’une autre équipe puisse reproduire le résultat et comprendre ce qui a changé.
Avant le lancement, effectuez une revue de préparation documentée avec les personnes qui conçoivent, exploitent, sécurisent et sont affectées par le système. Testez les cas normaux, les conditions limites, les défaillances de dépendances et les usages abusifs ; conservez les preuves et les risques non résolus. Définissez qui peut approuver une version, modifier un seuil, outrepasser une sortie ou arrêter l’opération. Reconsidérez la décision une fois les données du monde réel disponibles, car un pilote techniquement réussi ne garantit pas des performances fiables à plus grande échelle.
- ÉVIDENCE: conserver les signaux bruts et le contexte.
- GARDES‑FOU: périmètre, approbations et retour en arrière.
- APPRENTISSAGE: les revues améliorent les systèmes et les runbooks.
Questions fréquemment posées
L’automatisation des incidents est‑elle identique à l’AIOps ?
Non. L’AIOps applique des analyses ou de l’apprentissage automatique aux données d’opérations. L’automatisation des incidents est la couche d’exécution et de coordination plus large ; elle peut utiliser des règles simples, les sorties d’AIOps ou les deux.
Qu’est‑ce qui doit être automatisé en premier ?
Commencez par des étapes à haute fréquence, à faible risque et bien comprises, telles que l’enrichissement, la recherche du propriétaire, la capture de preuves, les mises à jour de statut et les diagnostics réversibles.
Références principales











